#time complexity #big o notation #algorithm analysis #data structures #competitive programming #binary search #coding tips #computer science basics #programming for beginners #optimization
তোমার কোড কি "স্মার্ট" নাকি শুধু "কাজ করে"? Time Complexity বোঝার সহজ গাইড
2026-08-31 · 21 min read
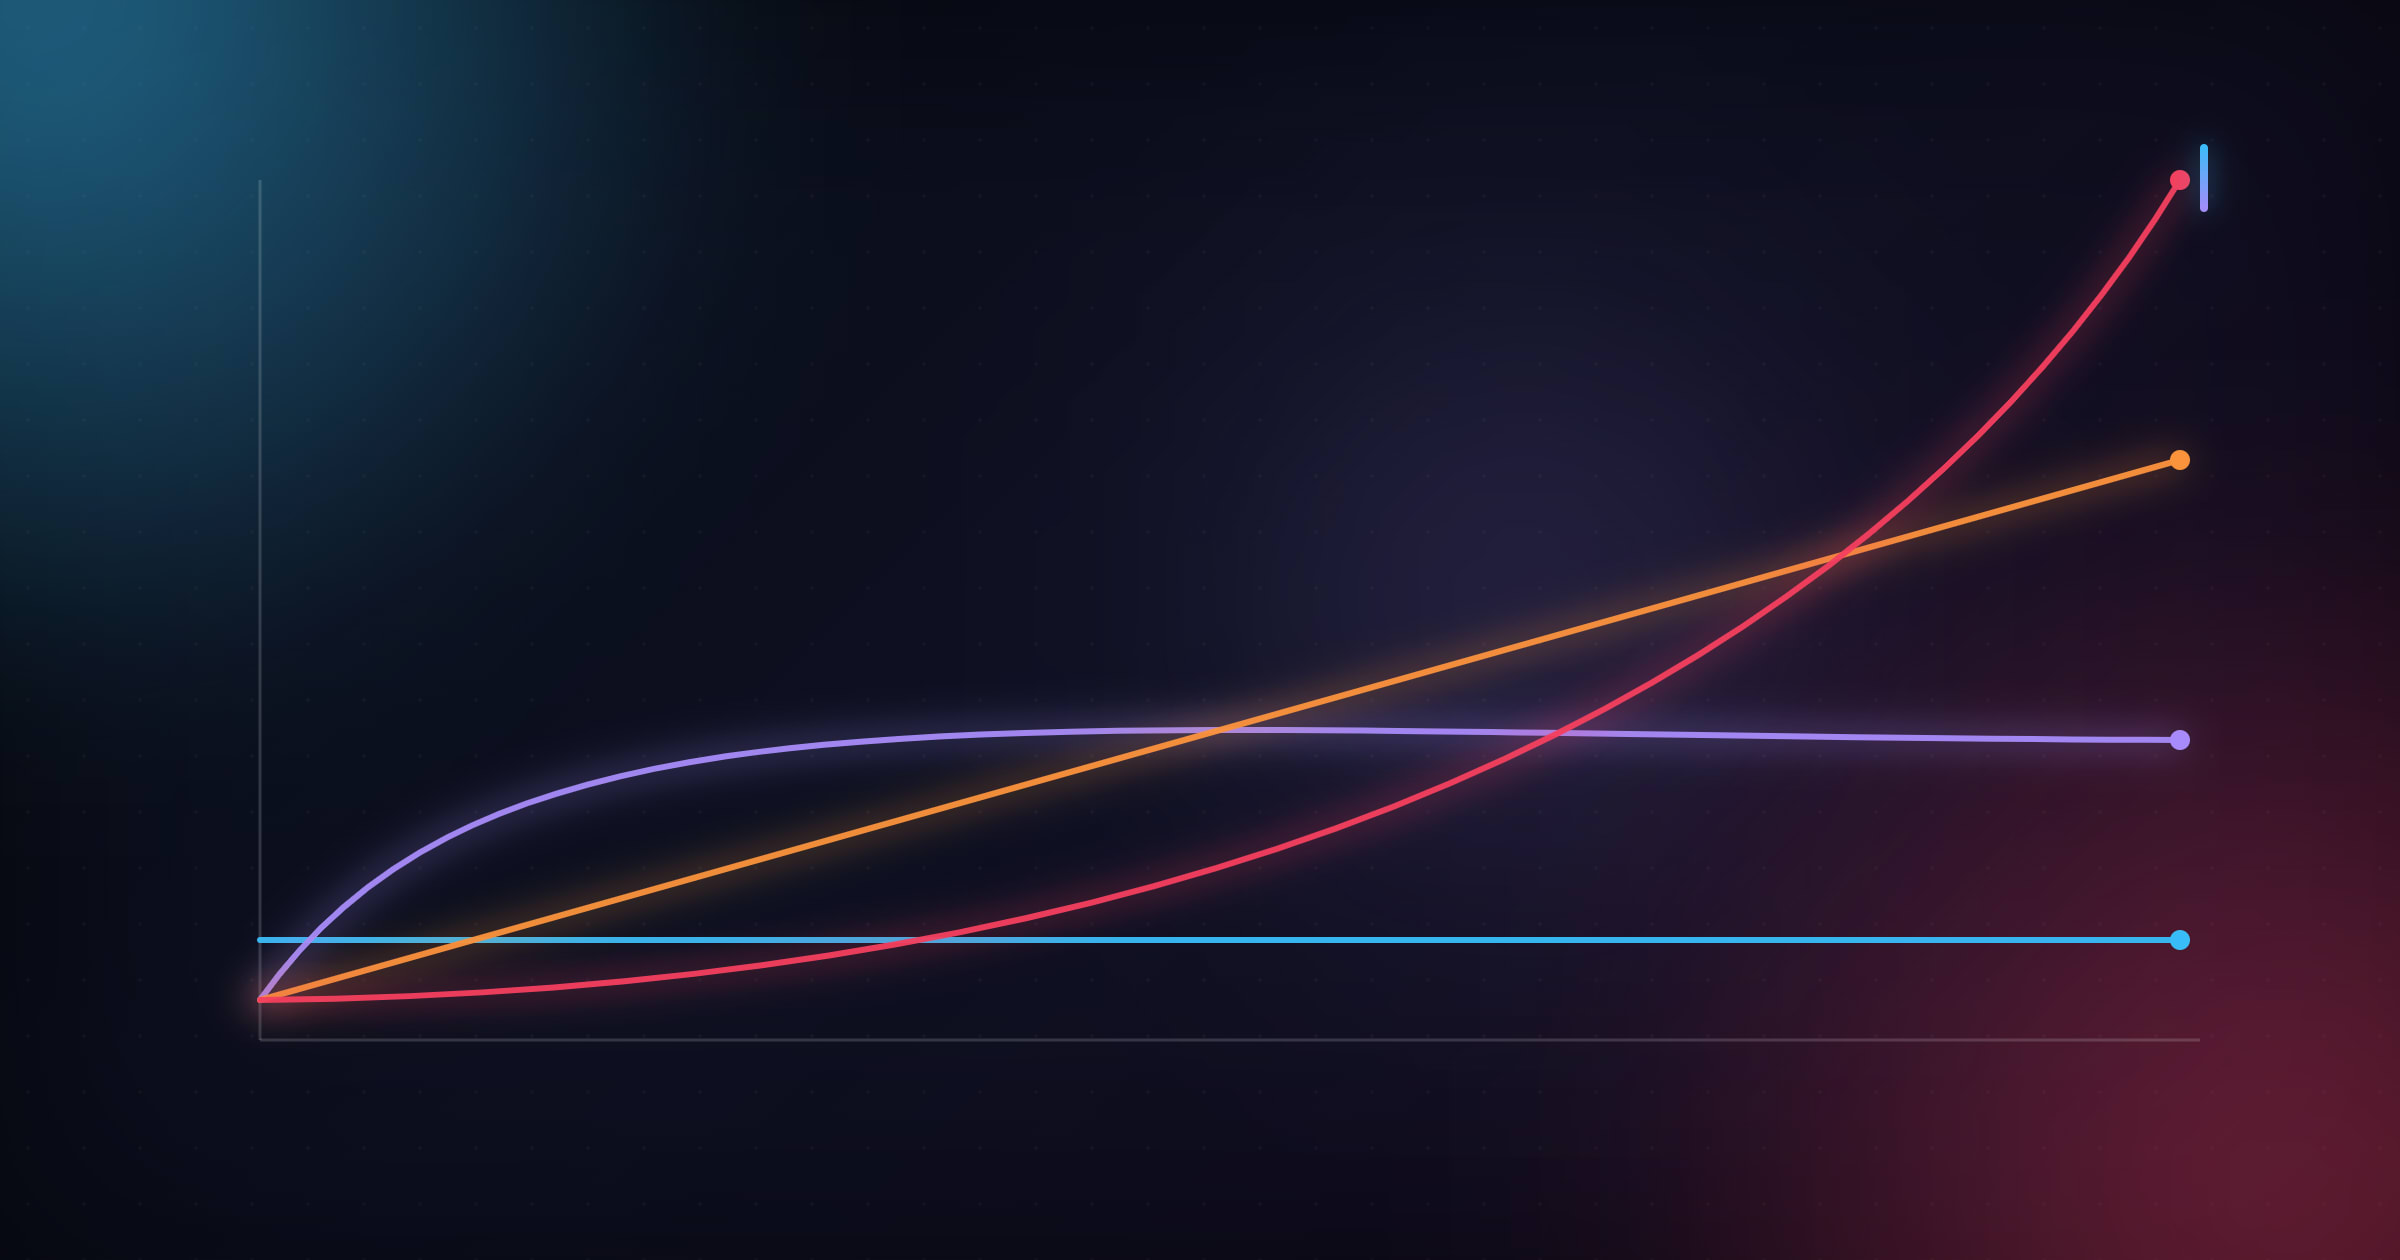
ধরো, তুমি একটা প্রবলেম সলভ করলে। কোড রান করালে, আউটপুট ঠিকঠাক এলো। মনটা খুশিতে ভরে গেলো। "সলভড!" কিন্তু জাজ বলছে TLE (Time Limit Exceeded)। মেজাজ খারাপ হওয়ার এই মুহূর্তটা প্রায় প্রতিটা প্রোগ্রামারের জীবনে অন্তত একবার আসে। আর এর পেছনের ভিলেনের নাম Time Complexity।
এই জিনিসটা না বুঝলে কী হয়? তুমি এমন একটা অ্যালগোরিদম লিখবে যেটা তোমার ল্যাপটপে ছোট ইনপুটে ফটাফট চলে, কিন্তু বড় ইনপুট বা প্রোডাকশনে গিয়ে ঘণ্টার পর ঘণ্টা ঝুলে থাকে। আজকের এই গাইডে আমরা একদম বেসিক থেকে শুরু করে বুঝব কমপ্লেক্সিটি আসলে কী, কীভাবে হিসাব করতে হয়, আর কনটেস্ট বা রিয়েল লাইফে এটা কীভাবে কাজে লাগে।
কমপ্লেক্সিটি জিনিসটা আসলে কী?
কোনো অ্যালগোরিদম লেখার আগে নিজেকে তিনটা প্রশ্ন করা উচিত:
- নির্ধারিত সময়ের মধ্যে এটা ফলাফল দিবে তো?
- সর্বোচ্চ কত বড় ইনপুট এটা সামলাতে পারবে?
- কতটুকু মেমরি খরচ করছে?
প্রথম দুইটার উত্তর দেয় Time Complexity, শেষেরটা Space Complexity। আর এটা প্রকাশ করার নোটেশনটার নাম Big O।
এখানে একটা কমন ভুল ধারণা ভাঙা দরকার। Big O কিন্তু স্টপওয়াচ না। এটা তোমার প্রসেসরের স্পিড, RAM, বা ইন্টারনেট কানেকশনের সাথে সম্পর্কিত না। এটা শুধু বলে দেয়, ইনপুট সাইজ বাড়লে তোমার অ্যালগোরিদমের কাজের পরিমাণ কী হারে বাড়ে। ধরো দুইটা মেশিন। একটা সুপারকম্পিউটার, একটা পুরনো ল্যাপটপ। দুটোতেই যদি O(n²) অ্যালগোরিদম চালাও, ইনপুট ১০ গুণ বাড়লে দুই মেশিনেই কাজের পরিমাণ প্রায় ১০০ গুণ বেড়ে যাবে। স্পিড আলাদা, কিন্তু প্যাটার্ন একই। এটাই Big O-র আসল শক্তি। এটা একটা রিলেটিভ স্কেল, কনক্রিট টাইম না।
O(1): যেখানে ইনপুট যাই হোক, কাজ একই
int constantTimeExample(int n) {
    int x = n + 10;
    x = x / 2;
    return x;
}
n যত বড়ই হোক এখানে সবসময় একটা যোগ আর একটা ভাগ। ইনপুট ১০ হোক বা ১০ কোটি, কাজের পরিমাণ একই। এটাকে বলা হয় O(1) বা কনস্ট্যান্ট টাইম।
মজার তথ্য: array-এর কোনো index-এ পৌঁছানো (arr[5]), বা hash map-এ একটা key খোঁজা এগুলোও (গড়ে) O(1)। এই জন্যই যেকোনো সিস্টেম ডিজাইনে hash map এত জনপ্রিয়।
O(n): ইনপুটের সাথে সমান তালে বাড়া
int linearTimeExample(int n) {
    int sum = 0;
    for (int i = 1; i <= n; i++) {
        sum += i;
        if (sum >= 1000) break;
    }
    return sum;
}
এখানে break দেখে ভাবতে পারো "আরে, এটা তো মাঝপথেই থেমে যেতে পারে, তাহলে কমপ্লেক্সিটি কম হওয়া উচিত না?" যুক্তিটা খারাপ না, কিন্তু প্রোগ্রামাররা সবসময় worst case নিয়ে কাজ করে। মানে "সবচেয়ে খারাপ পরিস্থিতিতে সর্বোচ্চ কতবার লুপ চলতে পারে।" এখানে worst case-এ লুপ পুরো n বারই চলবে (sum যদি কখনো ১০০০ না ছোঁয়)। তাই কমপ্লেক্সিটি O(n)।
O(n²): নেস্টেড লুপের ফাঁদ
int quadraticTimeExample(int n) {
    int sum = 0;
    for (int i = 1; i <= n; i++) {
        for (int j = i; j <= n; j++) {
            sum += (i + j);
        }
    }
    return sum;
}
এখানে ভেতরের লুপ প্রথমবার চলে n বার, দ্বিতীয়বার n-1 বার, এভাবে কমতে কমতে শেষবার ১ বার। মোট চলার সংখ্যা হলো:
n + (n−1) + (n−2) + … + 1 = n(n+1) / 2
এটা একটা ক্লাসিক arithmetic series। যদি ভুলে গিয়ে থাকো, মনে করার সহজ ট্রিক: প্রথম আর শেষ টার্ম যোগ করলে সবসময় (n+1) পাও (n + 1, বা (n−1) + 2, ইত্যাদি), আর এরকম জোড়া আছে n/2 টা। তাই টোটাল = n(n+1)/2। এটাকে ছড়িয়ে লিখলে হয় (n² + n) / 2।
এখন প্রশ্ন হলো এই ২ দিয়ে ভাগ, বা যোগ হওয়া n এগুলোর কী হবে? কমপ্লেক্সিটি হিসাবে আমরা শুধু সবচেয়ে দ্রুত বাড়া টার্মটা রাখি আর বাকি সব (কনস্ট্যান্ট মাল্টিপ্লায়ার, ছোট টার্ম) ফেলে দিই। কারণ n যখন অনেক বড় হয় (ধরো ১০ লাখ), তখন n² এর তুলনায় শুধু n টার্মটা এত নগণ্য যে হিসাবে কোনো তফাত আনে না। তাই ফলাফল দাঁড়ায় O(n²)।
O(log n): বাইনারি সার্চের জাদু
int binarySearch(int n, int val[], int key) {
    int low = 1, high = n;
    while (low <= high) {
        int mid = (low + high) / 2;
        if (key < val[mid]) high = mid - 1;
        else if (key > val[mid]) low = mid + 1;
        else return 1;
    }
    return 0;
}
এখানেই সবচেয়ে সুন্দর জিনিসটা ঘটে। প্রতি ধাপে আমরা সার্চ স্পেসটাকে অর্ধেক করে ফেলি। প্রশ্ন হতে পারে "একটা সংখ্যাকে বারবার ২ দিয়ে ভাগ করলে সেটা সর্বোচ্চ কতবার ভাগ করা যায়?" উত্তরটা বোঝার সহজ উপায়: n = ১০২৪ থেকে শুরু করো। ৫১২, ২৫৬, ১২৮, ৬৪, ৩২, ১৬, ৮, ৪, ২, ১; মাত্র ১০ ধাপে পৌঁছে গেলাম! আর ১০২৪ = ২¹⁰। তাই যতবার ভাগ করলে ১-এ পৌঁছাবে, সেটাই হলো log₂(n)। ফোনবুক থেকে একটা নাম খোঁজার কথা ভাবো। পুরো বই থেকে একটা একটা করে পাতা উল্টানোর বদলে, মাঝখান থেকে শুরু করে বারবার অর্ধেক বাদ দিতে দিতে খুঁজলে কয়েক সেকেন্ডেই পেয়ে যাবে। ১০ লাখ এন্ট্রিতেও লাগবে মাত্র ২০ ধাপ! এই জন্যই O(log n) কে বলা হয় সবচেয়ে "সস্তা" গ্রোথ রেটগুলোর একটা।

একাধিক টার্ম একসাথে থাকলে?
ধরো তোমার অ্যালগোরিদমে কাজের পরিমাণ n⁴ + n³ + log(n)। এখানে যত n বড় হবে, n⁴ বাকি সবাইকে এতটাই ছাড়িয়ে যাবে যে বাকিরা কার্যত অদৃশ্য হয়ে যাবে। তাই ফাইনাল কমপ্লেক্সিটি শুধু O(n⁴)।
কিছু কমন উদাহরণ:
- n² + 3n + 112 → O(n²)
- n³ + 999n + 112 → O(n³)
- 6·log(n) + n·log(n) → O(n log n)
- 2ⁿ + n² + 100 → O(2ⁿ) — এক্সপোনেনশিয়াল, সবচেয়ে ভয়ংকর গ্রোথ রেটগুলোর একটা।
রিকার্শনেরও কমপ্লেক্সিটি হয়
int factorial(int n) {
    if (n == 1) return 1;
    return n * factorial(n - 1);
}
এই ফাংশন নিজেকে কল করে যতক্ষণ না n == 1 হয়। কতবার কল হবে? সর্বোচ্চ n বার। তাই এর কমপ্লেক্সিটিও O(n) — লুপ না থাকলেও।
নতুনদের সবচেয়ে কমন ভুল
int countA(char *s) {
    int c = 0;
    for (int i = 0; i < strlen(s); i++) {
        if (s[i] == 'a') c++;
    }
    return c;
}
দেখতে নিরীহ লাগছে, তাই না? কিন্তু এখানে একটা লুকানো বোমা আছে। strlen(s) নিজেই একটা O(|s|) অপারেশন — পুরো স্ট্রিং ঘুরে length বের করে। আর এখানে সেটাকে লুপের কন্ডিশনে বসানো হয়েছে, মানে প্রতিটা iteration-এ এটা আবার নতুন করে calculate হচ্ছে! ফলে টোটাল কমপ্লেক্সিটি দাঁড়ায় O(|s|²), যেখানে হওয়া উচিত ছিল O(|s|)।
ফিক্স খুবই সহজ:
int countA(char *s) {
    int c = 0;
    int len = strlen(s); // একবারই ক্যালকুলেট করো
    for (int i = 0; i < len; i++) {
        if (s[i] == 'a') c++;
    }
    return c;
}
এই এক লাইনের বাগ কত প্রোডাকশন সিস্টেমকে যে ধীর করে দিয়েছে, তার হিসাব নেই। Python-এ len() কল বা JavaScript-এ .length নিয়েও একই সতর্কতা কাজে লাগে।
কনটেস্ট আর রিয়েল লাইফে এটা কীভাবে কাজে লাগে?
এখন আসল প্রশ্ন। জাজ বা সার্ভার আসলে কতটা কাজ "সহ্য" করতে পারে? মোটামুটি একটা সাধারণ থাম্ব-রুল হলো, আধুনিক একটা প্রসেসর প্রতি সেকেন্ডে গড়ে প্রায় ১০⁸ (১০ কোটি) ইনস্ট্রাকশন হ্যান্ডেল করতে পারে (ভাষা আর অপারেশনভেদে এটা কম-বেশি হয়)। তাই ইনপুট সাইজ দেখেই অনেক সময় আন্দাজ করা যায়, কোন কমপ্লেক্সিটির অ্যালগোরিদম দরকার:
- n ≈ ১০০ → O(n³) পর্যন্ত চলবে
- n ≈ ১০⁴–১০⁵ → O(n log n) বা O(n√n) দরকার
- n ≈ ১০⁸ → O(n) বা O(log n) ছাড়া গতি নেই
এখানে একটা জিনিস প্রায়ই গুলিয়ে ফেলা হয় "প্রোগ্রাম x সেকেন্ডে শেষ হলো" বলাটা কি কমপ্লেক্সিটির সাথে একই জিনিস? উত্তর: না, পুরোপুরি না। "x সেকেন্ড" হলো wall-clock time, এটা তোমার নির্দিষ্ট মেশিনে, নির্দিষ্ট ইনপুটে, একটা নির্দিষ্ট মুহূর্তে মাপা রিয়েল-ওয়ার্ল্ড সময়, যেটা হার্ডওয়্যার, কম্পাইলার, এমনকি সেই মুহূর্তে মেশিনে আর কী কী চলছে তার উপরও নির্ভর করে। আর Big O হলো একটা থিওরেটিক্যাল পরিমাপ। ইনপুট সাইজ বাড়লে কাজ কীভাবে স্কেল করে, তার একটা mathematical প্রেডিকশন। দুটো সম্পর্কযুক্ত ঠিকই (কমপ্লেক্সিটি বেশি হলে সাধারণত রানটাইমও বেশি লাগে), কিন্তু একটা আরেকটার বদলি নয়। তাই TLE খেলে শুধু "এটা তো দ্রুতই চলছিল" ভেবে হতাশ হয়ো না। কমপ্লেক্সিটিটা আবার হিসাব করে দেখো।
আরেকটা জায়গায় নতুনরা প্রায়ই ধরা খায়, টেস্ট কেসের সংখ্যা ভুলে যাওয়া। ধরো একটা প্রবলেমে ১০০টা টেস্ট কেস আছে, আর প্রতিটায় ইনপুট সাইজ ৫০। তোমার অ্যালগোরিদম প্রতি টেস্ট কেসে O(n), মানে ৫০ ইউনিট কাজ। কিন্তু জাজ তো একবারে ১০০টা টেস্ট কেসই রান করবে, তাই না? তাহলে টোটাল কাজ হলো ১০০ × ৫০ = ৫,০০০ ইউনিট, শুধু ৫০ না! Time limit সবসময় পুরো প্রোগ্রামের জন্য দেওয়া থাকে, একটা টেস্ট কেসের জন্য না। এই হিসাবটা বাদ দিলেই "আমার অ্যালগোরিদম তো ঠিকই আছে, তাও TLE কেন?" এই প্রশ্নের জন্ম হয়।
শেষ কথা
Time complexity বোঝা মানে শুধু কনটেস্টে ভালো করা না। এটা তোমাকে এমন কোড লিখতে শেখায় যেটা স্কেল করে। আজকে ১০০ ইউজারের জন্য যে কোড ঠিকঠাক চলছে, কাল ১০ লাখ ইউজারে গিয়ে সেটাই তোমার সিস্টেমকে হাঁটু গেড়ে বসিয়ে দিতে পারে। যদি না তুমি শুরু থেকেই কমপ্লেক্সিটি নিয়ে সচেতন থাকো। পরের বার কোনো লুপ লেখার আগে, একবার থেমে নিজেকে জিজ্ঞেস করো। "n বড় হলে এটা কী হারে বাড়বে?" এই একটা অভ্যাসই তোমাকে বাকি ৯০% প্রোগ্রামারের চেয়ে এগিয়ে রাখবে।