#lsm tree #database #backend engineering #wal #memtable #sstable #compaction #bloom filter #rocksdb #cassandra #nosql #storage engine #database internals #software engineering
LSM Tree কী? WAL, MemTable, SSTable, Compaction ও Bloom Filter সহজ ভাষায়
2026-09-18 · 17 min read
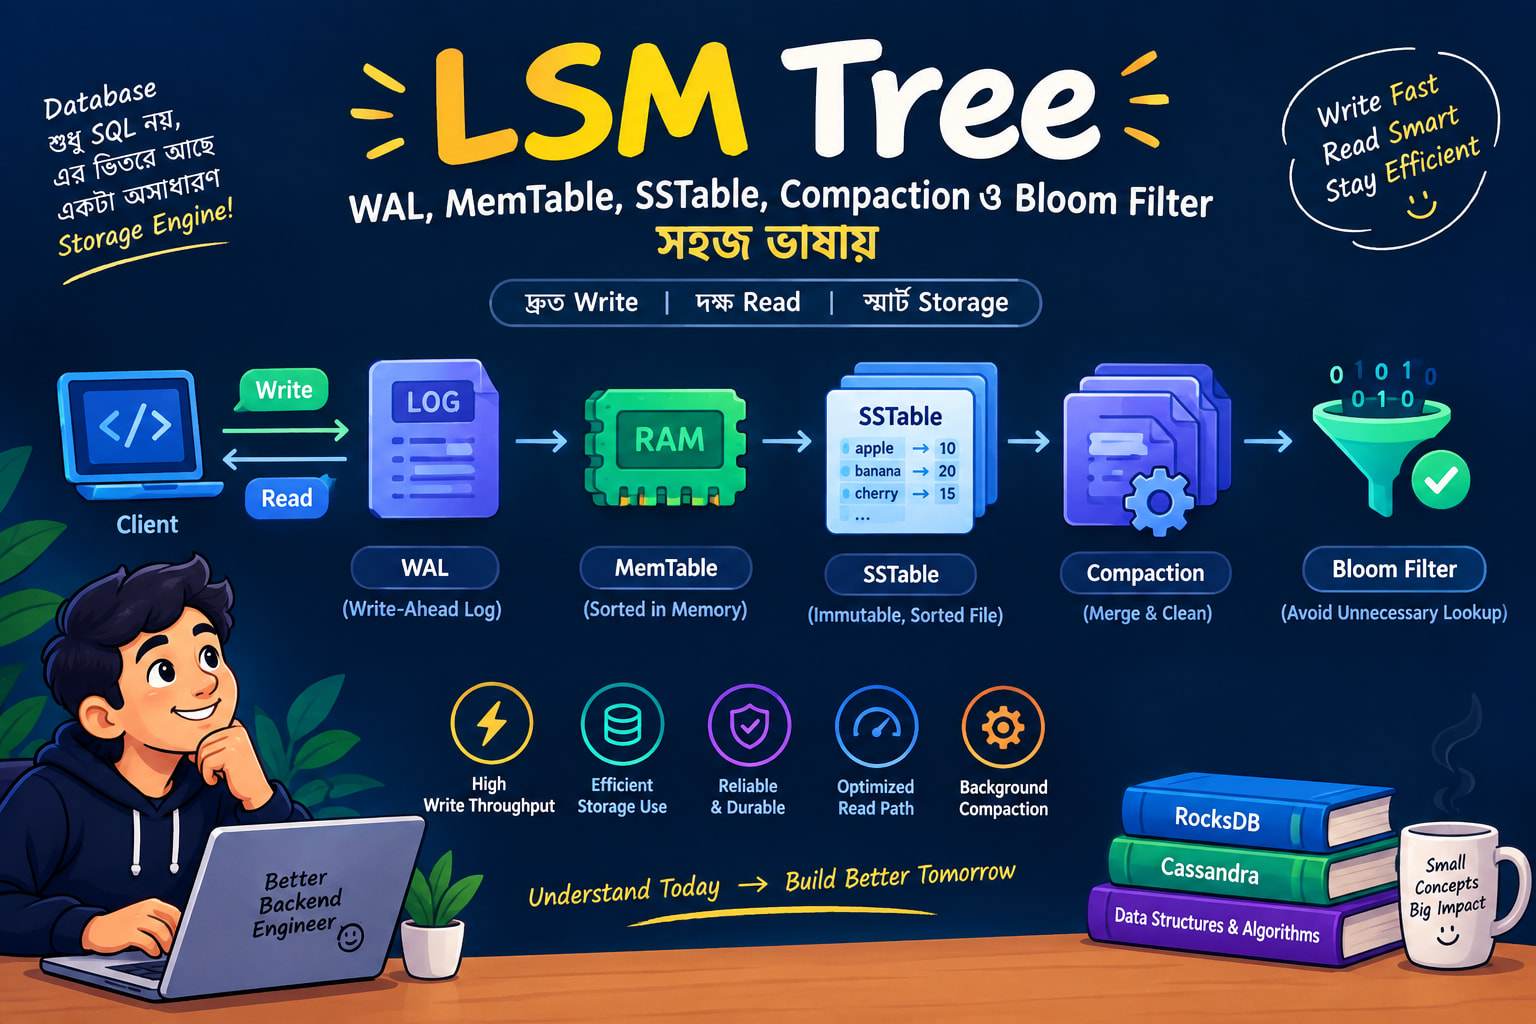
Database বললেই আমরা সাধারণত MySQL, PostgreSQL বা অন্য relational database-এর কথা ভাবি। কিন্তু একটি database-এর ভিতরে data কীভাবে disk ও memory-তে সাজানো হয়, সেটি বুঝতে গেলে শুধু SQL জানলেই হয় না; data structure, algorithm এবং storage hardware তিনটিকেই একসঙ্গে বুঝতে হয়।
এই জায়গায় আসে LSM Tree (Log-Structured Merge Tree)। নাম শুনে ভয় পাওয়ার কিছু নেই। এটি এমন কোনো tree নয় যেটার প্রতিটি node মুখস্থ করতে হবে। বরং এটি এমন একটি storage design, যেখানে দ্রুত write করার জন্য data আগে memory-তে buffer করা হয়, পরে sorted immutable files হিসেবে disk-এ লেখা হয় এবং background compaction-এর মাধ্যমে সেগুলো গোছানো হয়। RocksDB ও Apache Cassandra-এর মতো systems-এর storage architecture-এ এই ধারণা গুরুত্বপূর্ণ।
কেন LSM Tree দরকার?
একটি database-কে মূলত দুই ধরনের কাজ করতে হয়ঃ
Read: data খুঁজে বের করা
Write: data যোগ, update বা delete করা
কিন্তু সব application-এর workload এক নয়। ধরা যাক, একটি result portal-এ exam result প্রকাশের পর লাখ লাখ student একই সময়ে data পড়ছে। এখানে read-heavy workload দেখা যেতে পারে। আবার কোনো e-commerce বা analytics system যদি প্রতি মুহূর্তে user activity, event, telemetry বা log database-এ লিখতে থাকে, তাহলে write volume অনেক বেশি হতে পারে। তাই database design-এর আসল প্রশ্ন হলোঃ
আমার workload কেমন?
LSM Tree মূলত write-intensive workload-এর জন্য খুব কার্যকর একটি design approach, যদিও read performance ধরে রাখতে এর সঙ্গে indexing, caching, Bloom Filter এবং compaction-এর মতো optimization ব্যবহার করা হয়।
Sequential Write বনাম Random Write
LSM Tree বোঝার আগে storage-এর একটি basic বিষয় জানা দরকার। একটি storage device-এ যদি data কাছাকাছি জায়গায় একের পর এক লেখা বা পড়া হয়, সেটাকে সাধারণভাবে sequential access বলা যায়। আর storage-এর বিভিন্ন জায়গায় বারবার jump করতে হলে সেটি random access।
পুরোনো HDD-তে random access-এর penalty অনেক বড় ছিল। SSD এবং NVMe storage এই gap অনেকটাই কমিয়েছে, কিন্তু large-scale storage workload-এ sequential access এখনও গুরুত্বপূর্ণ। বিশেষ করে যখন বিশাল পরিমাণ data continuously লেখা বা rewrite করা হয়। LSM Tree-এর basic idea এখানেই,
প্রতিটি write-এর জন্য disk-এর random location পরিবর্তন না করে, write-গুলোকে buffer করে পরে বড় sorted chunk হিসেবে লিখে দাও।
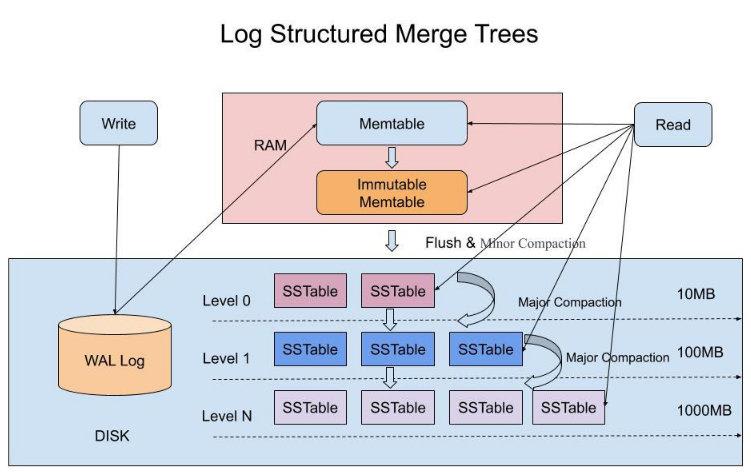
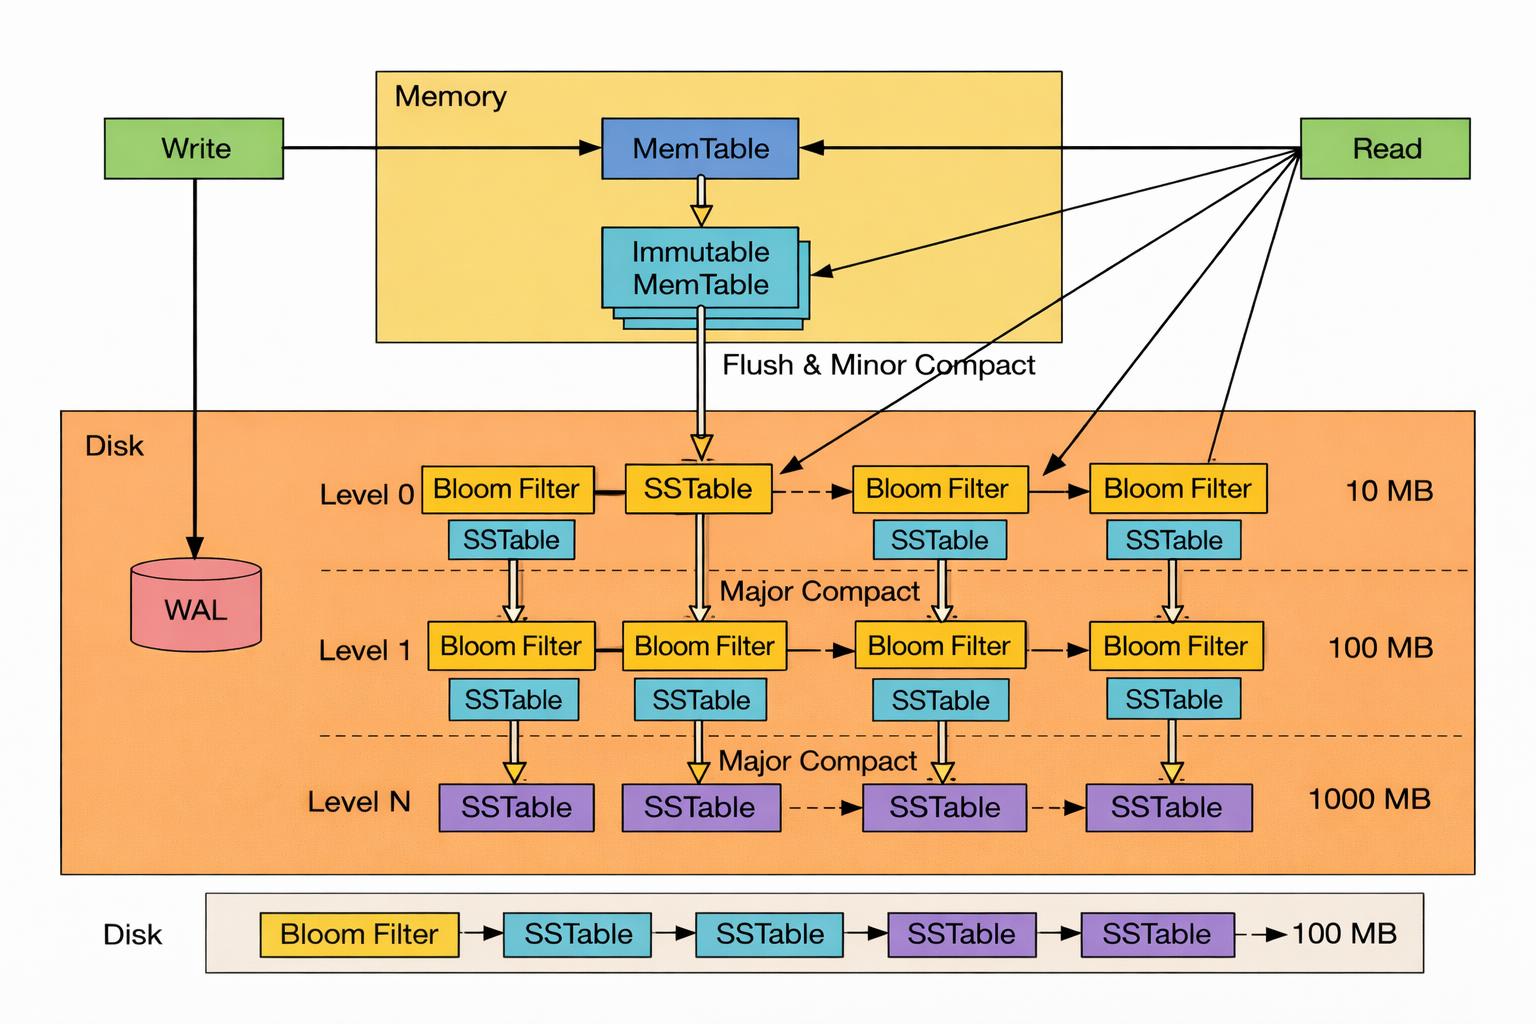
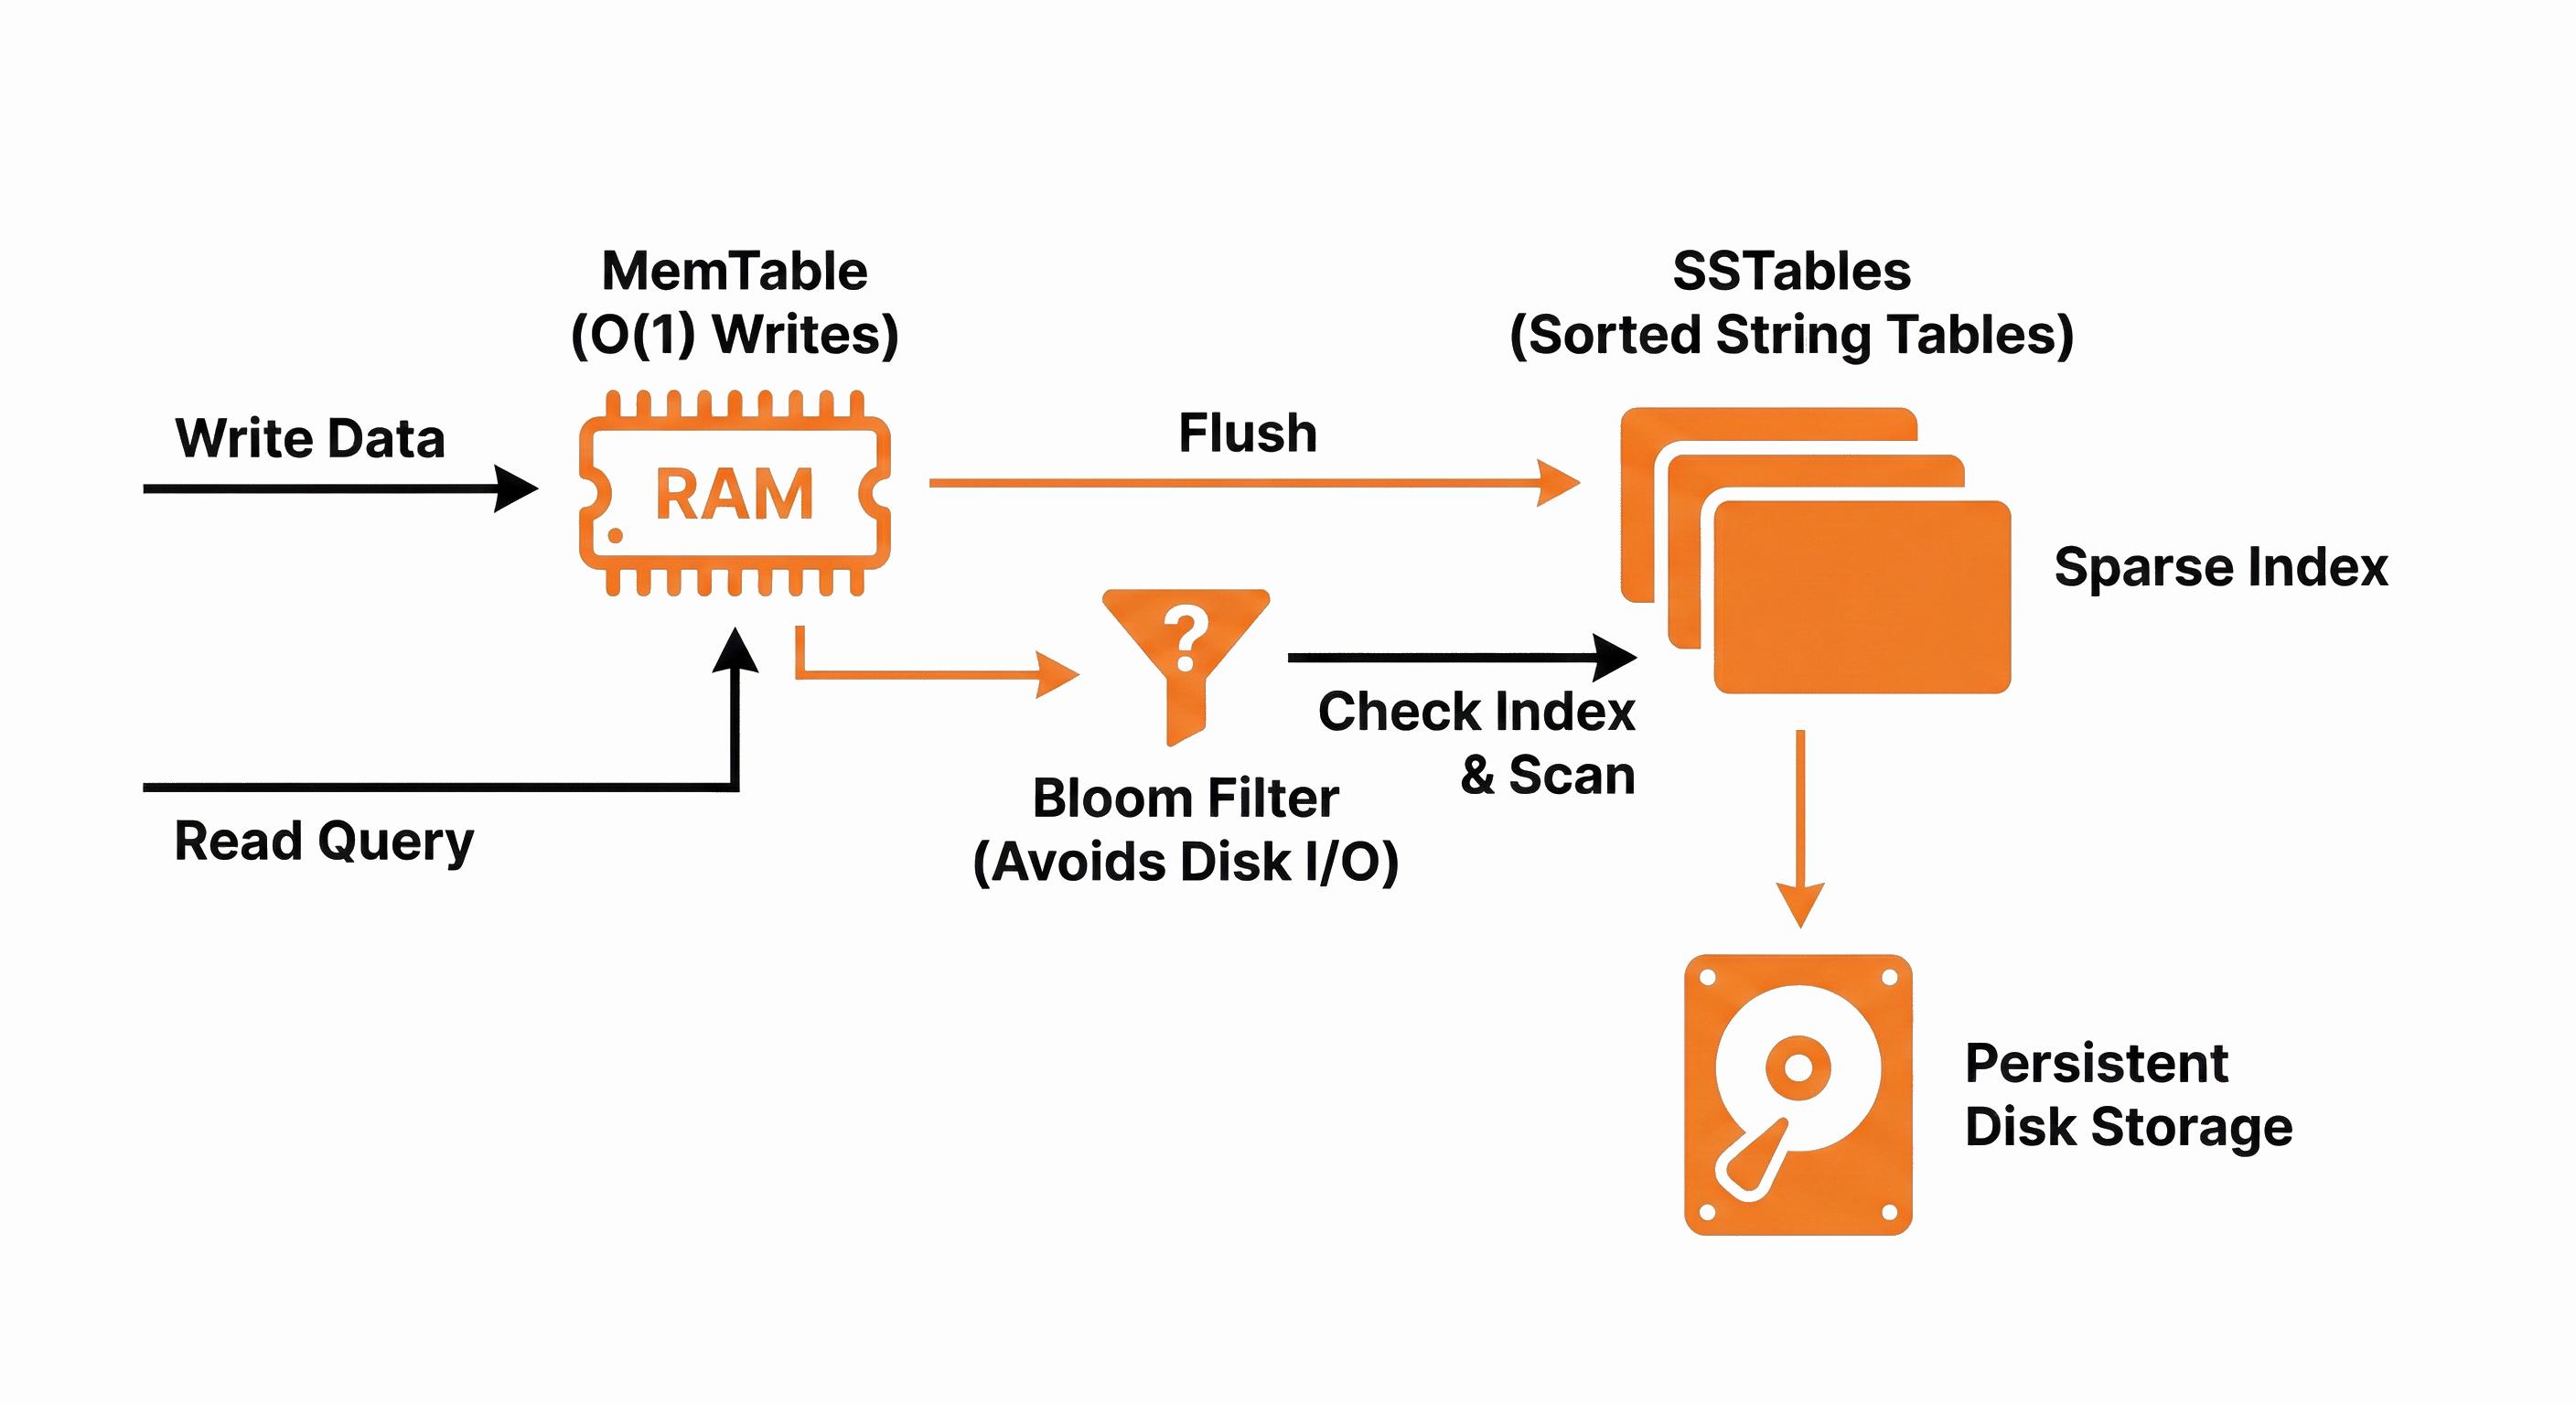
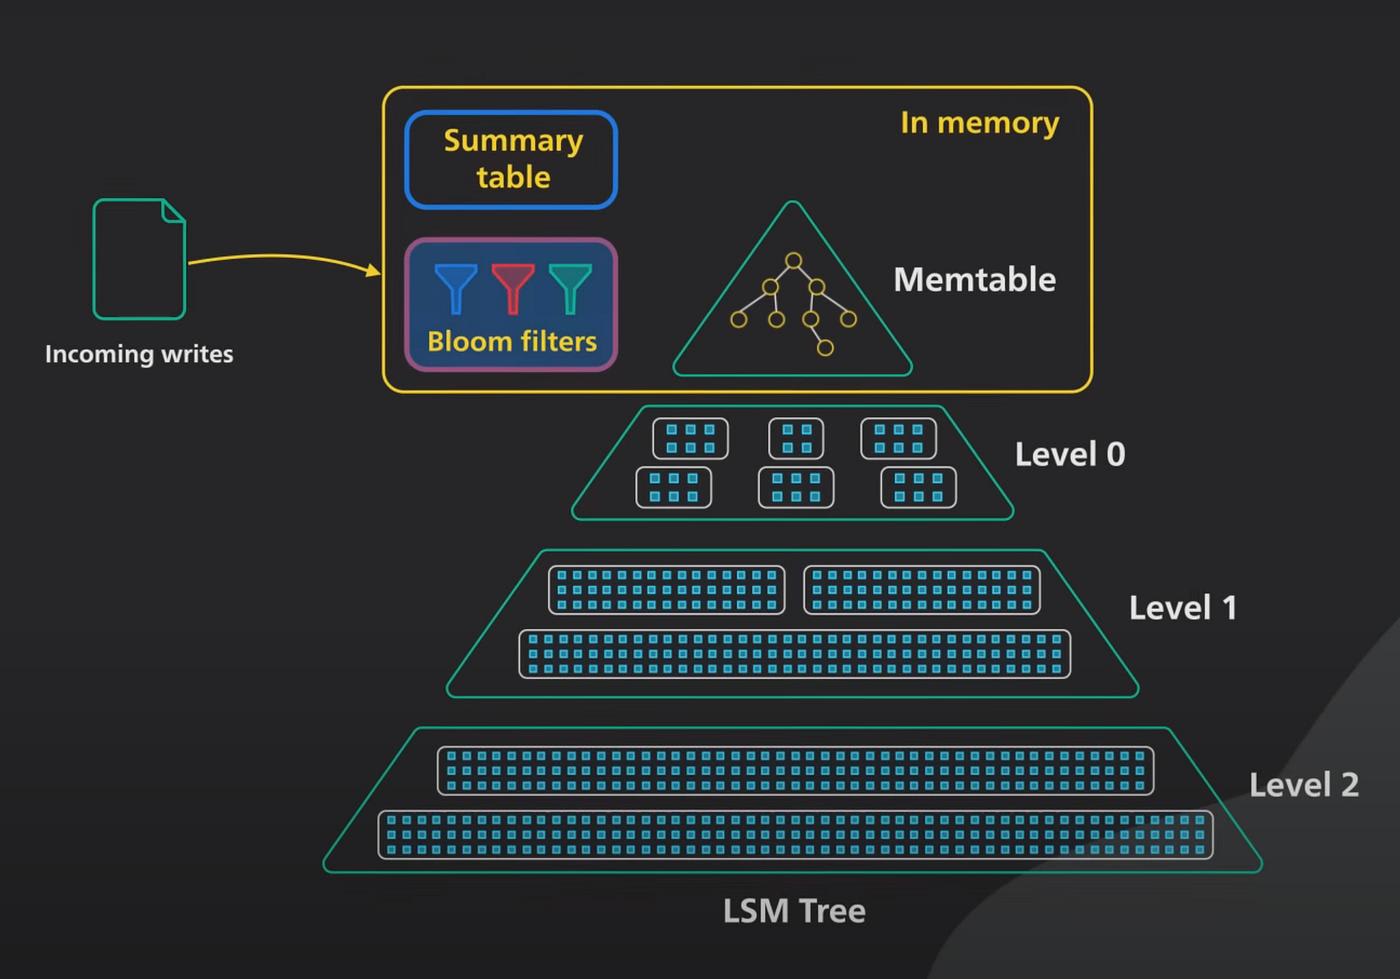
এতে write path অনেক বেশি storage-friendly করা যায়। RocksDB-এর architecture-এ memtable ও log-এ writes জমা করে পরে SSTable-এ flush করার এই flow দেখা যায়।
WAL: Write আগে, নিরাপত্তা পরে নয়, নিরাপত্তাও আগে!
ধরা যাক database-এ তুমি একটি নতুন record লিখলে। Data memory-তে থাকার সময় server crash করল। RAM-এর data গেল, record-ও গেল! এই সমস্যা সামলানোর জন্য অনেক storage engine WAL (Write-Ahead Log) ব্যবহার করে। সহজভাবেঃ
Write Request
     ↓
    WAL
     ↓
 MemTable
WAL হলো append-oriented log যেখানে write operation record করা হয়, যাতে crash বা restart-এর পর database সেই operation গুলো replay করে state পুনর্গঠন করতে পারে। RocksDB-তে WAL এবং Cassandra-তে commit log এই ধরনের durability/recovery mechanism হিসেবে কাজ করে। এখানে একটি বিষয় মনে রাখা জরুরিঃ WAL মূল database table নয়। এর প্রধান উদ্দেশ্য হলো durability এবং recovery।
MemTable: RAM-এর temporary sorting desk
WAL-এ write record করার পর data সাধারণত memory-তে একটি structure-এ রাখা হয়, যাকে বলা হয় MemTable। MemTable-এ data এমনভাবে রাখা হয় যাতে key অনুযায়ী sorted অবস্থায় maintain করা যায়। Implementation অনুযায়ী এর ভিতরের data structure skip list, vector বা অন্য কোনো structure হতে পারে; RocksDB-তে default memtable implementation হিসেবে skip list ব্যবহৃত হয়। ধরা যাক write এলোঃ
banana → 20
apple  → 10
orange → 30
MemTable এটাকে sorted form-এ organize করতে পারেঃ
apple  → 10
banana → 20
orange → 30
এখন প্রশ্ন, MemTable তো RAM-এ। RAM তো unlimited নয়! MemTable একটি নির্দিষ্ট threshold-এ পৌঁছালে সেটিকে disk-এ flush করা হয়।
SSTable: Sorted String Table
MemTable-এর sorted contents disk-এ একটি নতুন immutable file হিসেবে লেখা হলে আমরা পাই SSTable (Sorted String Table)। উদাহরণঃ
apple   → 10
banana  → 20
cherry  → 15
orange  → 30
SSTable-এর একটি গুরুত্বপূর্ণ বৈশিষ্ট্য হলো এটি সাধারণত immutable। অর্থাৎ file তৈরি হয়ে যাওয়ার পর সেটিকে in-place update করা হয় না। নতুন value বা deletion-এর জন্য নতুন record/version তৈরি হতে পারে। Delete-এর ক্ষেত্রে tombstone marker ব্যবহার করা একটি প্রচলিত approach। ফলে একটি update এমন হতে পারে,
Old:
user:101 → Dhaka

New:
user:101 → Rangpur
পুরোনো value মুছে না গিয়ে নতুন version যোগ হলো। পরে compaction obsolete version সরিয়ে দিতে পারে।
তাহলে Read করব কীভাবে?
এখন সমস্যা শুরু। ধরা যাক disk-এ আছে,
SSTable 1
SSTable 2
SSTable 3
SSTable 4
...
SSTable 100
তুমি user:101 খুঁজছ। সব file-এর প্রতিটি record scan করা তো ভয়ংকর idea! এখানে indexing সাহায্য করে।
Sparse Index
একটি SSTable-এর প্রতিটি key-এর exact position memory-তে রাখার বদলে আমরা কিছু key ও তাদের আনুমানিক location রাখি। এটিই Sparse Index-এর basic idea। ধরা যাক,
apple  → block 10
banana → block 25
cherry → block 40
mango  → block 60
এখন blueberry খুঁজলে index থেকে বোঝা যাবে এটি banana ও cherry-এর মাঝামাঝি range-এ রয়েছে। ফলে পুরো file scan করার বদলে ছোট একটি অংশে যেতে হবে। এখানে স্বাভাবিক trade-off আছেঃ
Index বেশি dense → memory usage বেশি, lookup দ্রুত
Index বেশি sparse → memory কম, কিন্তু local scan বেশি
Cassandra-এর SSTable structure-এ index এবং sampled summary-এর পাশাপাশি Bloom Filter-ও থাকে, যা দেখায় production storage engine কীভাবে multiple metadata structure একসঙ্গে ব্যবহার করে।
Compaction: Database-এর housekeeping team
এখনও একটি সমস্যা আছে। একই key-এর নতুন ও পুরোনো version বিভিন্ন SSTable-এ ছড়িয়ে আছে। তার ওপর নতুন data আসতে থাকলে SSTable-এর সংখ্যাও বাড়তে থাকবে। তখন database-কে বারবার অনেক file দেখতে হতে পারে। সমাধানঃ
Compaction
Compaction হলো একাধিক SSTable-কে merge করে নতুন, cleaner SSTable তৈরি করা। যেমনঃ
SSTable A
SSTable B
SSTable C
     ↓
   Merge
     ↓
New SSTable
যেহেতু input SSTable-গুলো sorted, merge process অনেকটা merge-sort বা merging k sorted lists সমস্যার মতো করা যায়। Compaction-এর সময় obsolete update, overwritten value এবং উপযুক্ত ক্ষেত্রে tombstone-এর মাধ্যমে আর প্রয়োজন নেই এমন data সরিয়ে storage layout আরও efficient করা যায়।
Compaction কি database বন্ধ করে দেয়?
পুরোনো কিছু explanation-এ compaction-কে এমনভাবে উপস্থাপন করা হয় যেন compaction চললেই database-এর write বন্ধ হয়ে যায়। বাস্তব production system অনেক বেশি sophisticated। উদাহরণ হিসেবে RocksDB multi-threaded compaction এবং background flush/compaction support করে। তবে compaction যদি incoming write-এর তুলনায় পিছিয়ে পড়ে, তাহলে memory pressure ও write stalls তৈরি হতে পারে। অর্থাৎ, compaction হলো free optimization নয়। এটিরও cost আছে।
Bloom Filter: “এই key এখানে থাকার সম্ভাবনাই নেই!”
ধরো database-এ ১০০টি SSTable রয়েছে। তুমি user:999999 খুঁজছ। যদি এই key database-এ একেবারেই না থাকে, তাহলে ১০০টি file scan করা অর্থহীন। এখানে আসে Bloom Filter। Bloom Filter একটি probabilistic data structure। এটি বলতে পারেঃ
“এই key নিশ্চিতভাবেই এখানে নেই।”
কিন্তু এটি যদি বলেঃ
“সম্ভবত আছে।”
তাহলে actual data structure দিয়ে verify করতে হবে। অর্থাৎ Bloom Filter-এর standard behavior:
Definitely Not Present → নিশ্চিত
Possibly Present       → যাচাই করতে হবে
এই property-এর কারণে unnecessary disk lookup কমানো যায়। Cassandra-এর SSTable-এ Bloom Filter-এর ব্যবহার এবং RocksDB-এর prefix/key filtering দুটিই এই optimization-এর বাস্তব উদাহরণ।
পুরো Read Path
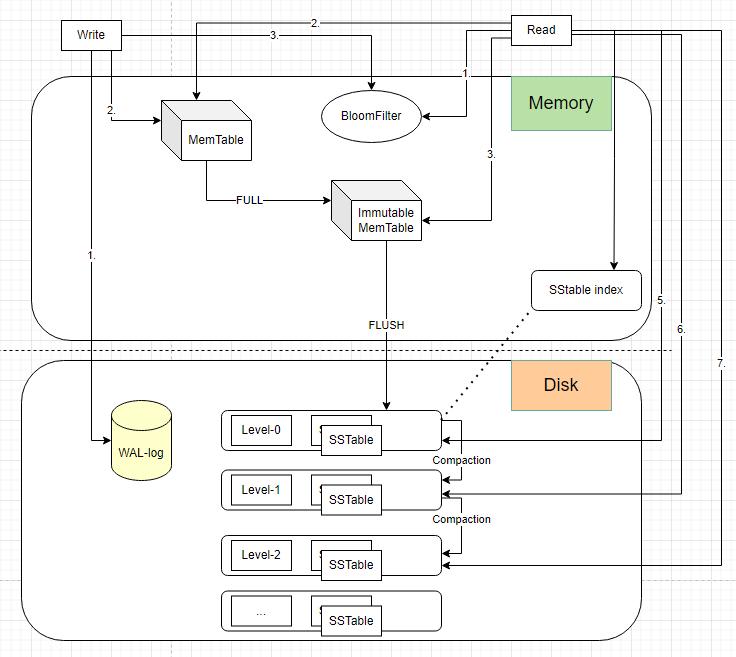
সবকিছু একসঙ্গে রাখলে একটি সাধারণ read flow এমন হতে পারেঃ
               READ
                 ↓
             MemTable
                 ↓
           Bloom Filter
             ↙       ↘
          NO          MAYBE
          ↓             ↓
        STOP       Index / Block
                        ↓
                     SSTable
                        ↓
                 Latest Version
এখানে Bloom Filter-এর কাজ হলো unnecessary search কমানো; Sparse/Block Index-এর কাজ হলো file-এর সঠিক জায়গার কাছে পৌঁছে দেওয়া।
LSM Tree-এর আসল খরচঃ Amplification
LSM Tree write-friendly হলেও এর কিছু cost আছে। একবার logical write করলেই data শুধু এক জায়গায় লেখা হয় না। WAL, MemTable flush এবং পরবর্তী compaction-এর কারণে একই data bytes storage-এ একাধিকবার লেখা বা rewrite হতে পারে। এটিই Write Amplification।
আর LSM systems-এর আরেকটি বিষয় হলো Read Amplification। একটি key খুঁজতে একাধিক memtable/SSTable বা level পরীক্ষা করতে হতে পারে। এছাড়া obsolete data compaction হওয়ার আগ পর্যন্ত disk-এ পড়ে থাকলে Space Amplification-ও দেখা দিতে পারে। অর্থাৎ, database optimization-এর প্রশ্ন শুধু,
“Write কত দ্রুত?”
না। বরং,
“Write, Read, CPU, RAM, I/O এবং Storage সবগুলোর balance কেমন?”
Leveled বনাম Universal/Tiered Compaction
Modern LSM engines-এ compaction-এর একটিমাত্র strategy নেই। Leveled Compaction-এ data বিভিন্ন logical level-এ সংগঠিত থাকে। RocksDB-এর default style হিসেবে এটি space footprint ও read efficiency-এর দিকে বেশি গুরুত্ব দেয়, যদিও rewriting-এর কারণে write amplification বাড়তে পারে।
অন্যদিকে Universal Compaction অনেক file একসঙ্গে merge করে মোট bytes rewritten কমানোর দিকে যেতে পারে, যার বিনিময়ে temporary space বা read amplification বাড়তে পারে। RocksDB বর্তমানে Level, Universal এবং FIFO-সহ বিভিন্ন compaction style support করে। এখানে মূল শিক্ষাঃ
একটি compaction strategy সব workload-এর জন্য ideal নয়।
LSM Tree কোথায় দেখা যায়?
আজকের বাস্তব systems-এ LSM architecture-এর নানা implementation দেখা যায়। RocksDB একটি embeddable key-value storage engine, যেখানে memtable, SSTable, WAL ও compaction গুরুত্বপূর্ণ building blocks। Apache Cassandra write-oriented storage engine হিসেবে LSM architecture ব্যবহার করে; এতে commit log, memtable, immutable SSTable ও background compaction রয়েছে। এছাড়াও LSM-এর immutable-segment ও merge-based ধারণা database-এর বাইরেও search/indexing systems-এ দেখা যায়; Lucene-এর modern merge policies তার একটি উদাহরণ।
বর্তমান Perspective: LSM Tree কেন এখনও গুরুত্বপূর্ণ?
আজকের storage hardware আগের HDD যুগের তুলনায় অনেক দ্রুত। SSD এবং NVMe random I/O-এর latency অনেক কমিয়েছে। তবুও storage engine-এর design problem শেষ হয়নি। বরং নতুন প্রশ্ন এসেছেঃ
- Compaction কত CPU ও I/O ব্যবহার করছে?
- Write amplification কত?
- Read latency-এর tail কতটা?
- Disk space কতটা efficiently ব্যবহার হচ্ছে?
- Background কাজ incoming writes-এর সঙ্গে pace রাখতে পারছে কি?
- Workload অনুযায়ী কোন compaction policy ভালো fit করছে?
RocksDB-এর documentation-এও compaction throughput, background jobs, write stalls এবং বিভিন্ন compaction strategy-কে production tuning-এর গুরুত্বপূর্ণ অংশ হিসেবে দেখানো হয়েছে। তাই LSM Tree শেখার অর্থ শুধু একটি data structure শেখা নয়। এটি শেখায়,
Software performance আসলে algorithm + memory + storage + workload সবকিছুর যৌথ ফল।
এক নজরে পুরো LSM Tree
                 WRITE
                   │
                   ▼
                  WAL
                   │
                   ▼
               MemTable
                   │
                 Flush
                   ▼
              L0 SSTables
                   │
              Compaction
                   ▼
             L1 / L2 / ...
                   │
                   ▼
             Persistent Data
Read-এর ক্ষেত্রেঃ
READ
 │
 ▼
MemTable
 │
 ▼
Bloom Filter
 │
 ├── Definitely absent → STOP
 │
 └── Maybe present
          ↓
      Index / Block
          ↓
        SSTable
          ↓
     Latest Version
সবকিছু মনে রাখার সবচেয়ে সহজ formula:
WAL → MemTable → SSTable → Compaction + Bloom Filter
WAL durability দেয়। MemTable memory-তে write buffer করে। SSTable sorted immutable data ধরে। Compaction database-কে গুছিয়ে রাখে। Bloom Filter unnecessary lookup কমায়।
শেষ কথা
LSM Tree-কে শুধু “দ্রুত write করার tree” হিসেবে ভাবলে ধারণাটার অর্ধেকই শেখা হবে। এর আসল সৌন্দর্য হলো trade-off। তুমি write path সহজ ও দ্রুত করলে পরে compaction-এর কাজ বাড়তে পারে। Immutable file ব্যবহারে update সহজ হলে obsolete data জমতে পারে। Read দ্রুত করতে index ও Bloom Filter লাগতে পারে। Compaction storage পরিষ্কার করবে, কিন্তু তার জন্য CPU ও I/O খরচ হবে। অর্থাৎ LSM Tree কোনো magic trick নয়। এটি এমন একটি carefully engineered system যেখানে database চেষ্টা করে,
দ্রুত write করতে, যথেষ্ট দ্রুত read দিতে এবং storage-কে নিয়ন্ত্রণের মধ্যে রাখতে।
একজন backend engineer-এর জন্য এটাই সবচেয়ে গুরুত্বপূর্ণ শিক্ষা। Database ব্যবহার করা এক জিনিস, আর database কেন এভাবে কাজ করে তা বোঝা সম্পূর্ণ অন্য জিনিস।