#ক্যাশিং #lru ক্যাশ #ডেটা স্ট্রাকচার #অ্যালগরিদম #সিস্টেম ডিজাইন #ব্যাকএন্ড ডেভেলপমেন্ট #typescript #লিংকড লিস্ট #হ্যাশম্যাপ #পারফরম্যান্স অপটিমাইজেশন #redis #কোডিং ইন্টারভিউ #lru cache #cache eviction #caching #system design #data structures
ক্যাশিং আসলে কী, ক্যাশ ভরে গেলে কাকে বিদায় করতে হয়, আর LRU ক্যাশ কীভাবে কাজ করে
2026-09-20 · 28 min read
আপনার অ্যাপ ১০০ জন ইউজার নিয়ে উড়ছিল। ১০ হাজারে এসে হাঁপাচ্ছে। ডেটাবেসের CPU ৯০%-এ আটকে আছে, পেজ লোড হতে তিন সেকেন্ড, আর আপনি ব্রাউজারে একটা ট্যাব খুলে বড় সার্ভারের দাম দেখছেন। একটু দাঁড়ান। কার্ড বের করার আগে একটাই প্রশ্ন করুন নিজেকেঃ
একই উত্তরটা আপনি দিনে কতবার নতুন করে হিসাব করছেন?
উত্তরটা সাধারণত লজ্জাজনক। আর সেই লজ্জা থেকে বাঁচার নামই ক্যাশিং। আজকের লেখায় দেখব ক্যাশিং আসলে কী, ক্যাশ ভরে গেলে কাকে ছেঁটে ফেলতে হয়, এবং সবচেয়ে জনপ্রিয় ছাঁটাই-নীতি LRU (Least Recently Used) কীভাবে কাজ করে। ক্যাশিং আগে থেকেই জানা থাকলে প্রথম দুটো সেকশন দ্রুত পেরিয়ে যান।
০১ক্যাশিং আসলে কী
ধরুন আপনি একটা AI রাইটিং অ্যাপ বানাচ্ছেন। ইউজার যতবার Generate বোতামে চাপ দেয়, ততবার আপনার সার্ভারকে জানতে হয় এই ইউজার Free, Pro, নাকি Team প্ল্যানে? কারণ এর ওপর নির্ভর করছে কোন মডেল চালাবেন, রেট লিমিট কত, আর কোটা কতটুকু বাকি। প্ল্যানের তথ্যটা মাসে একবারও বদলায় না। অথচ আপনি সেকেন্ডে পঞ্চাশবার ডেটাবেসকে হুবহু একই প্রশ্ন করে যাচ্ছেন, আর প্রতিবার ডেটাবেস ধৈর্য ধরে একই উত্তর দিচ্ছে।
সমাধানটা সহজঃ উত্তরটা মেমরিতে লিখে রাখুন। পরেরবার আগে মেমরিতে উঁকি দিন; পেলে ডেটাবেস পর্যন্ত যাওয়ারই দরকার নেই। এটুকুই ক্যাশিং।
ক্যাশিং মানেঃ ধীর বা দামি জায়গা থেকে পাওয়া উত্তরটা দ্রুত বা সস্তা জায়গায় রেখে দেওয়া, যাতে পরেরবার আর কষ্ট করতে না হয়।
দুটো শব্দ এখানেই শিখে রাখুন, সারা জীবন কাজে লাগবে। ক্যাশ হিট (খুঁজতে গিয়ে পেয়ে গেলেন) আর ক্যাশ মিস (পেলেন না, আসল উৎসে যেতেই হলো)।
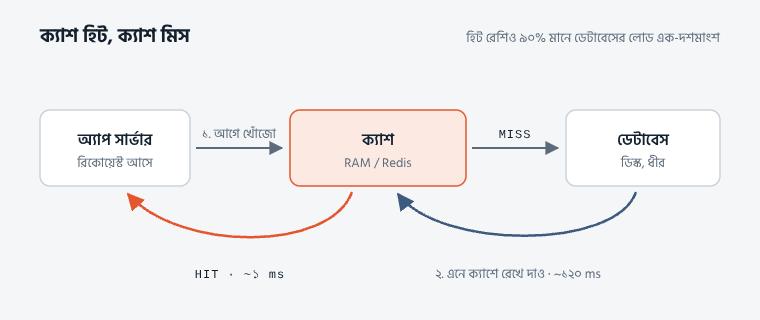 ক্যাশ হিট মানে শর্টকাট, ক্যাশ মিস মানে পুরো রাস্তা।
মোট রিকোয়েস্টের কত ভাগ হিট হলো, তাকে বলে হিট রেশিও। হিট রেশিও ৯০% মানে আপনার ডেটাবেস আগের এক-দশমাংশ কাজ করছে। এক লাইন কোডে এর চেয়ে ভালো রিটার্ন খুব কম জায়গায় পাবেন।
০২ক্যাশ আসলে সব জায়গাতেই আছে
ক্যাশিং শুধু ডেটাবেসের ব্যথা কমানোর জিনিস না। আপনার কম্পিউটারের ভেতরে এই মুহূর্তে অন্তত পাঁচ স্তরে ক্যাশিং চলছে। CPU কোর নিজের ভেতরে ডেটা জমিয়ে রাখছে যাতে র্যাম পর্যন্ত যেতে না হয়, OS ডিস্কের ফাইল র্যামে ধরে রাখছে, ব্রাউজার ছবি জমিয়ে রাখছে। কেন এত কষ্ট, সেটা বুঝতে সংখ্যাগুলো একবার পাশাপাশি দেখুনঃ
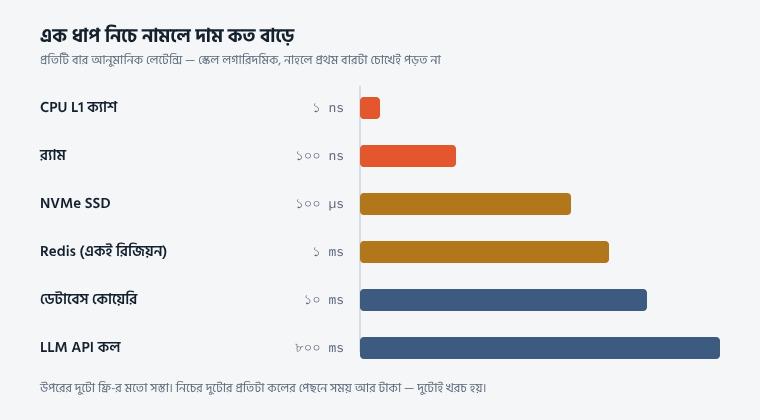 স্কেলটা লগারিদমিক। সোজা স্কেলে আঁকলে প্রথম বারটা চোখেই পড়ত না।
খেয়াল করুন, প্রতিটা ধাপ নিচে নামা মানে ১০ থেকে ১০০ গুণ বেশি অপেক্ষা। বর্তমান সময়ে এসে সবচেয়ে নিচের ধাপটায় শুধু সময় না, টাকাও খরচ হচ্ছে। প্রতিটা LLM কলের বিল আছে। তাই আজকের ক্যাশিং-এর তালিকাটা আগের চেয়ে অনেক লম্বাঃ
| স্তর | উদাহরণ | কী জমা থাকে |
|---|---|---|
| ব্রাউজার | Cache-Control, Service Worker | ছবি, JS বান্ডল, API রেসপন্স |
| এজ / CDN | Cloudflare, Vercel Edge | রেন্ডার করা পেজ, স্ট্যাটিক ফাইল |
| অ্যাপ্লিকেশন | ইন-মেমরি Map, Caffeine | ইউজার প্ল্যান, ফিচার ফ্ল্যাগ, কনফিগ |
| শেয়ার্ড | Redis, Valkey, Memcached | সেশন, লিডারবোর্ড, রেট লিমিট |
| ডেটাবেস | বাফার পুল, মেটেরিয়ালাইজড ভিউ | হট পেজ, প্রি-কম্পিউটেড রেজাল্ট |
| AI লেয়ার | প্রম্পট ক্যাশ, সিমান্টিক ক্যাশ | রিপিট করা কনটেক্সট, এমবেডিং, উত্তর |
শেষ সারিটা নতুন, আর এটাই এখন সবচেয়ে দামি। একই সিস্টেম প্রম্পট বা একই ডকুমেন্ট বারবার পাঠালে প্রম্পট ক্যাশিং সেই অংশের খরচ নাটকীয়ভাবে কমিয়ে দেয়। ক্যাশিং জানা মানে এখন সরাসরি ক্লাউড বিল কমানো জানা।
০৩সমস্যাঃ ক্যাশ ছোট, দুনিয়া বড়
ক্যাশিং শুনতে যত সহজ, বাস্তবে একটা কাঁটা আছে। ক্যাশ সবসময় ছোট। আপনার ডেটাবেসে ৫ টেরাবাইট ডেটা, আর সার্ভারের র্যাম ৩২ গিগাবাইট। অঙ্কটা মেলে না, মেলার কথাও না। আর মিলে গেলে সেটা আর ক্যাশ থাকে না, সেটা আরেকটা ডেটাবেস হয়ে যায়। মানে নতুন কিছু ঢোকাতে গেলে একসময় পুরোনো কাউকে বিদায় দিতেই হবে। এই বিদায়-পর্বের নাম ক্যাশ এভিকশন, আর কাকে বিদায় দেবেন সেই নিয়মের নাম এভিকশন পলিসি।
- FIFO - যে আগে এসেছে, সে আগে যাবে। সহজ, কিন্তু বোকাঃ সবচেয়ে বেশি ব্যবহৃত ডেটাটাই হয়তো সবার আগে ঢুকেছিল।
- Random - চোখ বুজে একজনকে বাদ। হাসবেন না, প্রচণ্ড দ্রুত এবং অবাক করার মতো ভালো কাজ করে।
- TTL - নির্দিষ্ট সময় পর নিজে থেকেই মেয়াদ শেষ। এটা আসলে “জায়গা নেই” নয়, “তথ্য বাসি” সমস্যার সমাধান।
- LFU - যাকে সবচেয়ে কমবার ডাকা হয়েছে, সে বাদ।
- LRU - যাকে সবচেয়ে বেশিদিন কেউ খোঁজেনি, সে বাদ।
শেষেরটাই আমাদের আজকের নায়ক এবং দুনিয়ার সবচেয়ে বেশি ব্যবহৃত পলিসি।
০৪LRU-র মূলমন্ত্র
যেটা এইমাত্র দরকার হয়েছে, সেটা একটু পরে আবার দরকার হওয়ার সম্ভাবনা সবচেয়ে বেশি।
কম্পিউটার সায়েন্সে এর নাম টেম্পোরাল লোকালিটি, আর বাস্তবে এটা অদ্ভুত রকম সত্যি। এই মুহূর্তে আপনার ব্রাউজারে যে ট্যাবটা খোলা, পাঁচ মিনিট পরেও সেটাতেই ফিরে আসার সম্ভাবনা বেশি গত মঙ্গলবারের ট্যাবটার চেয়ে। তাহলে LRU-কে শুধু একটা জিনিস মনে রাখতে হয়ঃ কাকে সবচেয়ে পরে ছোঁয়া হয়েছে। তিন স্লটের একটা ছোট ক্যাশ দিয়ে পুরো ব্যাপারটা দেখে নিই,
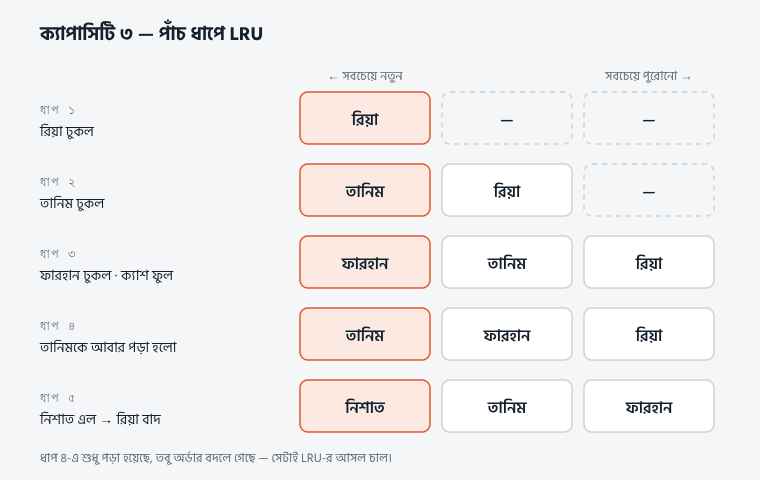 ধাপে ধাপেঃ কে সামনে এল, আর কে পেছন দিয়ে বেরিয়ে গেল।
ধাপ ৪-টা ভালো করে দেখুন। তানিমের ডেটা শুধু পড়া হয়েছে, কিছু লেখা হয়নি, কিছু বদলায়নি। তবু ক্যাশের ভেতরের ক্রম বদলে গেছে, তানিম লাইনের সামনে চলে এসেছে। আর সেজন্যই ধাপ ৫-এ নিশাত ঢোকার সময় তানিম বেঁচে গেল, রিয়া বাদ পড়ল।
get()-ও একটা রাইট অপারেশন। পড়াটাও ক্যাশের অবস্থা বদলে দেয়। যে ইমপ্লিমেন্টেশনে get() অর্ডার আপডেট করে না, সেটা LRU নয়। সেটা ছদ্মবেশে FIFO।
০৫কোড লেখার চারটা চেষ্টা
ক্যাশ মানে মোটে দুটো ফাংশনঃ get(key) আর put(key, value)। দুটোকেই যত দ্রুত সম্ভব হতে হবে। কারণ ক্যাশ নিজেই যদি ধীর হয়, তাহলে পুরো আয়োজনটাই হাস্যকর।
চেষ্টা ১ঃ একটা অ্যারে
প্রতিটা ঘরে key, value আর শেষ কখন ছোঁয়া হয়েছে সেটা রাখুন। খুঁজতে হলে পুরো অ্যারে ঘুরে দেখুন, বাদ দিতে হলেও পুরোটা ঘুরে সবচেয়ে পুরোনোটা বের করুন। দুটোই O(n)। ক্যাশ যদি ধীরই হয়, ডেটাবেসই ভালো ছিল।
চেষ্টা ২ঃ হ্যাশম্যাপ
এখন get() গড়ে O(1)। কিন্তু ক্যাশ ভরে গেলে সবচেয়ে পুরোনো key খুঁজতে এখনো পুরো ম্যাপ ঘুরতে হচ্ছে put() তাই O(n)। অর্ধেক সমস্যার সমাধান।
চেষ্টা ৩ঃ ব্যালান্সড ট্রি বা হিপ
টাইমস্ট্যাম্প দিয়ে সাজিয়ে রাখলে সবচেয়ে পুরোনোটা সহজেই পাওয়া যায়, দুটো অপারেশনই O(log n)। ভালো, কিন্তু প্রতিটা get()-এ টাইমস্ট্যাম্প বদলে আবার সাজাতে হচ্ছে। ঝামেলাও বেশি, খরচও বেশি।
চেষ্টা ৪ঃ হ্যাশম্যাপ + ডাবলি লিংকড লিস্ট
দুটোই O(1)। এটাই স্ট্যান্ডার্ড উত্তর।
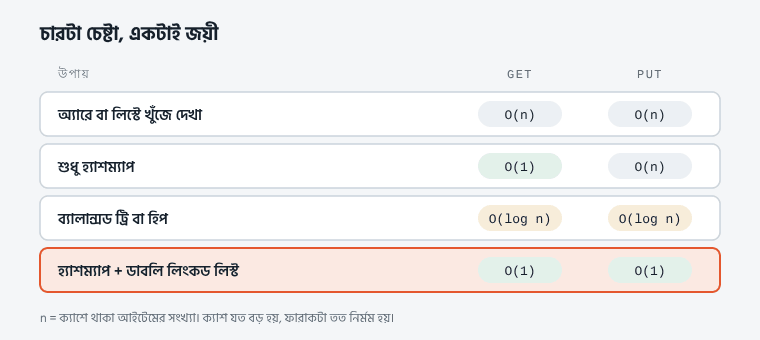 n = ক্যাশে থাকা আইটেমের সংখ্যা। ক্যাশ যত বড়, ফারাকটা তত নির্মম।
০৬কেন ঠিক এই দুটো জিনিস
মজার ব্যাপার হলো, দুটো স্ট্রাকচারের কেউই একা এই কাজটা পারে না। কিন্তু জোড়া বাঁধলে একে অপরের দুর্বলতা ঢেকে দেয়।
- হ্যাশম্যাপ জানে কোথায় key দিলে গড়ে
O(1)-এ নোডের ঠিকানা ধরিয়ে দেয়। কিন্তু কে নতুন কে পুরোনো, তার কোনো ধারণাই তার নেই। - ডাবলি লিংকড লিস্ট জানে ক্রম সামনে সবচেয়ে নতুন, পেছনে সবচেয়ে পুরোনো। কিন্তু নির্দিষ্ট একটা key খুঁজতে হলে তাকে পুরো লিস্ট হাঁটতে হয়।
তাই হ্যাশম্যাপে আমরা ভ্যালু রাখি না, রাখি লিংকড লিস্টের নোডের ঠিকানা।
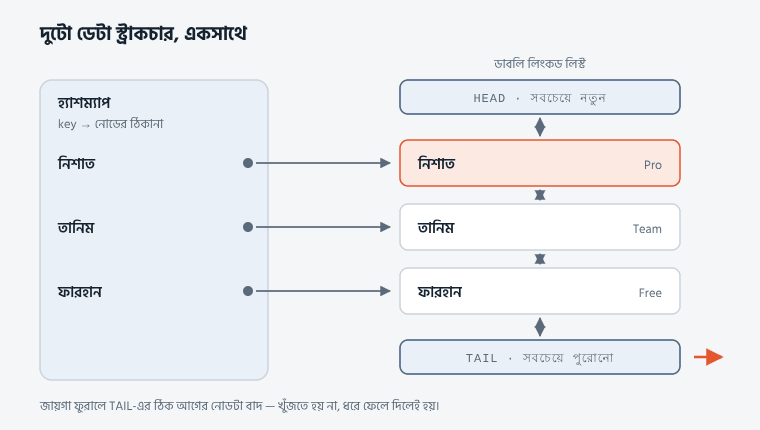 key দিয়ে সরাসরি নোডে পৌঁছানো যায়, তাই খোঁজাখুঁজির দরকারই পড়ে না।
এই গাঁটছড়ার পর তিনটে কাজই O(1) হয়ে যায়। খুঁজে বের করা (হ্যাশম্যাপ সরাসরি নোড দেয়), সামনে আনা (নোড হাতে আছে, কয়েকটা পয়েন্টার বদলালেই হয়) আর বাদ দেওয়া (সবচেয়ে পুরোনো নোড সবসময় টেইলের ঠিক আগে)। সিঙ্গলি লিংকড লিস্টে হয় না কেন? কারণ মাঝখান থেকে একটা নোড খুলতে হলে তার আগের নোডটা দরকার। সিঙ্গলি লিস্টে সেটা পেতে হলে শুরু থেকে হাঁটতে হয়, আর সাথে সাথেই O(n)। prev পয়েন্টারটা এখানে বিলাসিতা নয়, পুরো অ্যালগরিদমের শর্ত।
একটা ছোট কৌশলঃ লিস্টের দুই মাথায় দুটো ডামি নোড রাখুন head আর tail, যাদের ভেতরে কোনো ডেটা নেই। এদের বলা হয় সেন্টিনেল নোড। এতে লিস্ট খালি কি না, নোডটা প্রথম না শেষ এসব null চেক করার দরকারই পড়ে না। ইন্টারভিউতে অর্ধেক বাগ এখানেই জন্ম নেয়।
০৭পুরো কোড
class LRUNode<V> {
  prev: LRUNode<V> | null = null;
  next: LRUNode<V> | null = null;
  constructor(public key: string, public value: V) {}
}

export class LRUCache<V> {
  private readonly map = new Map<string, LRUNode<V>>();
  private readonly head: LRUNode<V>; // সেন্টিনেল — সবচেয়ে নতুনের পাশে
  private readonly tail: LRUNode<V>; // সেন্টিনেল — সবচেয়ে পুরোনোর পাশে

  constructor(private readonly capacity: number) {
    if (capacity < 1) throw new Error('ক্যাপাসিটি অন্তত ১ হতে হবে');

    this.head = new LRUNode<V>('__head__', null as never);
    this.tail = new LRUNode<V>('__tail__', null as never);
    this.head.next = this.tail;
    this.tail.prev = this.head;
  }

  get(key: string): V | undefined {
    const node = this.map.get(key);
    if (!node) return undefined; // ক্যাশ মিস

    // পড়াটাও একটা লেখা — নোডকে সামনে নিয়ে আসতে হবে
    this.unlink(node);
    this.pushFront(node);
    return node.value;
  }

  put(key: string, value: V): void {
    const existing = this.map.get(key);

    if (existing) {
      existing.value = value; // নতুন নোড নয়, পুরোনোটাই আপডেট
      this.unlink(existing);
      this.pushFront(existing);
      return;
    }

    const node = new LRUNode(key, value);
    this.map.set(key, node);
    this.pushFront(node);

    if (this.map.size > this.capacity) this.evict();
  }

  private evict(): void {
    const lru = this.tail.prev!;
    if (lru === this.head) return; // লিস্ট খালি

    this.unlink(lru);
    this.map.delete(lru.key); // দুই জায়গা থেকেই মুছতে হবে
  }

  private unlink(node: LRUNode<V>): void {
    node.prev!.next = node.next;
    node.next!.prev = node.prev;
    node.prev = node.next = null;
  }

  private pushFront(node: LRUNode<V>): void {
    node.next = this.head.next;
    node.prev = this.head;
    this.head.next!.prev = node;
    this.head.next = node;
  }

  get size(): number {
    return this.map.size;
  }
}const plans = new LRUCache<string>(3);
plans.put('riya', 'Pro');
plans.put('tanim', 'Team');
plans.put('farhan', 'Free');
plans.get('tanim'); // 'Team' — তানিম এখন সবচেয়ে নতুন
plans.put('nishat', 'Pro'); // রিয়া বাদ পড়ল
plans.get('riya'); // undefined → ডেটাবেসে যেতে হবে
plans.get('tanim'); // 'Team' → বেঁচে গেছেপুরো ক্লাসটা ৫০ লাইনের নিচে, বাইরের কোনো লাইব্রেরি লাগেনি, আর দুটো অপারেশনই O(1)।
০৮আর যদি কোড না লিখতে চান
সত্যি কথা হলো, প্রোডাকশনে আপনাকে এটা খুব কমই হাতে লিখতে হবে। JavaScript-এর Map ইনসার্শনের ক্রম মনে রাখে, তাই LRU প্রায় ফ্রি।
class TinyLRU<V> {
  private map = new Map<string, V>();
  constructor(private capacity: number) {}

  get(key: string): V | undefined {
    if (!this.map.has(key)) return undefined;
    const value = this.map.get(key)!;
    this.map.delete(key);
    this.map.set(key, value); // আবার শেষে বসল = সবচেয়ে নতুন
    return value;
  }

  put(key: string, value: V): void {
    this.map.delete(key);
    this.map.set(key, value);
    if (this.map.size > this.capacity) {
      // ইটারেশনের প্রথম key-ই সবচেয়ে পুরোনো
      this.map.delete(this.map.keys().next().value!);
    }
  }
}
অন্য ভাষায়ঃ Python-এ functools.lru_cache বা OrderedDict, Java-য় LinkedHashMap (accessOrder = true) বা Caffeine, Go-তে hashicorp/golang-lru, আর Redis বা Valkey-তে মোটে একটা কনফিগ লাইন — maxmemory-policy allkeys-lru। তবে সাবধান, ইন্টারভিউতে প্রথমেই এই শর্টকাটটা লিখে ফেললে পরের বাক্যটা হবেঃ “সুন্দর। এবার Map ছাড়া, শুধু লিংকড লিস্ট দিয়ে লিখুন।” তাই উপরের ৫০ লাইন মাথায় থাকা দরকার।
০৯পাঁচটা বাগ যেখানে প্রায় সবাই পড়ে
get()-এ অর্ডার আপডেট না করা। সবচেয়ে সাধারণ ভুল। কোড চলবে, টেস্টও হয়তো পাস করবে, কিন্তু আপনার ক্যাশ চুপচাপ FIFO হয়ে গেছে। আর হিট রেশিও কেন কমছে, কেউ বুঝবে না।- ক্যাপাসিটি চেক ভুল সময়ে। ঢোকানোর আগে
>=চেক করবেন, নাকি ঢোকানোর পরে>? দুটো একসাথে করলে ক্যাশ একটা কম ধরবে। ছোট ভুল, ধরতে বড় সময় লাগে। - একই key আবার
putকরলে নতুন নোড বানানো। পুরোনো নোডটা লিস্টে থেকেই যায়, কিন্তু হ্যাশম্যাপ আর তাকে চেনে না। ফলঃ ভুতুড়ে নোড, আর ক্যাশের সাইজ হিসাবের বাইরে। - এভিকশনের সময় শুধু এক জায়গা থেকে মোছা। লিস্ট থেকে নোড খুলেছেন কিন্তু হ্যাশম্যাপ থেকে
deleteকরেননি। ক্যাশ কখনো ছোট হচ্ছে না, মেমরি বাড়তেই থাকছে। দুই জায়গা, সবসময় একসাথে। - চারটা সার্ভার, চারটা আলাদা ক্যাশ। ইন-মেমরি ক্যাশ প্রতিটা ইনস্ট্যান্সের নিজস্ব। ইউজার প্ল্যান বদলালে একটা সার্ভার নতুন তথ্য পাবে, বাকি তিনটা পুরোনোটাই পরিবেশন করতে থাকবে।
আর একটা কথা মনে রাখবেনঃ TTL আর LRU আলাদা সমস্যার উত্তর। LRU বলে “জায়গা নেই”, TTL বলে “তথ্য বাসি”। প্রোডাকশনে সাধারণত দুটোই লাগে।
কম্পিউটার সায়েন্সে সত্যিকারের কঠিন কাজ দুটোই। ক্যাশ ইনভ্যালিডেশন আর জিনিসের নাম রাখা।- ফিল কার্লটন
১০LRU কোথায় মার খায়
LRU নিখুঁত নয়। তার সবচেয়ে বড় দুর্বলতা হলো স্ক্যান। রাত দুটোয় আপনার রিপোর্টিং জব চালু হলো এবং দশ লাখ রো একবার করে পড়ল। LRU বাধ্য ছেলের মতো প্রতিটা রোকে “এইমাত্র ব্যবহৃত” ধরে ক্যাশে ঢোকাল, আর আপনার আসল হট ডেটা যেটা সারাদিন হাজারবার লেগেছে টেইলের দিকে সরতে সরতে বেরিয়ে গেল। সকালবেলা ক্যাশ ভর্তি, অথচ হিট রেশিও শূন্যের কাছাকাছি। এই “ওয়ান-হিট ওয়ান্ডার” সমস্যার জন্যই আধুনিক পলিসিগুলো এসেছে,
- W-TinyLFU: ঢোকার মুখেই একটা ছোট ফ্রিকোয়েন্সি স্কেচ দিয়ে দেখে, নতুন আইটেমটা আদৌ জায়গা পাওয়ার যোগ্য কি না। Java-র Caffeine এটাই ব্যবহার করে।
- S3-FIFO: কয়েকটা সাধারণ FIFO কিউ দিয়েই LRU-র চেয়ে ভালো হিট রেশিও আনে, তাও অনেক কম মেটাডেটা খরচে।
- ARC: রিসেন্সি আর ফ্রিকোয়েন্সির মাঝে নিজে নিজেই ভারসাম্য ঠিক করে নেয়।
তবু ডিফল্ট হিসেবে LRU-ই সবচেয়ে ভালো। বোঝা সহজ, ডিবাগ করা সহজ, আর বেশিরভাগ ওয়ার্কলোডে যথেষ্ট ভালো। আগে LRU দিয়ে শুরু করুন, মেট্রিক দেখে তারপর বদলান, উল্টোটা নয়।
শেষ কথা
ক্যাশিং জাদু নয়, ট্রেড-অফ। আপনি গতি কিনছেন, আর তার দাম দিচ্ছেন মেমরি দিয়ে, আর কিছুটা ঝুঁকি দিয়ে। ডেটা হয়তো একটু বাসি হবে। আর LRU হলো সেই দুর্দান্ত জিনিসগুলোর একটা, যেটা ব্যাখ্যা করতে এক বাক্য লাগে, কোড লিখতে পঞ্চাশ লাইন লাগে, আর এই মুহূর্তে আপনার CPU থেকে শুরু করে Redis সার্ভার পর্যন্ত সবখানে চলছে।
নিজে হাতে করে দেখুন
- উপরের ক্লাসটা না দেখে লিখুনঃ LeetCode 146: LRU Cache
- তারপর
get()-এর সামনে-আনা লাইন দুটো মুছে দিন, আর দেখুন হিট রেশিও কত নামে। - পারলে
capacityআর TTL একসাথে যোগ করুন। তখনই বুঝবেন ইনভ্যালিডেশন কেন কঠিন।