#floyd-cycle-detection #tortoise-and-hare #linked-list #cycle-detection #data-structures #algorithms #dsa #two-pointers #competitive-programming #interview-preparation #floyd-cycle-detection-linked-list #linked list-এ cycle detection: floyd’s tortoise & hare algorithm সহজভাবে
Linked List Cycle Detection: Floyd’s Tortoise & Hare Algorithm Explained
2026-09-08 · 23 min read
ভাবো, তুমি একটা Linked List traverse করছো। 10 → 20 → 30 → 40 → 50 → NULL. সব ঠিকঠাক। একসময় NULL আসবে, অর্থাৎ journey শেষ। কিন্তু যদি এমন হয়,
10 → 20 → 30 → 40 → 50
↑ ↓
← ← ← ← ← ← ←
তাহলে সমস্যা। তুমি হাঁটছো, হাঁটছো, হাঁটছো… কিন্তু destination-এ পৌঁছানোর কোনো নামগন্ধ নেই! কারণ Linked List-এর কোনো একটি next pointer আগের কোনো node-এ ফিরে গেছে। ফলে তৈরি হয়েছে Cycle। আজ আমরা শিখব কীভাবে এই cycle detect করা যায় এবং আরও interesting ব্যাপার, cycle ঠিক কোন node থেকে শুরু হয়েছে সেটাও বের করা যায়, কোনো extra array বা HashSet ছাড়াই।
প্রথমে সমস্যাটা পরিষ্কার করি
আমাদের কাছে একটি singly linked list আছে। প্রতিটি node-এর মধ্যে সাধারণত দুইটি জিনিস থাকেঃ
struct ListNode {
    int val;
    ListNode* next;
};
Normal linked list-এ শেষ node-এর next হলো NULL। কিন্তু cycle থাকলে কোনো এক node-এর next আবার আগের কোনো node-কে point করবে। উদাহরণঃ
1 → 2 → 3 → 4 → 5 → NULL
এখানে cycle নেই। অন্যদিকেঃ
1 → 2 → 3 → 4
    ↑       ↓
    ← ← ← ← ←
এখানে 4 → 2, তাই 2 → 3 → 4 → 2 ... একটি loop তৈরি করেছে।
সবচেয়ে সহজ সমাধানঃ HashSet
প্রথমে obvious solution দেখি। List traverse করার সময় প্রতিটি node একটি HashSet-এ রেখে দিই। যদি কোনো node-এ গিয়ে দেখি সেই একই node আগে দেখেছি, তাহলে cycle আছে। ধরোঃ
10 → 20 → 30 → 40 → 20 → ...
আমরা একে একে 10, 20, 30, 40 store করলাম। এরপর আবার 20 পেলাম। বুঝে গেলাম, এই node আগে এসেছিল।
Complexity
প্রতিটি node সর্বোচ্চ একবার visit করছি। তাই,
Time  = O(n)
Space = O(n)
Approach টি perfectly valid। কিন্তু interview বা resource-constrained environment-এ একটা প্রশ্ন আসবেঃ
“HashSet ছাড়া কি করা যায়?”
সেখানেই Floyd’s Algorithm enters the chat.
Floyd’s Cycle Finding Algorithm
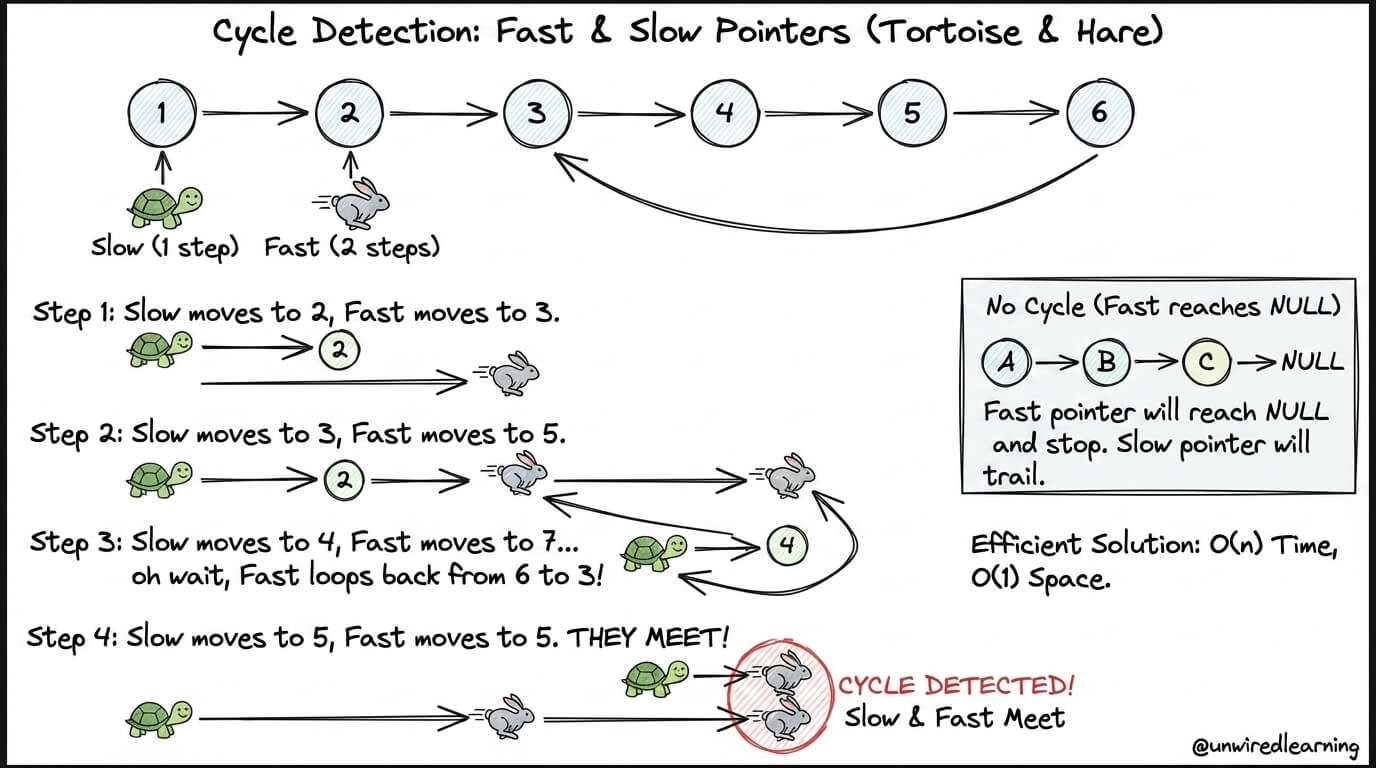
Floyd’s algorithm-কে অনেক সময় Tortoise and Hare Algorithm বলা হয়। কারণ এখানে আমরা দুইটি pointer ব্যবহার করব।
Slow / Tortoise → একবারে ১ node এগোয়।
Fast / Hare → একবারে ২ node এগোয়।
শুরুতে,
slow = head
fast = head
তারপরঃ
slow = slow->next
fast = fast->next->next
একই কাজ বারবার করতে থাকব।
কিন্তু দুই pointer কেন?
এটাই পুরো algorithm-এর মজাটা। ধরো কোনো cycle নেই।
1 → 2 → 3 → 4 → 5 → NULL
fast একসময় NULL-এ পৌঁছে যাবে। তাহলে বুঝব,
No Cycle
কিন্তু cycle থাকলে?
1 → 2 → 3 → 4 → 5
        ↑       ↓
        ← ← ← ← ←
এখন দুই pointer-ই একই circular path-এর মধ্যে ঘুরতে থাকবে। Fast এগোচ্ছে বেশি speed-এ। অর্থাৎ, cycle-এর মধ্যে একসময় fast slow-কে catch করবেই। তাই,
slow == fast
হলে আমরা নিশ্চিত হতে পারি যে cycle আছে।
বাস্তব উদাহরণে দেখি
ধরো আমাদের list:
3 → 2 → 0 → -4
    ↑        ↓
     ← ← ← ← ←
অর্থাৎ -4 আবার 2-কে point করছে। এখন pointer movement দেখি। শুরুতে,
slow = 3
fast = 3
এক iteration পরে,
slow = 2
fast = 0
আরেকবার,
slow = 0
fast = 2
আরও এগোলে একসময়ঃ
slow = -4
fast = -4
দুই pointer একই node-এ। Boom! Cycle detected. এটা শুধু ধারণাগত উদাহরণ নয়; cycle-entry detection-এর এই pattern-ই আধুনিক coding-interview problem যেমন LeetCode 142-এ ব্যবহৃত হয়।
তাহলে Complexity কত?
এখানে Floyd algorithm-এর সবচেয়ে সুন্দর ব্যাপার।
Time  = O(n)
Space = O(1)
অর্থাৎ n যত বড়ই হোক, আমাদের আলাদা করে nটি node store করতে হচ্ছে না। শুধু কয়েকটি pointer দিয়েই কাজ শেষ। মূল source article-ও একই complexity উল্লেখ করেছে।
এবার আসল challenge: Cycle কোথা থেকে শুরু?
Cycle detect করা এক জিনিস। কিন্তু interview interviewer যদি বলে,
“Cycle আছে বুঝলাম। এবার cycle-এর প্রথম node return করো।”
তখন? এখানেই Floyd algorithm-এর দ্বিতীয় phase শুরু। ধরো,
A → B → C → D → E
        ↑       ↓
         ← ← ← ←
এখানে C হলো cycle-এর starting node। প্রথম phase-এ slow এবং fast cycle-এর ভেতর কোথাও গিয়ে দেখা করবে। কিন্তু সেই meeting point-ই cycle-এর start নয়। এটা খুব common mistake।
দ্বিতীয় phase-এর clever trick
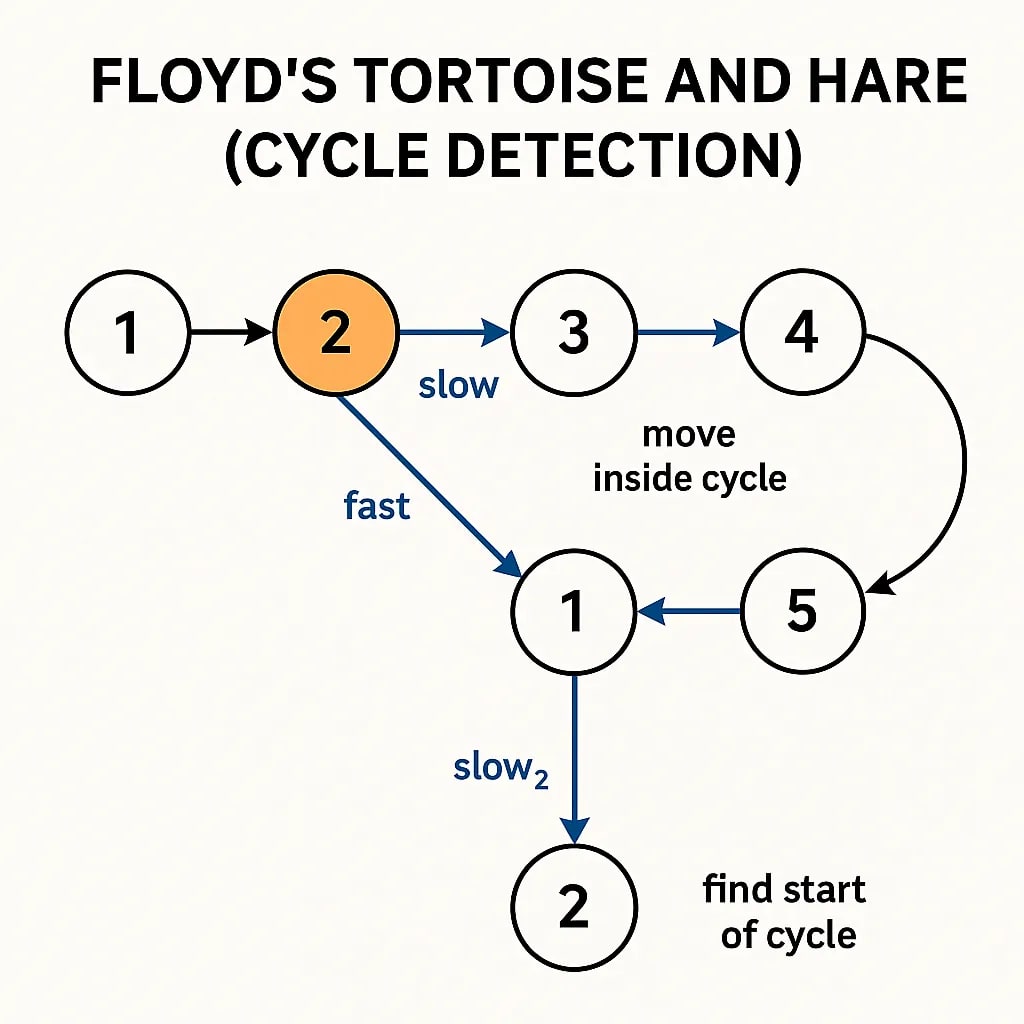
ধরো slow এবং fast cycle-এর ভেতরে কোথাও গিয়ে meet করেছে। এবার,
fast = head
করে দাও। Slow-কে meeting point-এই রাখো। এখন দুটোকেই একই speed-এ চালাও।
slow = slow->next
fast = fast->next
অর্থাৎ দুজনেই প্রতি iteration-এ মাত্র এক node এগোবে। কিছুক্ষণের মধ্যেই তারা একই node-এ meet করবে। আর সেই node-টাই হবে,
Cycle-এর প্রথম node।
কিন্তু এটা কাজ করে কেন?
এখানে সামান্য mathematics আছে। তবে ভয় পাওয়ার দরকার নেই। ধরো,
-
m= head থেকে cycle শুরু পর্যন্ত distance -
k= cycle start থেকে meeting point পর্যন্ত distance -
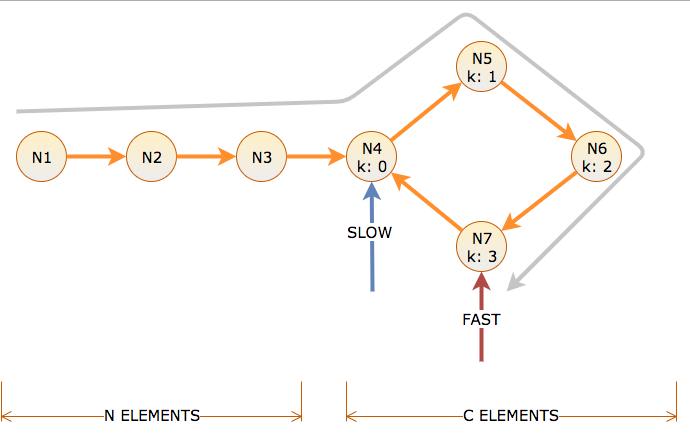
L= cycle-এর length
Slow যখন fast-এর সঙ্গে meet করে, তখন fast ধীর pointer-এর দ্বিগুণ distance অতিক্রম করেছে। তাই তাদের distance relationship থেকে পাওয়া যায়।
m + k = multiple of L
অর্থাৎ cycle-এর ভেতরে meeting point থেকে head-এর দিকে ঠিকমতো measure করলে এমন একটি relationship পাওয়া যায় যার কারণে head থেকে শুরু করা pointer এবং meeting point থেকে শুরু করা pointer cycle entry-তেই মিলবে। Source article-এও এই derivation-টির মূল relationship দেখানো হয়েছে। এখানে পুরো algebra মুখস্থ করার চেয়ে একটা intuition মনে রাখাই বেশি useful.
প্রথম collision আমাদের বলে cycle আছে।
দ্বিতীয় collision আমাদের বলে cycle কোথা থেকে শুরু।
এই দুই-step mental model-টাই interview-এর জন্য সবচেয়ে valuable।
Final Algorithm
এখন পুরো problem-টাকে মাত্র দুইটি phase-এ ভেঙে ফেলি।
Phase 1: Cycle Detect
slow → 1 step
fast → 2 steps

fast NULL হলে
    cycle নেই

slow == fast হলে
    cycle আছে
Phase 2: Cycle Entry Find
একটি pointer → head

অন্য pointer → meeting point

দুজনেই → 1 step করে

যেখানে meet করবে
সেটাই cycle start
Clean C++ Solution
struct ListNode {
    int val;
    ListNode* next;

    ListNode(int x) : val(x), next(nullptr) {}
};

ListNode* detectCycle(ListNode* head) {
    ListNode* slow = head;
    ListNode* fast = head;

    // Phase 1: Detect cycle
    while (fast != nullptr && fast->next != nullptr) {
        slow = slow->next;
        fast = fast->next->next;

        if (slow == fast) {
            break;
        }
    }

    // No cycle
    if (fast == nullptr || fast->next == nullptr) {
        return nullptr;
    }

    // Phase 2: Find cycle entry
    ListNode* entry = head;

    while (entry != slow) {
        entry = entry->next;
        slow = slow->next;
    }

    return entry;
}
একটা ছোট dry run
এই list-টি ধরোঃ
3 → 2 → 0 → -4
    ↑        ↓
    ← ← ← ← ←
প্রথম phase:
slow → ...
fast → ...
একসময়ঃ
slow == fast
মানে cycle নিশ্চিত। এখন,
entry = head
তারপরঃ
entry = entry->next
slow  = slow->next
এক step করে এগোতে থাকলে দুজন 2 node-এ মিলবে। সুতরাং,
Answer = node 2
এটি মূলত LeetCode-এর Linked List Cycle II problem-এর classic requirement-এর সঙ্গে মিলে যায়। cycle না থাকলে null, আর থাকলে entry node return করতে হবে।
Interview-এ যে ভুলগুলো সবচেয়ে বেশি হয়
slow == fast মানেই cycle-এর first node? না। এটি প্রথমে শুধু বলেঃ
A cycle exists.
Cycle entry বের করতে দ্বিতীয় phase চালাতে হবে। fast->next->next সরাসরি access করা যাবে? শুধু তখনই যখন,
fast != nullptr
fast->next != nullptr
চেক করা হয়েছে। নাহলে null pointer dereference হতে পারে।
HashSet ব্যবহার করা কি ভুল?
একেবারেই না। HashSet approach সহজ এবং readable:
O(n) time
O(n) space
Floyd:
O(n) time
O(1) space
Extra memory বাঁচাতে Floyd বেশি attractive।
শুধু Linked List-এর জন্যই কি?
না। Floyd’s Cycle Finding ধারণাটি এমন sequence-এর ক্ষেত্রেও ব্যবহার করা যায় যেখানে প্রতিটি state থেকে deterministic ভাবে পরের state বের করা যায়। Pseudo-random sequence এবং mathematical function-এর cycle analysis-এও এই technique ব্যবহৃত হতে পারে।
আর modern algorithm study-তে Floyd-এর পাশাপাশি Brent’s Cycle Detection Algorithm-ও গুরুত্বপূর্ণ। Brent-ও constant extra space ব্যবহার করে এবং কিছু ক্ষেত্রে next/successor evaluation কম করতে পারে; তবে সাধারণ linked list interview problem-এ Floyd-এর intuition ও implementation এখনও বেশি straightforward।
মনে রাখার সবচেয়ে সহজ Formula
পুরো article থেকে যদি মাত্র চারটি line মনে রাখতে চাওঃ
Slow  → 1 step
Fast  → 2 steps

Meet → Cycle exists

One pointer → Head
Both → 1 step

Meet again → Cycle entry
ব্যস। Tortoise ধীরে চলে, Hare দৌড়ায়। Cycle থাকলে Hare পালিয়ে যেতে পারে না। শেষ পর্যন্ত Tortoise-কে ধরবেই।
Practice Challenge
Algorithm টা সত্যিই বুঝেছো কি না পরীক্ষা করতে নিজে solve করোঃ
LeetCode 141: Linked List Cycle → শুধু cycle আছে কি না বের করো।
LeetCode 142: Linked List Cycle II → cycle-এর starting node বের করো।
আরও challenge হিসেবে UVa 350 - Pseudo-Random Numbers দেওয়া যায়।