#css-architecture #responsive-design #legacy-migration #debugging-methodology #scope-discipline #dry-principle #dependency-injection #layered-architecture #race-conditions #async-javascript #api-design #http-semantics #sql-join-cardinality #defense-in-depth-validation #immutability #technical-decision-documentation #strangler-fig-pattern
একটি প্রোডাকশন কোডবেস থেকে ১২টি সফটওয়্যার ইঞ্জিনিয়ারিং Lesson: CSS Cascade থেকে Race Condition পর্যন্ত
2026-08-06 · 57 min read
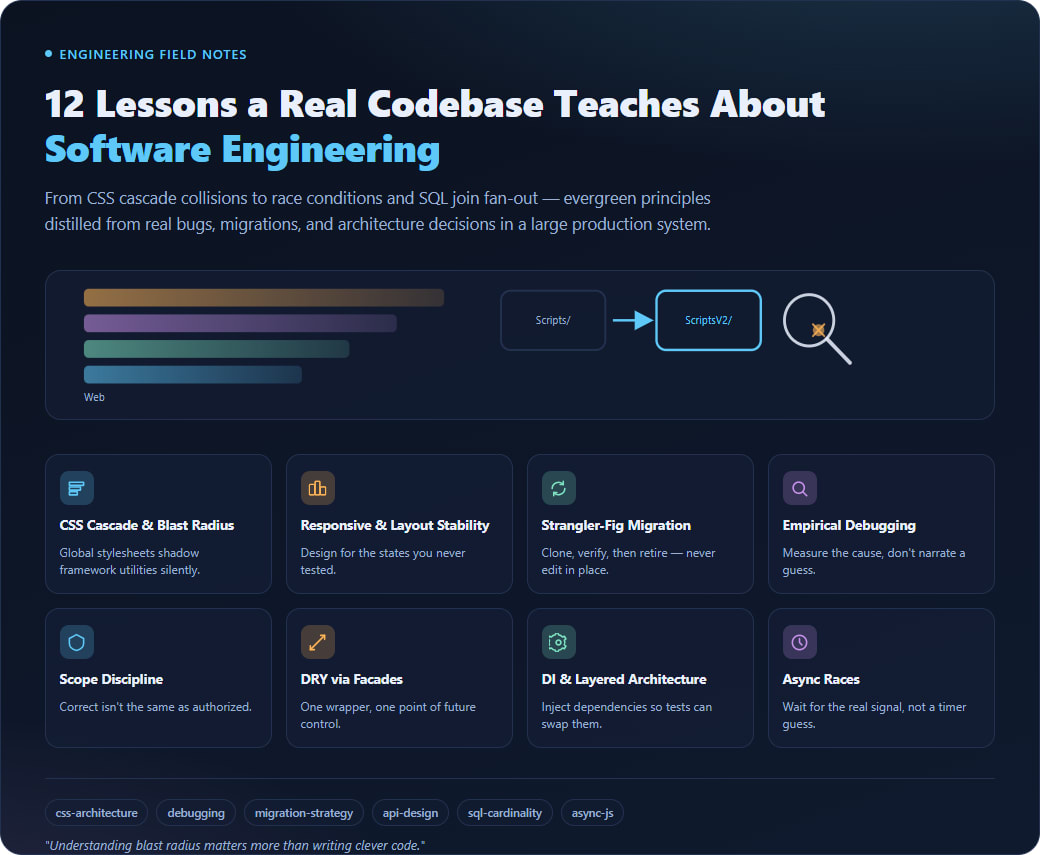
ভূমিকা
একটা বড়, বহু বছরের পুরনো ERP সিস্টেমে (একসাথে admin dashboard, student portal, teacher portal, আর desktop app চলছে এমন একটা multi-tier platform) কাজ করলে প্রতিদিনই ছোট-বড় বাগ, migration decision, আর architecture trade-off সামনে আসে। এই লেখাটা কোনো নির্দিষ্ট প্রজেক্টের work-log না — বরং সেই কাজগুলোর ভেতরে লুকিয়ে থাকা general software engineering principle-গুলো বের করে আনার চেষ্টা। প্রতিটা topic-এর পেছনে একটা বাস্তব ঘটনা (bug বা decision) আছে, কিন্তু শেখার জিনিসটা যেকোনো codebase-এ, যেকোনো stack-এ প্রযোজ্য।
যারা ছোট personal project থেকে বড় production system-এ move করছেন, তাদের জন্য এই লেখাটা একটা roadmap হতে পারে — কোন ধরনের ভুলগুলো সবচেয়ে বেশি হয়, আর experienced engineer-রা কীভাবে সেগুলো এড়ান।
প্রতিটা technical term প্রথমবার আসার সাথে সাথে সহজ ভাষায় বোঝানো হয়েছে, যাতে prior experience ছাড়াই পড়া যায়।
১. CSS Cascade, Specificity, আর Shared Stylesheet-এর Blast Radius
এটা আসলে কী:
Browser যখন একটা element-এ style apply করে, তখন একাধিক CSS rule একই element-কে target করতে পারে। কোন rule "জিতবে" সেটা ঠিক হয় specificity (rule কতটা "নির্দিষ্ট" — যেমন .my-class vs #my-id vs element-এর inline style) আর source order (একই specificity হলে, যেটা পরে load হয়েছে সেটা জেতে) দিয়ে। এটাকে ভাবুন এভাবে — একটা অফিসে দুইজন ম্যানেজার যদি একই কর্মচারীকে ভিন্ন নির্দেশ দেয়, তাহলে যেই নির্দেশ শেষে দেওয়া হয়েছে (বা যার পদমর্যাদা বেশি) সেটাই কার্যকর হয়।
কেন এটা সমস্যা হয়ে ওঠে:
বড় codebase-এ CSS ফাইল বিভিন্ন যুগে লেখা হয় — পুরনো framework (এখানে Bootstrap 3) compatibility-র জন্য লেখা rule, নতুন framework (Bootstrap 5)-এর utility class, আর site-wide custom CSS — সব একসাথে load হয়। বাস্তব উদাহরণ: এই প্রজেক্টে একটা shared CSS ফাইলে (site-2.1.css) ছিল —
.d-none {
  display: none !important;
}
কোনো media query ছাড়া, unconditionally। Bootstrap 5-এর নিজস্ব responsive utility (.d-md-block, .d-lg-flex) গুলোও !important ব্যবহার করে, কিন্তু সেগুলো @media block-এর ভেতরে থাকে। যেহেতু site-এর CSS ফাইলটা Bootstrap-এর পরে load হয়, একই specificity হওয়া সত্ত্বেও এই unconditional rule-টাই সবসময় জিতে যাচ্ছিল — মানে class="d-none d-md-block" লেখা element কখনোই desktop-এ দেখা যাচ্ছিল না। এই একই codebase-এ আরেকটা উদাহরণ ছিল bs3-compat.css-এ, যেখানে .form-horizontal [class*="col-"] selector unconditionally float: left বসিয়ে দিচ্ছিল — ফলে base-tier class (col-12) ছাড়া শুধু col-md-4 লেখা কোনো column, mobile-এ width ছাড়াই float হয়ে শুধু নিজের content-এর সমান জায়গা নিচ্ছিল (shrink-to-fit দেখাচ্ছিল, full-width স্ট্যাক হচ্ছিল না)।
Beginner-রা সাধারণত যে ভুল করে:
- ধরে নেয় যে একটা well-known framework-এর utility class "সবসময় কাজ করবে," তাই আগে সেটাকে সন্দেহ করে না — বদলে typo বা অন্য কিছু খুঁজতে সময় নষ্ট করে।
- সমস্যা ধরার জন্য শুধু চোখে দেখে অনুমান করে, ব্রাউজারের DevTools-এ actual computed style চেক করে না।
- একটা page-এ quick fix করার জন্য সরাসরি shared/global CSS ফাইল এডিট করে ফেলে — না বুঝেই যে সেই ফাইল আরও অনেক page-এ load হয়।
ভালো Engineering Approach:
- সমস্যা হলে প্রথমেই DevTools-এর "Computed" ট্যাবে যান — কোন rule জিতেছে আর কোথা থেকে এসেছে, সেটা সরাসরি দেখা যায়, অনুমান লাগে না।
- কখনোই framework-এর built-in utility class-এর নাম (
d-none,row,col-*,mt-2) নিজের custom CSS selector-এ ব্যবহার করবেন না override করার জন্য — এতে পুরো design system-এর predictability নষ্ট হয়। যদি একটা utility class-এর effect বদলাতে হয়, JS দিয়ে সেই class DOM থেকে remove করুন, CSS দিয়ে override না করে। - Shared/global ফাইল এডিট করার আগে ভাবুন — এই ফাইল কয়টা page load করে? সেই সব page-এ কি এই পরিবর্তন safe? না হলে page-level scope-এ ফিক্স করুন (যেমন নির্দিষ্ট class যোগ করে), global ফাইল অক্ষত রাখুন।
যেভাবে আগেভাগে ধরা যায়: কোনো utility class "মাঝে মাঝে কাজ করে না" মনে হলে, প্রথমেই জিজ্ঞেস করুন — এই selector-কে target করা আর কোনো global CSS ফাইলে আছে কি? সব CSS ফাইলে grep করুন, শুধু যে ফাইলে কাজ করছেন সেটায় না।
বড় শিক্ষা: "Global" CSS আসলে একটা shared mutable resource — যেকোনো shared resource-এর মতোই, এখানে করা যেকোনো পরিবর্তনের blast radius (প্রভাবের ব্যাপ্তি) পুরো অ্যাপ জুড়ে। Legacy layer গুলো (এখানে BS3-era rule) নতুন কোডের সাথে নীরবে conflict করতে পারে, যতক্ষণ না নির্দিষ্ট combination ব্যবহার হয়।
২. UI ডিজাইন করুন সেই State-গুলোর জন্য যেগুলো আপনি টেস্ট করেননি
এটা আসলে কী:
Responsive design মানে শুধু "ছোট স্ক্রিনে ঠিকঠাক দেখানো" না — এটা একটা tier-based system, যেখানে base tier (সবচেয়ে ছোট screen-এর জন্য default, যেমন Bootstrap-এ bare col-12) সবসময় প্রযোজ্য থাকে, আর প্রতিটা breakpoint tier (col-md-*, col-lg-*) শুধু সেই breakpoint থেকে উপরে গিয়ে override করে। একইভাবে, dynamic content-এর জন্য layout ডিজাইন করার সময় ভাবতে হয় সেই content-এর সবচেয়ে বড় (worst-case) অবস্থাটা কেমন দেখাবে, শুধু default অবস্থা না।
কেন এটা সমস্যা হয়ে ওঠে: দুটো ভিন্ন বাস্তব উদাহরণ একই মূলনীতি প্রমাণ করে:
১) Breakpoint omission bug: এই প্রজেক্টে কোনো <label class="control-label col-md-4"> — শুধু col-md-4 লেখা, col-12 ছাড়া — legacy bs3-compat.css-এর unconditional float rule-এর সাথে মিলে mobile-এ shrink হয়ে যাচ্ছিল। ঠিক করার সঠিক উপায় ছিল global CSS ফাইল বদলানো না, বরং সেই নির্দিষ্ট page-এ explicit base-tier class যোগ করা: class="control-label col-12 col-md-4 text-start text-md-end"।
২) Layout shift on dynamic content: Form-এর একটা row-তে label আর input পাশাপাশি align করার জন্য align-items-center ব্যবহার করা হয়েছিল। এটা row-এর সবচেয়ে লম্বা column-এর সাথে বাকি সব column-কে vertically center করে। কিন্তু যখন কোনো field-এ validation error message দেখানো হয় (input + error text মিলে column লম্বা হয়ে যায়), তখন centering পুরো row-র label-input alignment-কে (এমনকি sibling column-গুলোরও) ভেঙে দিচ্ছিল। শুধু "happy path" (কোনো error ছাড়া) টেস্ট করলে এই বাগ কখনোই ধরা পড়বে না।
Beginner-রা সাধারণত যে ভুল করে:
- ভাবে "framework নিজেই responsive হ্যান্ডেল করবে," তাই base-tier class বাদ দেওয়া নিরাপদ মনে করে।
- শুধু default/happy-path render টেস্ট করে — error state, loading state, বা expanded state কখনো trigger করে দেখে না।
- ধরে নেয় যে যদি production-এ কোনো library (Bootstrap-এর মতো) ব্যবহার হয়, তার behavior সবসময় predictable থাকবে, legacy override-এর সম্ভাবনা মাথায় রাখে না।
ভালো Engineering Approach:
- Mobile-first thinking মেনে চলুন: সবসময় base-tier (
col-12) explicitly লিখুন, তারপর তার উপরে breakpoint tier layer করুন — কখনো barecol-md-*একা রাখবেন না। - যেকোনো row/container ডিজাইন করার সময় জিজ্ঞেস করুন: "এই row-এর ভেতরে কোনো element কি runtime-এ height বদলাতে পারে?" যদি হ্যাঁ হয় (validation message, expandable text, loading spinner) তাহলে default হিসেবে
align-items-startব্যবহার করুন,align-items-centerনয়। - QA/testing-এর সময় ইচ্ছাকৃতভাবে edge state trigger করুন — একটা required field খালি রেখে submit করুন, mismatched date range দিন — শুধু ভালো data দিয়ে টেস্ট করবেন না।
যেভাবে আগেভাগে ধরা যায়: সবচেয়ে ছোট viewport width (যেমন ৩৭৫px) দিয়ে প্রথমে টেস্ট করুন, সবার শেষে না। আর যেকোনো form-এর জন্য: validation trigger করে দেখুন layout ভাঙে কিনা।
বড় শিক্ষা: এই দুইটা বাগের মূলনীতি একই — একটা UI component-এর "normal" অবস্থা দেখে সিদ্ধান্ত নেওয়া বিপজ্জনক। প্রকৃত ডিজাইন সিদ্ধান্ত নিতে হয় সেই component-এর সম্ভাব্য সব state (ছোট screen, error state, খালি state, ওভারফ্লো state) কল্পনা করে।
৩. নিরাপদ Migration Strategy: "ক্লোন করো, মুছো না" (Strangler Fig Pattern)
এটা আসলে কী: বড় কোনো সিস্টেমকে এক ধাক্কায় পুরোপুরি নতুন করে লেখা (big-bang rewrite) অত্যন্ত ঝুঁকিপূর্ণ — পুরো অ্যাপ একসাথে ভেঙে যেতে পারে, আর rollback করাও কঠিন। এর বিকল্প হলো Strangler Fig Pattern — পুরনো সিস্টেমকে অক্ষত রেখে, তার পাশে ধীরে ধীরে নতুন অংশ তৈরি করা, আর একটা একটা করে view/module নতুনটার দিকে সরানো। এটা অনেকটা মানুষ থাকা অবস্থায় একটা বাড়ি রুম-বাই-রুম renovate করার মতো — পুরো বাড়ি ভেঙে আবার বানানোর বদলে।
কেন এটা সমস্যা হয়ে ওঠে:
এই প্রজেক্টের frontend migration-এ (Bootstrap 3 থেকে 5, jQuery library upgrade) এই নীতিটা খুব স্পষ্টভাবে প্রয়োগ হয়েছে: wwwroot/Scripts/ আর wwwroot/Content/ ফোল্ডারের কোনো existing ফাইল কখনো সরাসরি এডিট করা হয়নি — বরং ScriptsV2//ContentV2/-এ একই folder structure মেনে clone করে, সেই clone-টাই মডিফাই করে, আর view-তে পুরনো <script>/<link> reference comment করে নতুন V2 path যোগ করা হয়েছে। এতে rollback সবসময় এক লাইন uncomment করার মতোই সহজ থাকে, আর পুরনো ফাইল কখনো "accidentally" ভেঙে যায় না।
এর একটা সহজাত সমস্যা হলো আংশিক migration — একটা view "migrate" হয়েছে বলে মার্ক করা হলো, কিন্তু আসলে কিছু জায়গায় এখনো পুরনো library-র active call রয়ে গেছে। এই প্রজেক্টের নিয়ম ছিল: কোনো library migrate করলে সেই Area-র সব applicable ফাইলে সম্পূর্ণভাবে apply করতে হবে, একটাও "পরে করব" বলে বাদ রাখা যাবে না — কারণ আংশিক migration মানে runtime behavior inconsistent হয়ে যায় এবং বাগ ধরা কঠিন হয়ে ওঠে।
আরেকটা related সমস্যা: migration-এর progress ট্র্যাক করার জন্য বানানো একটা document-এ প্রতিটা Area-র checklist টেবিল ছিল, কিন্তু বাস্তবে সেই টেবিলের কোনো বক্সই কখনো টিক দেওয়া হয়নি — যদিও git commit history অনুযায়ী প্রচুর real migration কাজ হয়ে গিয়েছিল। ডকুমেন্ট বাস্তবতা থেকে "drift" (সরে) হয়ে গিয়েছিল।
Beginner-রা সাধারণত যে ভুল করে:
- মনে করে "শুধু এডিট করে ফেলি, git history-ই তো backup" — কিন্তু production-এ কোনো সমস্যা হলে দ্রুত rollback করা (একটা comment uncomment করা) এবং পুরনো commit থেকে revert করা — এই দুটোর গতি ও ঝুঁকি সম্পূর্ণ ভিন্ন।
- একটা library-র কিছু জায়গায় migrate করে বাকিটা "পরে" রেখে দেয় — ভুলে যায় সেই "পরে" আসলে কখনো আসে না।
- planning document/checklist-কে "live status" ধরে নেয়, actual code state যাচাই না করেই সিদ্ধান্ত নেয়।
ভালো Engineering Approach:
- Migration-এর সময় পুরনো ও নতুন — দুটোই সমান্তরালে (parallel path) রাখুন, পুরনোটা untouched থাকুক যতক্ষণ না নতুনটা সম্পূর্ণ verified।
- একটা Area-তে কাজ শুরুর আগে scan করুন কোন কোন ফাইলে কোন library ব্যবহার হচ্ছে; শেষে verify করুন কোথাও পুরনো library-র uncommented/active call বাকি নেই।
- Progress-tracking document-কে সবসময় "static plan," "live status" নয় হিসেবে treat করুন — আসল progress জানতে
git log, actual file content, আর view-এর layout reference চেক করুন।
যেভাবে আগেভাগে ধরা যায়: একটা ফাইলে grep করে দেখুন পুরনো আর নতুন library reference একসাথে আছে কিনা (একটাও থাকলে সেটা partial migration-এর সংকেত)। আর কোনো tracking document আর actual git history-র মধ্যে mismatch দেখলে সেটাকেই সত্যি ধরুন, document-কে না।
বড় শিক্ষা: বড় migration-এ নিরাপত্তা আসে গতি থেকে না, বরং reversibility (সহজে ফিরে আসার ক্ষমতা) আর verifiability (যাচাইযোগ্যতা) থেকে। আর Documentation কোডের চেয়ে দ্রুত "পচে" যায় — যেকোনো সিদ্ধান্তের ক্ষেত্রে running code/repo state-কেই চূড়ান্ত সত্য ধরুন।
৪. Empirical Debugging: অনুমান নয়, প্রমাণ
এটা আসলে কী: Empirical debugging মানে হলো — কোনো bug-এর কারণ সম্পর্কে একটা প্লজিবল (বিশ্বাসযোগ্য শোনানো) গল্প বানিয়ে সেটাকেই সত্যি ধরে নেওয়ার বদলে, actual measurement (browser-এর computed style, DOM element-এর অবস্থান, A/B comparison) দিয়ে cause-and-effect প্রমাণ করা।
কেন এটা সমস্যা হয়ে ওঠে: এই প্রজেক্টে দুটো ঘটনা এই নীতিটা স্পষ্ট করে:
১) কোনো এক পর্যায়ে ধারণা করা হয়েছিল যে Bootstrap modal খোলা-বন্ধ করার সময় page content "jump" (হঠাৎ shift) করে, আর তার সমাধান হিসেবে html { scrollbar-gutter: stable; } একটা global rule হিসেবে যোগ করা হয়েছিল — কিন্তু আসল সমস্যাটা কখনো বাস্তবে reproduce করে দেখা হয়নি। ফলাফল: ছোট (non-scrolling) page-গুলোতে ডান পাশে একটা স্থায়ী ফাঁকা জায়গা/লাইন দেখা যেতে থাকে — real user report আসার পরে ধরা পড়ে। পরে A/B testing করে (production-এর সাথে তুলনা, আর একটা reference element-এর getBoundingClientRect() অবস্থান modal open/close-এর আগে-পরে মেপে) প্রমাণ হয় যে Bootstrap 5.3.8 নিজেই ইতিমধ্যে এই সমস্যার সমাধান করে (body-তে padding-right যোগ করে) — অর্থাৎ আগের "ফিক্স"টা আসলে একটা কাল্পনিক সমস্যার জন্য একটা বাস্তব রিগ্রেশন তৈরি করেছিল, এবং Bootstrap-এর নিজস্ব compensation-এর সাথে conflict করছিল।
২) পুরনো (migration-এর আগের) কোনো behavior জানতে গিয়ে in-file [MIGRATION ...] comment-এর উপর ভরসা করা হয়েছিল — কিন্তু সেই comment গুলো ছিল multi-line আসল কোডের সংক্ষিপ্ত, lossy paraphrase, verbatim কপি না। আসল old logic জানতে development branch-এর actual code (git diff development -- <path>) চেক করাই একমাত্র নির্ভরযোগ্য উপায় ছিল।
Beginner-রা সাধারণত যে ভুল করে:
- একটা "সম্ভাব্য" সমস্যার জন্য preventive fix বসিয়ে দেয়, না জেনেই যে সেই সমস্যাটা বাস্তবে ঘটে কিনা।
- Comment/description-কে actual source code-এর বিকল্প হিসেবে বিশ্বাস করে — ভুলে যায় যে মানুষ যা লেখে তা প্রায়ই lossy summary, সম্পূর্ণ সত্য না।
- নিজের hypothesis-কে সত্যি বলে ধরে নেয় যদি সেটা "যুক্তিসঙ্গত" শোনায়, actual measurement ছাড়াই।
ভালো Engineering Approach:
- কোনো fix লেখার আগে, সেই সমস্যাটা প্রথমে বাস্তবে reproduce করুন এবং measure করুন (উদাহরণ: real modal খুলে element position মাপা)। fix না থাকলে সমস্যাটা সত্যিই ঘটে কিনা, সেটা যাচাই না করে fix লেখা মানে অন্ধকারে ঢিল ছোঁড়া।
- "পুরনো behavior কেমন ছিল" জানতে হলে সবসময় authoritative source (main/production branch)-এর actual diff দেখুন, paraphrased comment বা feature-branch-এর নিজস্ব history-র উপর একা নির্ভর করবেন না।
যেভাবে আগেভাগে ধরা যায়: নিজেকে জিজ্ঞেস করুন: "এই fix-টার comment-এ যা লেখা আছে (যেমন 'prevents X'), আমি কি সত্যিই fix ছাড়া X ঘটতে দেখেছি?" যদি উত্তর "না" হয়, সেটা একটা diagnosis না, একটা অনুমান মাত্র।
বড় শিক্ষা: "Trust, but verify" শুধু অন্যের claim-এর জন্য না — নিজের hypothesis-এর জন্যও সমান প্রযোজ্য। ভালো ডিবাগার প্রমাণ তৈরি করে, গল্প বলে না।
৫. রিফ্যাক্টরের সময় Scope Discipline ও Blast Radius বিবেচনা
এটা আসলে কী: Scope discipline মানে হলো ঠিক ততটুকুই করা যতটুকু authorize করা হয়েছে — "যখন এখানেই আছি, এটাও ঠিক করে দিই" — এই প্রলোভন এড়ানো। Blast radius মানে একটা পরিবর্তন কতগুলো জায়গায়, কতজন মানুষকে প্রভাবিত করতে পারে সেটা বোঝা।
কেন এটা সমস্যা হয়ে ওঠে: এই প্রজেক্টে একটা টাস্ক ছিল: একটা "reference/source-of-truth" area (A) থেকে UI অন্য একটা "target" area (B)-তে পোর্ট করা। কাজ করতে গিয়ে দেখা যায় A-এর নিজের কিছু ফাইলে ("gold standard" হিসেবে ধরে নেওয়া) আসলে migrate-না-হওয়া পুরনো markup রয়ে গেছে। যুক্তি ছিল "known-broken pattern আবার propagate করবো কেন" — তাই A সরাসরি ঠিক করে দেওয়া হয়। কিন্তু user-এর প্রতিক্রিয়া ছিল স্পষ্ট: task-এর authorization ছিল শুধু target area-র জন্য, source area touch করার অনুমতি ছিল না — এমনকি genuine bug হলেও। সঠিক sequence হওয়া উচিত ছিল: gap খুঁজে পাওয়া → user-কে জানানো → scope বাড়ানো হবে কিনা user-কে সিদ্ধান্ত নিতে দেওয়া।
একই নীতি shared global CSS ফাইল (আগের উদাহরণের bs3-compat.css, site-2.1.css) এডিট না করার সিদ্ধান্তেও দেখা যায় — কারণ সেই ফাইল বদলালে ইতিমধ্যে verified হওয়া অনেক page-এ অনিচ্ছাকৃত পরিবর্তন আসতে পারে।
Beginner-রা সাধারণত যে ভুল করে:
- মনে করে "সঠিক জিনিস করাই যথেষ্ট" — task-এর boundary-র বাইরে গিয়ে fix করাটাকে productive মনে করে, কিন্তু ভুলে যায় যে এতে unreviewed risk ছড়িয়ে পড়ে।
- Diagnose করা আর fix করা — এই দুটো কাজকে একই authorization-এর আওতায় ধরে নেয়, যদিও এদের ঝুঁকি সম্পূর্ণ ভিন্ন (diagnose করলে কিছু ভাঙে না, fix করলে ভাঙতে পারে)।
ভালো Engineering Approach:
- যেকোনো ফাইল এডিট করার আগে জিজ্ঞেস করুন: "এই ফাইলটা কি originally task-এর অংশ ছিল?" আর "এই পরিবর্তন কি task-এর বাইরে কোথাও প্রভাব ফেলতে পারে?"
- Investigation (root cause খুঁজে বের করা, পড়া, log দেখা) সবসময় করা যায় — কিন্তু কোনো fix apply করার আগে, scope-এর বাইরে হলে থামুন এবং জিজ্ঞেস করুন।
যেভাবে আগেভাগে ধরা যায়: নিজেকে জিজ্ঞেস করুন — "diff-এ যে ফাইলগুলো দেখাচ্ছে, সবগুলো কি user যা চেয়েছিল তার অংশ?" কোনো unexpected ফাইল diff-এ দেখলে সেটা একটা red flag।
বড় শিক্ষা: "সঠিক" আর "অনুমোদিত" — এই দুটো এক জিনিস না। একটা technically correct fix যদি authorization-এর বাইরে গিয়ে করা হয়, সেটা তবু সমস্যা তৈরি করে — কারণ তাতে surprise আসে, review ছাড়া risk যোগ হয়।
৬. DRY আর Facade/Wrapper Pattern দিয়ে Component Architecture
এটা আসলে কী: DRY (Don't Repeat Yourself) নীতি বলে — একই logic বারবার copy-paste না করে একটাই জায়গায় রাখা উচিত। Facade/wrapper pattern মানে হলো একটা third-party library-র সরাসরি API না ডেকে, তার উপরে নিজেদের একটা পাতলা layer বসানো — যাতে সেই library-র defaults, locale, বা behavior এক জায়গা থেকেই নিয়ন্ত্রণ করা যায়।
কেন এটা সমস্যা হয়ে ওঠে:
এই প্রজেক্টে date picker-এর ক্ষেত্রে raw library function (flatpickrWithDrilldown()) সরাসরি না ডেকে, umsDatepicker() নামে একটা wrapper function তৈরি করা হয়েছিল, যেটা defaults-এর সাথে caller-এর extra options merge করে। কারণ ব্যাখ্যা করা হয়েছিল: ভবিষ্যতে locale/default পরিবর্তন করতে হলে যেন একটা জায়গায় বদলালেই পুরো অ্যাপে reflect হয়, প্রতিটা view আলাদা করে বদলাতে না হয়। একইভাবে, প্রতিটা নতুন library বা custom snippet-এর জন্য একটা dedicated ContentV2/<name>/ ফোল্ডার (নিজস্ব .js + .css সহ) তৈরির নিয়ম করা হয়েছিল — যাতে সেটা পুরোপুরি self-contained ও reusable থাকে, layout ফাইলে ছড়িয়ে-ছিটিয়ে inline code না থাকে। আর কোনো pattern (script tag, CSS link, HTML block) ৩+ ফাইলে repeat হলে সেটাকে Razor Partial View-তে extract করার নিয়মও ছিল একই যুক্তিতে।
Beginner-রা সাধারণত যে ভুল করে:
- একটা library init snippet প্রতিটা নতুন view-তে copy-paste করে, "তাড়াতাড়ি হবে" ভেবে — কিন্তু একটা default value বদলাতে হলে প্রতিটা জায়গায় খুঁজে বদলাতে হয়, একটাও মিস হলে inconsistency তৈরি হয়।
- Third-party library-র function সরাসরি সব জায়গায় কল করে, কোনো wrapper ছাড়াই — ফলে সেই library বদলাতে বা upgrade করতে গেলে পুরো codebase জুড়ে খোঁজ চালাতে হয়।
ভালো Engineering Approach:
- কোনো widely-used library (date picker, table, editor) প্রথমবার ব্যবহারের সময়ই একটা wrapper function/module বানিয়ে ফেলুন — "৩ বার ব্যবহার হলে তখন extract করব" ভাবার দরকার নেই এমন library-র ক্ষেত্রে, কারণ সেগুলো প্রায় নিশ্চিতভাবেই ব্যাপকভাবে ব্যবহৃত হবে।
- Markup/config-এর মতো repeat হওয়া pattern-এর জন্য একটা threshold (যেমন ৩ বার) ঠিক করুন, তারপর shared partial-এ move করুন।
যেভাবে আগেভাগে ধরা যায়: কোনো third-party function name সরাসরি অনেকগুলো ফাইলে grep করে পাওয়া গেলে (একটা central wrapper module-এর বদলে), সেটা ভবিষ্যতের maintenance সমস্যার আগাম সংকেত।
বড় শিক্ষা: DRY-এর আসল মূল্য "কম লাইন কোড" না — এর আসল মূল্য হলো ভবিষ্যতের পরিবর্তনের জন্য একটাই নিয়ন্ত্রণ বিন্দু তৈরি করা। External dependency-কে wrap করে রাখা, পরবর্তী breaking change বা requirement বদলের বিরুদ্ধে সস্তা বীমা।
৭. Layered Architecture ও Dependency Injection — Testability-র জন্য ডিজাইন
এটা আসলে কী: Layered/N-tier architecture মানে সিস্টেমকে স্তরে ভাগ করা (এখানে: DAO → Service → Cache → Web), যেখানে প্রতিটা স্তর শুধু তার ঠিক নিচের স্তরের সাথে কথা বলে, লাফ দিয়ে অন্য স্তর ব্যবহার করে না। Dependency Injection (DI) মানে একটা object তার dependency (যেমন database access) নিজে ভেতরে তৈরি না করে, বাইরে থেকে (constructor-এর মাধ্যমে) গ্রহণ করে — এতে সেই dependency-কে সহজে বদলে ফেলা যায় (যেমন test-এর সময় real database-এর বদলে একটা fake বসানো)।
কেন এটা সমস্যা হয়ে ওঠে:
যদি কোনো class-এর ভেতরে new SomeDao() লেখা থাকে, তাহলে সেই class-কে real database ছাড়া unit test করা প্রায় অসম্ভব — কারণ class-টা একটা নির্দিষ্ট concrete implementation-এর সাথে "ঝালাই" হয়ে গেছে। এই প্রজেক্টে এই সমস্যার সমাধান হিসেবে একটা dual constructor convention আছে: Service class একদিকে ISession + DAO/Service interface গ্রহণ করা একটা DI constructor রাখে (production ও test — দুই ক্ষেত্রেই ব্যবহারযোগ্য), আবার সেই সাথে একটা legacy constructor-ও রাখে যেটা ভেতরে dependency new করে নেয়। এটা একটা transitional/coexistence pattern — পুরনো call site গুলো না ভেঙে, নতুন কোডকে cleanly testable রাখার সমঝোতা।
Beginner-রা সাধারণত যে ভুল করে:
- মনে করে constructor-এর ভেতরে
new SomeService()লেখা "সহজ" — বুঝতে পারে না এতে সেই class future-এ mock/fake দিয়ে test করা যাবে না। - Legacy codebase-এ DI retrofit করতে গিয়ে সব caller একসাথে বদলাতে চায় — এটা একটা risky big-bang পরিবর্তন হয়ে যায়।
ভালো Engineering Approach:
- Dependency-কে interface হিসেবে constructor parameter-এ গ্রহণ করুন, concrete class হিসেবে না।
- বিদ্যমান legacy codebase-এ DI ঢোকাতে হলে, dual-constructor-এর মতো একটা coexistence approach ব্যবহার করুন — নতুন কোড clean থাকবে, কিন্তু পুরনো caller-দের একসাথে rewrite করতে হবে না।
যেভাবে আগেভাগে ধরা যায়:
কোনো class-এর মেথডের ভেতরে new SomeService(...) বা new SomeDao(...) খুঁজে পেলে বুঝবেন — সেই class real dependency ছাড়া unit-test করা যাবে না।
বড় শিক্ষা: Dependency Injection মূলত এই প্রশ্নের উত্তর নিয়ন্ত্রণ করা — "একটা object তার সহযোগী (collaborator) কোথা থেকে পায়?" এই নিয়ন্ত্রণটাই automated testing আর নিরাপদ refactoring সম্ভব করে তোলে। Legacy code-এ এটা প্রবর্তন করা একটা ধীর, সহাবস্থান-ভিত্তিক প্রক্রিয়া, এক ধাক্কায় rewrite না।
৮. Asynchronous Programming: সঠিক Signal-এর জন্য অপেক্ষা করুন, অনুমানের জন্য না
এটা আসলে কী: Asynchronous (async) code হলো এমন কাজ যেটা সম্পূর্ণ হতে সময় লাগে (font load হওয়া, network request) এবং বাকি প্রোগ্রাম তার জন্য না থেমে চলতে থাকে — Promise/callback দিয়ে "কাজ শেষ হলে জানিও" বলে রাখা হয়। Race condition হলো এমন একটা বাগ যেখানে দুটো async কাজ কে আগে শেষ হবে তার উপর ফলাফল নির্ভর করে — মানে ফলাফল অনির্দিষ্ট (কখনো ঠিক, কখনো ভুল)।
কেন এটা সমস্যা হয়ে ওঠে: এই প্রজেক্টে math equation রেন্ডার করার জন্য MathJax library ব্যবহার হয়, আর সেই সাথে একটা custom font (SutonnyMJ, পুরনো Bijoy-encoded Bangla টেক্সট সঠিকভাবে দেখানোর জন্য) দরকার হয়। মূল সমস্যা ছিল — MathJax "typeset" (equation-কে visual output-এ রূপান্তর) শুরু করে দিচ্ছিল, custom font browser-এ পুরোপুরি load হওয়ার আগেই। ফলে stretchy arrow-এর মতো symbol, যাদের সাইজ font-এর actual metrics-এর উপর নির্ভর করে ক্যালকুলেট হয়, ভুল সাইজে রেন্ডার হচ্ছিল — কারণ browser তখনো fallback font ব্যবহার করছিল measurement-এর জন্য।
সমাধান ছিল browser-এর document.fonts.load('16px SutonnyMJ') (একটা Promise যেটা resolve হয় font আসলেই ব্যবহারযোগ্য হলে) দিয়ে explicitly অপেক্ষা করা, তারপরেই typeset শুরু করা:
var fontReady = (document.fonts && document.fonts.load)
    ? document.fonts.load('16px SutonnyMJ')['catch'](function () { })
    : Promise.resolve();

return fontReady
    .then(function () { return previousPageReady ? previousPageReady() : mathJax.startup.defaultPageReady(); })
    .then(function (value) { /* post-render fixups */ return value; });
একটা সূক্ষ্ম কিন্তু গুরুত্বপূর্ণ বিষয় এখানে আছে: raw LaTeX text-এ Bijoy-encoded অংশ শনাক্ত করার কাজটা typeset শুরু হওয়ার আগেই করে রাখা হচ্ছিল (markBijoySpans), কারণ typeset হয়ে যাওয়ার পর সেই raw text আর সরাসরি পাওয়া যায় না — রেন্ডার হওয়া output থেকে আলাদা element tree তৈরি হয়ে যায়। অর্থাৎ, information হারিয়ে যাওয়ার আগেই সেটা capture করে রাখতে হয়েছিল, একটা attribute-এ মার্ক করে (data-sutonnymj)।
Beginner-রা সাধারণত যে ভুল করে:
- ধরে নেয় resource (font, image, external script) দ্রুত load হয়ে যাবে, তাই setTimeout দিয়ে একটা "মোটামুটি যথেষ্ট" delay দেয় — যেটা ধীর network/CPU-তে fail করে, কিন্তু dev machine-এ কাজ করে বলে বাগটা ধরা পড়ে না।
- ভুলে যায় যে একটা async operation-এর ফলাফল (যেমন raw text) পরবর্তী ধাপে transform হয়ে যাওয়ার পর হারিয়ে যেতে পারে — সেই তথ্য দরকার হওয়ার আগেই capture করে রাখতে হয়।
ভালো Engineering Approach:
- Timing-নির্ভর guess (
setTimeout) না করে, platform যা প্রকৃত completion signal দেয় সেটা ব্যবহার করুন (এখানেdocument.fonts.load()-এর Promise, যেটা font সত্যিই ব্যবহারযোগ্য হলে resolve হয়)। - কোনো ধাপে ব্যবহার করা তথ্য পরবর্তী ধাপে অনুপস্থিত/রূপান্তরিত হয়ে যাবে কিনা আগে থেকে ভাবুন — দরকার হলে সেই তথ্য আগেভাগেই capture/mark করে রাখুন।
যেভাবে আগেভাগে ধরা যায়:
কোডে setTimeout দিয়ে "wait for X to be ready" জাতীয় প্যাটার্ন দেখলে সন্দেহ করুন — এটা প্রায় সবসময় একটা race condition-এর লক্ষণ। জিজ্ঞেস করুন: "X কি সত্যিই একটা Promise/event দেয় যেটা দিয়ে অপেক্ষা করা যায়?"
বড় শিক্ষা: Async programming-এ "মোটামুটি যথেষ্ট সময় অপেক্ষা করা" কখনোই নির্ভরযোগ্য সমাধান না — এটা শুধু বাগের সম্ভাবনা কমায়, দূর করে না। সবসময় platform-provided completion signal (Promise, event, callback) খুঁজে বের করে সেটার উপর নির্ভর করুন।
৯. API Contract: HTTP Semantics, Payload Limit, আর Naming Mismatch
এটা আসলে কী: যখন একটা client (browser/JS) একটা server endpoint-কে call করে, তাদের মধ্যে একটা implicit contract থাকে — কোন HTTP method ব্যবহার হবে, কোন parameter নামে data পাঠানো হবে, কতটুকু data পাঠানো যাবে। এই contract-এর যেকোনো একটা দিক ভেঙে গেলে request পুরোপুরি silently fail করতে পারে।
কেন এটা সমস্যা হয়ে ওঠে: দুটো ভিন্ন বাস্তব ঘটনা দুটো ভিন্ন contract-ভাঙা দেখায়:
১) Payload limit: একটা report export ফিচারে, সব filter criteria মিলিয়ে URL query string ২,১৩২ ক্যারেক্টার লম্বা হয়ে যাচ্ছিল — কিন্তু IIS (web server) default-ভাবে ২,০৪৮ ক্যারেক্টারের বেশি URL গ্রহণ করে না। ফলে request server action-এ পৌঁছানোর আগেই reject হয়ে যাচ্ছিল। সমাধান: window.open(url) (GET, query string-এ data) বদলে একটা dynamically তৈরি <form method="POST"> submit করা হলো, যেটা data-কে request body-তে পাঠায়, body-র কোনো practical length limit নেই।
var form = $("<form>", { method: "POST", action: url, target: "_blank" });
$.each(urlParam, function (name, value) {
    form.append($("<input>", { type: "hidden", name: name, value: value }));
});
form.appendTo("body").submit().remove();
এটা একটা গুরুত্বপূর্ণ পাঠ শেখায়: GET আর POST-এর পার্থক্য শুধু semantic (GET মানে "পড়া," POST মানে "পরিবর্তন করা") না — practical limit-ও ভিন্ন। ছোট, filter-heavy বা বড় dataset-driven request-এর জন্য GET বেছে নেওয়ার আগে ভাবা দরকার এটা কতটুকু বড় হতে পারে।
২) Naming mismatch across a boundary: একটা controller action redirect করার সময় roll number-কে prn নামে parameter হিসেবে পাঠাচ্ছিল, কিন্তু receiving action সেটা rollNo নামে পড়ছিল। ফলাফল — filter সবসময় silently হারিয়ে যাচ্ছিল, কোনো error/exception ছাড়াই, কারণ ASP.NET model binding না মিললে সেই parameter-কে চুপচাপ default value (null/empty) ধরে নেয়।
Beginner-রা সাধারণত যে ভুল করে:
- সব ক্ষেত্রে GET ব্যবহার করে কারণ "URL-এ দেখা যায়, debug করা সহজ" — কিন্তু data-র সাইজ বাড়ার সম্ভাবনা মাথায় রাখে না।
- Redirect/query-parameter-এর নাম দুই জায়গায় (caller আর receiver) হাতে-হাতে টাইপ করে, একটা shared constant বা strongly-typed model ব্যবহার না করে — একটা বানান ভুল হলে কোনো compile-time error আসে না।
ভালো Engineering Approach:
- যেকোনো request যেটা মুটামুটি বড়, dynamic, বা variable-length data বহন করতে পারে (filter criteria, বড় ID list), তার জন্য শুরু থেকেই POST + body ব্যবহার করুন, GET + query string না।
- Request/redirect-এর parameter নাম hardcoded string হিসেবে দুই জায়গায় আলাদা করে না লিখে, যেখানে সম্ভব একটা shared model/constant ব্যবহার করুন, যাতে নাম পরিবর্তন হলে compiler ধরিয়ে দেয়।
যেভাবে আগেভাগে ধরা যায়: কোনো filter/parameter "silently কাজ করছে না" (error নেই, কিন্তু ফলাফলও নেই) দেখলে প্রথমেই caller আর receiver-এর parameter নাম হুবহু মিলছে কিনা চেক করুন। আর কোনো export/report ফিচারে অনেক criteria জমা হতে পারলে, URL length-এর সীমা মাথায় রাখুন।
বড় শিক্ষা: Client আর server-এর মধ্যে contract শুধু "কী পাঠানো হচ্ছে" না, বরং "কীভাবে" (method, নাম, encoding, size limit) পাঠানো হচ্ছে সেটাও। এই contract-এর কোনো অংশ implicit/hand-typed রাখলে, ভবিষ্যতে সেটা নীরবে ভাঙার সুযোগ থেকে যায়।
১০. Data Modeling: Join Cardinality আর নীরব Row-Multiplication বাগ
এটা আসলে কী:
Database-এ দুটো টেবিল জোড়া লাগানোর (JOIN) সময় তাদের মধ্যেকার সম্পর্ক (cardinality — one-to-one, one-to-many, many-to-many) বোঝাটা জরুরি। একটা student যদি একাধিক enrollment/program-এ থাকতে পারে (one-to-many), তাহলে সেই student-কে তার program টেবিলের সাথে সরাসরি INNER JOIN করলে, প্রতিটা enrollment-এর জন্য মূল row একবার করে ডুপ্লিকেট হয়ে যাবে — এটাকে বলে join fan-out বা row multiplication।
কেন এটা সমস্যা হয়ে ওঠে:
এই প্রজেক্টের exam evaluation module-এ script খুঁজে বের করার filter-এ, roll number দিয়ে ফিল্টার করতে গিয়ে একটা Student টেবিলের সাথে StudentProgram টেবিলও INNER JOIN করা হচ্ছিল — শুধু এই কারণে যে Obsolete_PrnNo (একটা পুরনো PRN নম্বর ফিল্ড) কলামটা StudentProgram-এ ছিল। যেহেতু একজন student-এর একাধিক enrollment row থাকতে পারে StudentProgram-এ, এই join প্রতিটা script/answer-কে একাধিকবার count করাচ্ছিল — মূল query-র উদ্দেশ্য ছিল filter করা, কিন্তু পাশাপাশি এটা count-ও নীরবে ভুল করে দিচ্ছিল।
সমাধান ছিল সেই INNER JOIN সরিয়ে ফেলে, Obsolete_PrnNo ম্যাচ করার শর্তটাকে একটা EXISTS subquery-তে রূপান্তর করা:
-- আগে: JOIN করলে প্রতিটা enrollment-এর জন্য row ডুপ্লিকেট হতো
INNER JOIN StudentProgram sp WITH(NOLOCK) ON st.Id = sp.StudentId
... AND (st.RollNo = @roll OR sp.Obsolete_PrnNo = @roll)

-- পরে: EXISTS দিয়ে শুধু "মিলেছে কিনা" চেক করা হয়, row ডুপ্লিকেট হয় না
... AND (st.RollNo = @roll
    OR EXISTS (SELECT 1 FROM StudentProgram sp WHERE sp.StudentId = st.Id AND sp.Obsolete_PrnNo = @roll))
EXISTS একটা boolean প্রশ্ন করে ("এমন কোনো matching row আছে কি?"), সেটা matching row-গুলোকে মূল result set-এ যোগ করে না — তাই cardinality অপরিবর্তিত থাকে।
Beginner-রা সাধারণত যে ভুল করে:
- একটা column অন্য টেবিলে আছে দেখেই সেই টেবিলকে সরাসরি
JOINকরে ফেলে, না ভেবেই সেই সম্পর্কটা one-to-many কিনা। - Query-র ফলাফল সংখ্যায় সঠিক মনে হলে (কোনো error নেই) সেটাকেই সঠিক ধরে নেয় — না বুঝেই যে duplicate row থাকলে aggregate count (COUNT, SUM) ভুল হয়ে যায়, যদিও individual row-গুলো দেখতে ঠিকই লাগে।
ভালো Engineering Approach:
- কোনো টেবিল
JOINকরার আগে জিজ্ঞেস করুন: "এই সম্পর্কটা কি one-to-many বা many-to-many?" যদি হ্যাঁ হয়, এবং আপনার আসল উদ্দেশ্য শুধু "matching row আছে কিনা" চেক করা (row নিজে দরকার না), তাহলেJOIN-এর বদলেEXISTS/INsubquery ব্যবহার করুন। - Query লেখার পর, সন্দেহজনক জায়গায়
COUNT(*)করে দেখুন আশানুরূপ সংখ্যা আসছে কিনা, বিশেষত যেখানে multiple table জোড়া লাগানো হয়েছে।
যেভাবে আগেভাগে ধরা যায়:
কোনো listing/count "দ্বিগুণ" বা "একটু বেশি" দেখাচ্ছে (কিন্তু individual row ভুল না) এই ধরনের বাগ রিপোর্ট পেলে, প্রথমেই query-র JOIN clause-গুলো দেখুন — কোনো one-to-many টেবিল INNER JOIN করা হয়েছে কিনা যেটা EXISTS/IN দিয়েও করা যেত।
বড় শিক্ষা:
SQL-এ JOIN শুধু "দুটো টেবিল সংযুক্ত করার" টুল না — এটা result set-এর cardinality বদলে দিতে পারে। যখন আপনার উদ্দেশ্য শুধু filter করা (অন্য টেবিলের data দরকার না), EXISTS প্রায়ই নিরাপদ ও স্পষ্ট পছন্দ।
১১. Defense-in-Depth Validation ও Business-Critical State-এর Immutability
এটা আসলে কী: Immutability মানে কোনো ডেটা একবার তৈরি হওয়ার পর পরিবর্তনযোগ্য না রাখা। Defense-in-depth validation মানে একই নিয়ম একাধিক স্তরে (server-side authoritative check + client-side UX guard) প্রয়োগ করা — যাতে UI bypass হয়ে গেলেও (browser dev tools দিয়ে, বা সরাসরি API call করে) ডেটা invalid অবস্থায় পৌঁছাতে না পারে।
কেন এটা সমস্যা হয়ে ওঠে: এই প্রজেক্টে একটা class routine (অনলাইন ক্লাসের সময়সূচি) তৈরি হওয়ার পর, তার date/time বদলানো যাচ্ছিল — কিন্তু সেই routine-এর সাথে যুক্ত মিটিং লিংক (Zoom-জাতীয়) কখনো নতুন সময়ে সরানো হতো না। ফলে date/time বদলালে, student রা পুরনো সময়ে join করতে যেত আর মিটিং খুঁজে পেত না — একটা নীরব, ধরা কঠিন সমস্যা, কারণ কোনো error দেখায় না, শুধু ভুল সময়ে সবাই কনফিউজড হয়।
সমাধানটা তিনটা স্তরে প্রয়োগ করা হয়েছিল: ১) Service layer (authoritative) — আসল rule এখানে enforce হয়, একটা exception ছুঁড়ে দিয়ে:
private static void EnsureRoutineDateTimeUnchanged(ClassRoutine oldClassRoutine, ClassRoutineViewModel classRoutineModel)
{
    if (oldClassRoutine.RoutineDate.Date != classRoutineModel.ClassRoutineDate.Date)
        throw new UmsInvalidDataException("Routine date can not be changed after the routine is created.");
    // ... start time, end time একইভাবে চেক
}
২) UI layer — date/time picker disabled করে দেওয়া হয়, যাতে ব্যবহারকারী প্রথমেই বদলানোর চেষ্টা করার সুযোগ কম পায়। ৩) Client-side JS guard — hidden original value-র সাথে current form value তুলনা করে submit হওয়ার আগেই আটকে দেওয়া, ভালো error message সহ।
Beginner-রা সাধারণত যে ভুল করে:
- শুধু UI-তে field disabled করে দিয়ে ভাবে কাজ শেষ — ভুলে যায় disabled attribute browser DevTools দিয়ে সহজেই সরিয়ে ফেলা যায়, বা কেউ সরাসরি API call করলে UI-এর disable আদৌ প্রযোজ্য হয় না।
- শুধু server-side validation লিখে ভাবে "যথেষ্ট নিরাপদ" — কিন্তু তাতে ব্যবহারকারী একটা খারাপ experience পায় (ফর্ম পূরণ করে submit করার পর হঠাৎ error), আগে থেকে জানানো হয় না যে এই field বদলানো যাবে না কেন।
ভালো Engineering Approach:
- Business-critical rule (যেটা ভাঙলে downstream-এ real-world সমস্যা হয় — এখানে student ভুল সময়ে মিটিং খুঁজবে) সবসময় server-side-এ enforce করুন, সেটাই "ground truth"। এটা bypass করা যাবে না।
- এর পাশাপাশি client-side-এ ভালো UX-এর জন্য guard রাখুন (disabled input, আগেভাগে error message) — কিন্তু সেটাকে security/correctness বলে বিশ্বাস করবেন না, সেটা শুধু ব্যবহারকারীর অভিজ্ঞতা উন্নত করার জন্য।
যেভাবে আগেভাগে ধরা যায়: কোনো ফিল্ড "কখনো বদলানো উচিত না" এমন সিদ্ধান্তে আসলে জিজ্ঞেস করুন — এই নিয়মটা কি শুধু UI-তে (disabled attribute) প্রয়োগ করা হয়েছে, নাকি service/domain layer-এও? যদি শুধু UI-তে হয়, সেটা একটা নিরাপত্তা ফাঁক।
বড় শিক্ষা: UI validation হলো সৌজন্য (ব্যবহারকারীকে দ্রুত জানানো), server-side validation হলো নিয়ম প্রয়োগ। দুটোর কাজ আলাদা — একটাকে অন্যটার বিকল্প ভাবা ভুল।
১২. সিদ্ধান্ত ও Trade-off ডকুমেন্ট করা — যাতে ভবিষ্যতে সেগুলো "পুনরাবিষ্কার" করতে না হয়
এটা আসলে কী: প্রতিটা বড় engineering সিদ্ধান্তে একটা জিনিসের বিনিময়ে আরেকটা জিনিস ত্যাগ করতে হয় (trade-off)। সেই সিদ্ধান্তের "কেন" টা যদি লিখে না রাখা হয়, ভবিষ্যতের কেউ সেটাকে ভুল/দুর্ঘটনা ভেবে সময় নষ্ট করবে — বা আরও খারাপ, না বুঝেই সেটা উল্টে দেবে।
কেন এটা সমস্যা হয়ে ওঠে: এই প্রজেক্টে দুটো উদাহরণ:
১) একটা rich-text editor (CKEditor 5, ভার্সন ৪৮.২.০) সচেতনভাবে বেছে নেওয়া হয়েছিল, যদিও এটা GPL 2+ লাইসেন্সের আওতায় (একটা commercial/internal ERP-তে যেটা প্রথম দেখায় অস্বাভাবিক মনে হতে পারে) — এবং সেটা self-host করা হয়েছিল (CDN থেকে না), লাইসেন্স শর্ত মেনেই। এই সিদ্ধান্তটা migration document-এ স্পষ্টভাবে লেখা ছিল, যাতে কেউ পরে "এটা কি ভুলবশত রয়ে গেছে?" ভেবে সময় নষ্ট না করে।
২) দুইটা ভিন্ন migration-planning document পরস্পরবিরোধী তথ্য দিচ্ছিল — একটায় লেখা ছিল MultiSelect component-এর জন্য Tom Select library ব্যবহার হবে, আরেকটায় (এবং বাস্তবে repo-তে actually deploy করা কোডে) bootstrap-multiselect-2.0.0 ব্যবহার হচ্ছিল। এই দ্বন্দ্ব শুধু actual deployed ফাইল (ContentV2/ ফোল্ডার) চেক করেই মেটানো সম্ভব হয়েছিল — কোনো document-ই একা যথেষ্ট বিশ্বাসযোগ্য ছিল না।
Beginner-রা সাধারণত যে ভুল করে:
- প্রজেক্টের সব documentation-কে সমান authoritative ধরে নেয়, কোনটা পুরনো/stale হয়ে গেছে সেটা যাচাই না করেই।
- কোনো অস্বাভাবিক দেখতে সিদ্ধান্ত (একটা GPL dependency, একটা অপ্রচলিত config value) দেখলেই সেটাকে ভুল ধরে "ঠিক করতে" যায়, আগে সেই সিদ্ধান্তের পেছনে কোনো ইচ্ছাকৃত কারণ আছে কিনা খুঁজে দেখে না।
ভালো Engineering Approach:
- গুরুত্বপূর্ণ সিদ্ধান্তের (লাইসেন্স পছন্দ, architecture choice, library choice) পাশে সাথে সাথেই তার "কেন" লিখে রাখুন, তারিখসহ।
- দুটো document পরস্পরবিরোধী হলে, actual deployed/running code/repo state-কেই চূড়ান্ত সিদ্ধান্তকারী হিসেবে ধরুন, আর stale document-টা আপডেট করে দিন।
যেভাবে আগেভাগে ধরা যায়: কোনো "ভুল" বা "অস্বাভাবিক" দেখতে জিনিস ঠিক করতে যাওয়ার আগে, সেই সিদ্ধান্তের কোনো রেকর্ড আছে কিনা খুঁজুন — অবাক-করা কোড অনেক সময় ইচ্ছাকৃত।
বড় শিক্ষা: কোড-এর চেয়ে ডকুমেন্টেশন দ্রুত পুরনো হয়ে যায়। মনে রাখার মতো সিদ্ধান্তের জন্য একটা টেকসই, তারিখসহ রেকর্ড দরকার — আর দ্বন্দ্ব হলে, running system (যা আসলে ব্যবহৃত হচ্ছে) সবসময় planning document-এর চেয়ে বেশি বিশ্বাসযোগ্য।
আরও যেসব বিষয় নিয়ে আলোচনা করা যেত
উপরের ১২টা বিষয়ের বাইরেও এই কাজগুলোর মধ্যে আরও কিছু genuine engineering topic লুকিয়ে ছিল, যেগুলো জায়গার কারণে সংক্ষেপে উল্লেখ করা হলো:
- Capacity/concurrency configuration — একজন ব্যবহারকারীকে device-প্রতি কতগুলো সমান্তরাল session করতে দেওয়া হবে, সেই সংখ্যা ঠিক করা একটা security ও UX-এর মধ্যেকার trade-off।
- Legacy encoding compatibility layers — পুরনো Bijoy-encoded টেক্সটকে নতুন Unicode-based রেন্ডারিং সিস্টেমের সাথে সহাবস্থান করানো (byte-signature detection দিয়ে), একটা সাধারণ "পুরনো ডেটা ফরম্যাট বনাম নতুন সিস্টেম" সমস্যার উদাহরণ।
- Commit message as documentation — এই লেখার জন্য ব্যবহৃত git commit message-গুলো (যেমন "The meeting is never moved with the routine, so a changed slot would leave students joining at the old time") নিজেই "কেন" ব্যাখ্যা করে দেয়, ভবিষ্যতে
git blame/git logপড়ে প্রেক্ষাপট বোঝার একটা শক্তিশালী চর্চা।
উপসংহার
এই ১২টা বিষয়ের প্রতিটাই ভিন্ন ভিন্ন স্তরের মনে হতে পারে — CSS-এর specificity থেকে শুরু করে SQL join আর async font-loading পর্যন্ত। কিন্তু এদের সবার মধ্যে একটা common thread আছে: অনুমান নয়, প্রমাণ; সুবিধাজনক শর্টকাট নয়, সঠিক scope; "এখন কাজ করছে" নয়, "সব state-এ কাজ করবে"। অভিজ্ঞ engineer আর নতুন engineer-এর মধ্যে পার্থক্যটা প্রায়ই knowledge-এর না, বরং এই অভ্যাসগুলোর — বাগ ধরার আগে measure করা, fix করার আগে blast radius ভাবা, আর সিদ্ধান্তের পেছনের কারণ লিখে রাখা।
এক লাইনের শিক্ষা: ভালো কোড লেখার চেয়েও গুরুত্বপূর্ণ হলো, আপনার পরিবর্তন কতদূর পর্যন্ত প্রভাব ফেলতে পারে সেটা বোঝা, আর সেই প্রভাব যাচাই করার মতো proof হাতে রাখা।