#disjoint set union #dsu #union find #path compression #union by size #union by rank #kruskal algorithm #disjoint set union #union-find #dsu #data structure #graph algorithm #tree #path compression #union by size #union by rank #kruskal #mst #competitive programming
Disjoint Set Union (DSU)
2026-09-26 · 37 min read
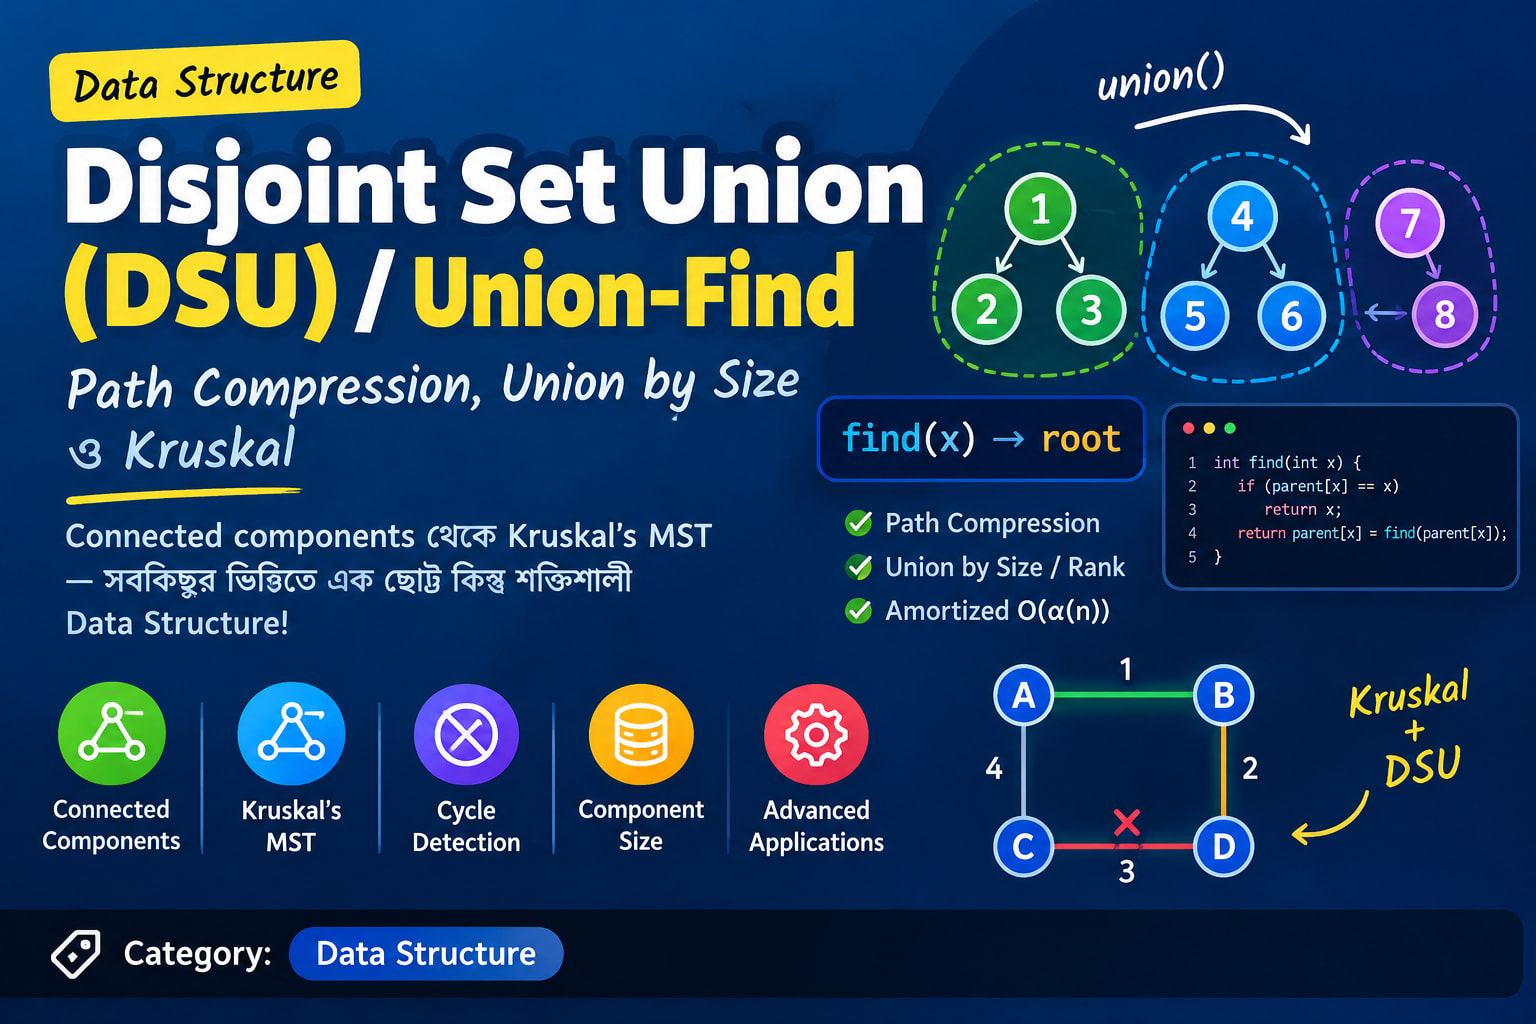
Data Structure শুনলেই অনেকের মাথায় Binary Tree, Heap, Trie, Segment Tree বা Graph চলে আসে। কিন্তু কিছু problem আছে যেখানে আমাদের মূল কাজই হলোঃ
“এই দুইটা node কি একই group-এর সদস্য?” “দুইটা group-কে এক করা যাবে?” “বর্তমানে এই component-এ মোট কয়টা node আছে?”
এই ধরনের সমস্যার জন্য অসাধারণ একটি data structure হলো Disjoint Set Union (DSU), যাকে Union-Find-ও বলা হয়। DSU এমনভাবে disjoint বা non-overlapping set manage করে, যাতে দুইটি set merge করা এবং কোনো element কোন set-এর অন্তর্ভুক্ত তা বের করা খুব দ্রুত করা যায়। Competitive Programming-এ DSU বিশেষভাবে গুরুত্বপূর্ণ Kruskal’s Minimum Spanning Tree, connected components, cycle detection, component size tracking, offline query processing এবং আরও অনেক সমস্যায়।
প্রথমে Problem-টা বুঝি
ধরি আমাদের ৮ জন মানুষঃ A B C D E F G H শুরুতে কেউ কারও সঙ্গে connected নয়। তাই আমাদের ৮টি আলাদা group:
{A} {B} {C} {D} {E} {F} {G} {H}
এখন যদি বলা হয়,
A-B connected
B-C connected
D-E connected
F-G connected
তাহলে আমরা খুব সহজেই বুঝতে পারি
{A, B, C}
{D, E}
{F, G}
{H}
এখন প্রশ্ন হলো,
A এবং C কি একই group-এ?
D এবং G কি একই group-এ?
উত্তরঃ
A, C → YES
D, G → NO
এই ধরনের dynamic connectivity problem-ই DSU খুব efficiently solve করতে পারে।
এখানে একটা গুরুত্বপূর্ণ distinction
DSU বলতে পারেঃ
“দুইটি node একই connected component-এর মধ্যে আছে কি না।”
কিন্তু DSU সাধারণভাবে বলতে পারে নাঃ
“A আর B-এর মধ্যে সরাসরি edge আছে কি না।”
অর্থাৎ,
A → B → C
এখানে A এবং C-এর মধ্যে সরাসরি edge না থাকলেও তারা একই set-এর সদস্য হতে পারে।
DSU-এর মূল ধারণাঃ Representative
প্রতিটি set-এর একটি representative বা leader থাকবে। ধরা যাক,
Set 1 = {A, B, C}
Set 2 = {D, E}
এখানে প্রথম set-এর representative A, দ্বিতীয় set-এর representative D হতে পারে। Representative নির্দিষ্ট কোনো magic node নয়। Union operation-এর সময় representative পরিবর্তন হতে পারে। আধুনিক DSU implementation-এ কোন root representative হবে সেটা সাধারণত union by size/rank ঠিক করে। এখন যদি,
find(A) = A
find(C) = A
তাহলে A এবং C একই set-এ আছে। অন্যদিকে,
find(A) = A
find(E) = D
তাহলে তারা আলাদা set-এ। অর্থাৎ সবচেয়ে গুরুত্বপূর্ণ rule:
find(x) == find(y)
        ↓
   same set
DSU আসলে কীভাবে Data Structure তৈরি করে?
DSU সাধারণত একটি parent array ব্যবহার করে। ধরি,
parent[i] = i;
তাহলে শুরুতে প্রতিটি node নিজের parent নিজেইঃ
1   2   3   4   5

↑   ↑   ↑   ↑   ↑
1   2   3   4   5
অর্থাৎ ৫টি node মানে ৫টি আলাদা set।
তিনটি Fundamental Operation
DSU-এর basic interface সাধারণত তিনটি operation নিয়ে ভাবা যায়ঃ
| Operation | কাজ |
|---|---|
make_set(x) | নতুন একটি set তৈরি |
find(x) | x-এর representative/root বের করা |
union(a,b) | a ও b যে দুই set-এ আছে, সেগুলো merge করা |
এই তিন-operation model-টিই standard DSU formulation।
1. Make Set
শুরুতেঃ
parent[i] = i;
size[i] = 1;
উদাহরণঃ
1      2      3      4      5
↑      ↑      ↑      ↑      ↑
1      2      3      4      5
প্রতিটি node নিজেই নিজের representative। Modern implementation-এ component size রাখলে সেটিও শুরুতে 1 হবে।
2. Find: “আমার Leader কে?”
ধরি আমাদের structure:
5 → 3 → 2 → 1
এখানে,
parent[5] = 3
parent[3] = 2
parent[2] = 1
parent[1] = 1
তাহলে find(5) করতে হবেঃ
5 → 3 → 2 → 1
এবং যেহেতু,
parent[1] == 1
তাই 1 হলো representative। Naive version:
int find(int x) {
    if (parent[x] == x)
        return x;

    return find(parent[x]);
}
মূল tutorial-এও root-এর condition হিসেবে par[r] == r ব্যবহার করা হয়েছিল।
সমস্যা কোথায়?
এই tree যদি এমন হয়ঃ
10
 |
9
 |
8
 |
7
 |
6
 |
5
 |
4
 |
3
 |
2
 |
1
তাহলে find(10) করতে প্রায় পুরো chain traverse করতে হবে। Worst case-এ tree যদি অত্যন্ত গভীর হয়, naive find() O(n) পর্যন্ত সময় নিতে পারে। এখানেই DSU-এর আসল optimization শুরু।
Path Compression: Find করার সময় Tree-কে Flatten করে ফেলি
ধরি,
7 → 5 → 3 → 2 → 1
আমরা find(7) করলাম। Representative পাওয়া গেল 1। এখন প্রশ্নঃ
পরেরবার 5-এর representative খুঁজতে আবার
5 → 3 → 2 → 1ঘুরব কেন?
বরং path-এ যেসব node পেয়েছি তাদের সরাসরি root-এর সঙ্গে connect করে দিইঃ
7 ─────┐
5 ─────┤
3 ─────┤→ 1
2 ─────┤
1 ─────┘
এটাই Path Compression। Standard implementation:
int find(int x) {
    if (parent[x] == x)
        return x;

    return parent[x] = find(parent[x]);
}
এই এক লাইনেরঃ
parent[x] = find(parent[x]);
মধ্যে পুরো optimization লুকিয়ে আছে। Find root খুঁজে আনার পাশাপাশি visited node-কে root-এর সঙ্গে directly attach করে দেয়।
Path Compression নিয়ে সবচেয়ে common confusion
অনেকে লেখেঃ
return find(parent[x]);
এটা representative খুঁজে বের করবে, কিন্তু tree-কে permanently flatten করবে না। আর,
parent[x] = find(parent[x]);
return parent[x];
এখানে representative পাওয়া এবং parent update দুটোই হবে। সুতরাং, এই version-টাই গুরুত্বপূর্ণ।
int find(int x) {
    if (parent[x] == x)
        return x;

    return parent[x] = find(parent[x]);
}
3. Union: দুই Group এক করি
ধরিঃ
Set A = {1,2,3}
Set B = {4,5}
এখনঃ
union(2,5);
মানে 2 যে set-এ আছে এবং 5 যে set-এ আছে। দুই component merge করতে হবে। প্রথমে,
find(2) = rootA
find(5) = rootB
তারপরঃ
rootA != rootB
হলে দুই root-কে connect করব। Naive implementation:
void unite(int a, int b) {
    a = find(a);
    b = find(b);

    if (a != b)
        parent[b] = a;
}
parent[a] = b নাকি parent[b] = a?
এটা নিয়ে অনেক confusion হয়। দুটোই logically valid, কিন্তু একটি condition আছেঃ
aএবংbএখানে সরাসরি original node নয়;find()করার পরের root হতে হবে।
অর্থাৎ,
a = find(a);
b = find(b);

if (a != b)
    parent[b] = a;
অথবাঃ
parent[a] = b;
দুটোই কাজ করতে পারে। কিন্তু arbitrary ভাবেঃ
parent[a] = b;
লিখে দিলে এবং a, b root না হলে tree structure নষ্ট হতে পারে। আরও গুরুত্বপূর্ণ ব্যাপার হলো, সবসময় এক root-কে অন্য root-এর নিচে attach করলে tree unnecessarily লম্বা হতে পারে। এখানেই আসে Union by Size / Union by Rank।
Union by Size: বড় Tree-র সঙ্গে ছোট Tree জুড়ি
ধরি দুইটি component:
Set A → 2 nodes
Set B → 1000 nodes
ছোট tree-কে বড় tree-এর নিচে দিলে structure তুলনামূলক shallow থাকবে। তাই,
small tree → large tree
এটাই Union by Size। প্রতিটি root-এর জন্য component size রাখিঃ
if (size[a] < size[b])
    swap(a, b);

parent[b] = a;
size[a] += size[b];
এতে ছোট component-এর root বড় component-এর root-এর child হয়। এই heuristic tree height নিয়ন্ত্রণে সাহায্য করে।
Union by Rank
আরেকটি জনপ্রিয় strategy হলো Union by Rank। এখানে component size না রেখে tree-এর একটি rank/height-related upper bound রাখা হয়।
if (rank[a] < rank[b])
    swap(a, b);

parent[b] = a;

if (rank[a] == rank[b])
    rank[a]++;
Path compression এবং union by rank দুটো একসঙ্গে ব্যবহার করলে DSU-এর amortized complexity অত্যন্ত কমে যায়।
Path Compression + Union by Size/Rank = DSU-এর আসল Power
এখানে একটি গুরুত্বপূর্ণ correction করা দরকার। শুধু path compression ব্যবহার করে “প্রতিটি operation প্রায় O(1)” বলা ঠিক নয়। Standard optimized DSU-তেঃ
Path Compression + Union by Size/Rank
একসঙ্গে ব্যবহার করলে m operations-এর total amortized complexity:
O(m α(n))
এখানে α(n) হলো inverse Ackermann function, যেটি বাস্তব input size-এর জন্য অত্যন্ত ধীরে বাড়ে। তাই practical programming-এ এটাকে প্রায় constant-এর মতো ধরা হয়, যদিও formally এটি O(1) নয়। অন্যদিকে union by size/rank ব্যবহার করে path compression না করলে সাধারণত O(log n) per operation-এর bound পাওয়া যায়।
Modern C++ Implementation
বর্তমান competitive programming-এর জন্য এমন একটি implementation অনেক বেশি practical:
#include <bits/stdc++.h>
using namespace std;

class DSU {
private:
    vector<int> parent;
    vector<int> sz;

public:
    DSU(int n) {
        parent.resize(n);
        sz.assign(n, 1);

        iota(parent.begin(), parent.end(), 0);
    }

    int find(int x) {
        if (parent[x] == x)
            return x;

        return parent[x] = find(parent[x]);
    }

    bool unite(int a, int b) {
        a = find(a);
        b = find(b);

        if (a == b)
            return false;

        // Small tree goes under the large tree.
        if (sz[a] < sz[b])
            swap(a, b);

        parent[b] = a;
        sz[a] += sz[b];

        return true;
    }

    bool same(int a, int b) {
        return find(a) == find(b);
    }

    int componentSize(int x) {
        return sz[find(x)];
    }
};
ব্যবহারঃ
DSU dsu(10);

dsu.unite(1, 2);
dsu.unite(2, 3);
dsu.unite(7, 8);

cout << dsu.same(1, 3) << '\n'; // 1
cout << dsu.same(1, 7) << '\n'; // 0

cout << dsu.componentSize(2) << '\n'; // 3
এখানে componentSize()-এর সময় সবসময়ঃ
sz[find(x)]
ব্যবহার করা হয়েছে। কারণ size[root]-এই actual component size store করা হচ্ছে; non-root node-এর sz value merge-এর পরে meaningful component size হিসেবে ধরে নেওয়া উচিত নয়।
DSU দিয়ে Cycle Detection
Undirected graph-এ DSU দিয়ে cycle detection করাও খুব সহজ। প্রতিটি edge (u, v) আসার পরঃ
if (find(u) == find(v)) {
    // Cycle detected
}
else {
    unite(u, v);
}
কেন? যদি u আর v আগেই একই component-এ থাকে, তাহলে তাদের মধ্যে নতুন edge যোগ করলে একটি cycle তৈরি হবে। এটি DSU-এর একটি classic application।
Kruskal’s Algorithm-এ DSU কেন লাগে?
Kruskal algorithm edge-গুলোকে weight অনুযায়ী ছোট থেকে বড় সাজায়। প্রতিটি edge (u,v) নিয়েঃ
u এবং v কি আগেই একই component-এ?

YES → edge নেব না
NO  → edge নেব + দুই component merge করব
DSU এখানে ঠিক সেই কাজটাই করেঃ
if (!dsu.same(u, v)) {
    answer += weight;
    dsu.unite(u, v);
}
এই কারণে Kruskal এবং DSU একে অপরের সঙ্গে প্রায় inseparable concept হয়ে গেছে। DSU-এর standard applications-এর মধ্যে Kruskal বিশেষভাবে গুরুত্বপূর্ণ।
DSU কোথায় শুধু Competition-এর জন্য নয়?
DSU-এর application অনেক বিস্তৃত।
Connected Components
একাধিক node-এর component maintain করতে।
Image Processing
Pixel-গুলোকে connected region/component হিসেবে group করতে।
Network Connectivity
কোন network node কোন connected cluster-এর মধ্যে আছে তা track করতে।
Kruskal’s MST
Graph-এর minimum spanning tree তৈরি করতে।
Offline Problems
কিছু problem-এ query reverse order-এ process করে deleted element/edge আবার activate করার সময় DSU অত্যন্ত useful। CP-algorithms-এ offline painting, offline RMQ এবং offline LCA-সহ একাধিক advanced application দেখানো হয়েছে।
Component Size
শুধু connection নয়, কোন component-এ কতগুলো node আছে সেটিও maintain করা যায়।
তবে DSU সব সমস্যার Solution নয়
এটা খুব গুরুত্বপূর্ণ। DSU সবচেয়ে ভালো যখন operation-এর ধরন প্রায় এমনঃ
merge
merge
merge
same?
same?
same?
কিন্তু যদি বলো,
“এই edge-টা remove করে দাও।”
তাহলে standard DSU সমস্যায় পড়ে যাবে। কারণ DSU খুব ভালোভাবে
separate set → merge
করতে পারে, কিন্তু সাধারণ DSU দিয়ে efficiently
merged set → split
করা যায় না। এই ধরনের fully dynamic connectivity problem-এ অন্য data structure বা advanced algorithm দরকার হতে পারে।
আরেকটি গুরুত্বপূর্ণ বিষয়: Representative Fixed নয়
ধরি,
{1,2}
{3,4,5}
প্রথম component-এর root হতে পারে 1 এবং দ্বিতীয়টির 3। পরে union করলে,
{1,2,3,4,5}
এর representative 1 বা 3 implementation-এর heuristic অনুযায়ী যেকোনোটি হতে পারে। তাই application যদি বলে,
“আমার representative হিসেবে নির্দিষ্ট node-টাই রাখতে হবে।”
তাহলে সাধারণ union-by-size/rank blindly ব্যবহার করা যাবে না। DSU-এর representative হলো set-এর identity হিসেবে ব্যবহৃত root, কোনো permanent business ID নয়। Representative identity union-এর পর পরিবর্তিত হতে পারে।
String বা Name দিয়ে DSU?
বাস্তব problem-এ node সবসময়
1, 2, 3, 4...
হয় না। ধরি,
"emon"
"rahim"
"karim"
"hasan"
এদের DSU-তে ব্যবহার করতে হলে আগে mapping করতে পারি,
emon  → 0
rahim → 1
karim → 2
hasan → 3
তারপর integer-based DSU চালানো যায়। এটাকেই competitive programming-এ প্রায়ই coordinate compression / ID mapping-এর সঙ্গে ব্যবহার করা হয়।
Python ব্যবহার করলে একটি বিষয় মাথায় রাখুন
Concept একই,
def find(x):
    if parent[x] == x:
        return x

    parent[x] = find(parent[x])
    return parent[x]
কিন্তু খুব deep recursion তৈরি করতে পারে এমন পরিস্থিতিতে Python recursion limit একটি practical issue হতে পারে। তাই বড় input-এর জন্য iterative find() ব্যবহার করাও ভালো design choice।
DSU শেখার সবচেয়ে সহজ mental model
DSU-কে মনে রাখতে চাইলে শুধু এই flow মাথায় রাখুনঃ
প্রত্যেকে শুরুতে নিজের group-এ
            ↓
      parent[x] = x
            ↓
দুই group merge করতে হবে?
            ↓
   find(a), find(b)
            ↓
root দুটো কি একই?
      /           \
    YES            NO
     |              |
কিছু করার নেই   union করো
আর optimization:
Find
 ↓
Path Compression

Union
 ↓
Union by Size / Rank
এই দুইটি জিনিস বুঝে গেলে DSU-এর ৮০–৯০% foundation তৈরি হয়ে যায়।
Practice Problems
1. UVa 459: Graph Connectivity
এখানে connected component count করতে DSU ব্যবহার করা যায়।
String-based node mapping + DSU practice-এর জন্য ভালো problem।
এখানে শুধু connectivity নয়, component-এর size track করার idea-টিও গুরুত্বপূর্ণ।
আরও Advanced Practice
DSU একটু comfortable হয়ে গেলেঃ
- TIMUS: Anansi’s Cobweb
- Codeforces: Roads not only in Berland
- TIMUS: Parity
- SPOJ: Strange Food Chain
- SPOJ: COLORFUL ARRAY
- SPOJ: Consecutive Letters
- Toph: Unbelievable Array
এরপর DSU-কে শুধু “same component” problem-এর মধ্যে আটকে না রেখে component size, offline processing, reverse queries, Kruskal, offline LCA-র দিকে নেওয়া যায়।
শেষ কথা
DSU দেখতে খুব ছোট একটা data structure, একটা parent[], সঙ্গে প্রয়োজনে size[] বা rank[]। কিন্তু এই ছোট structure-এর মধ্যে একটা অসাধারণ idea আছেঃ
যে জিনিসগুলোকে আলাদা আলাদা group হিসেবে শুরু করেছিলাম, প্রয়োজনমতো merge করব; আর প্রতিটি element কোন group-এর অন্তর্ভুক্ত, সেটা root/representative দেখে খুব দ্রুত জানতে পারব।
শুরুতে হয়তো parent[x] = x দেখে মনে হবে, “এইটুকুই নাকি Data Structure?” তারপর path compression আর union by size যোগ করার পর বোঝা যায় ছোট্ট array-টা আসলে বেশ চালাক! DSU-এর classic rooted-tree implementation এবং দুইটি optimization, path compression ও union by rank/size TopCoder-এর classic tutorial এবং বর্তমান algorithm references-এ একই foundational structure হিসেবে ব্যবহৃত হয়েছে।