#consistent hashing #consistent hashing বাংলা #hash ring #virtual node #distributed cache #system design #distributed system #load balancing #consistent hashing algorithm #consistent hashing #hashing #system design #distributed systems #backend engineering #distributed cache #virtual nodes #load balancing
Consistent Hashing কী? Distributed System-এ Hash Ring, Virtual Node ও Load Distribution সহজে বুঝুন
2026-09-19 · 14 min read
ভাবো, তোমার একটা application আছে যেখানে প্রতিদিন কোটি কোটি request আসছে। সব request-এর data এক জায়গায় রাখলে database হাঁপিয়ে যাবে। তাই তুমি data ভাগ করে কয়েকটি cache server-এ রেখে দিলে। শুরুতে সবকিছু দারুণ। তারপর একদিন traffic বাড়ল। তুমি ভাবলে,
“আরেকটা server যোগ করি।”
কিন্তু নতুন server যোগ করার পরই দেখা গেল পুরোনো অনেক key অন্য server-এ চলে গেছে। আগে যেসব data cache-এ ছিল, এখন সেই request অন্য server-এ যাচ্ছে, যেখানে data-টাই নেই! Cache hit rate কমল, database-এর ওপর চাপ বাড়ল, latency বাড়ল। আর যদি একটি server হঠাৎ down করে তাহলে একই ধরনের mapping সমস্যা আরও বড় আকারে দেখা দিতে পারে। এই সমস্যার গুরুত্বপূর্ণ সমাধানগুলোর একটি হলো Consistent Hashing।
তবে শুরুতেই একটি বিষয় পরিষ্কার করা ভালো। Consistent Hashing কোনো magic load balancer নয়। এটি এমন একটি key-to-node mapping strategy, যেটি distributed system-এ server membership পরিবর্তন হলেও যতটা সম্ভব কম key-কে নতুন জায়গায় পাঠানোর চেষ্টা করে।
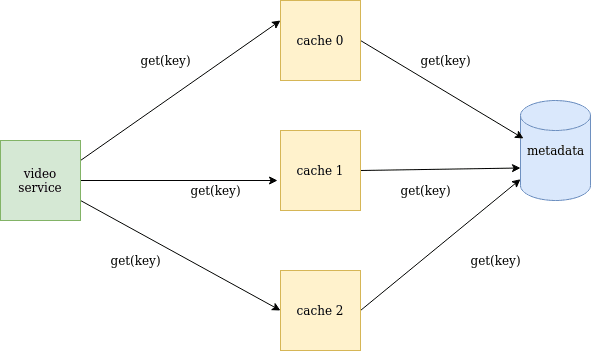
প্রথম সমস্যা: hash(key) % N
ধরা যাক তোমার ৩টি cache server আছেঃ
Cache 0
Cache 1
Cache 2
কোন key কোন server-এ যাবে সেটা ঠিক করার জন্য খুব সাধারণ একটি পদ্ধতি হতে পারে,
server = hash(key) % N
এখানে N = 3। ধরা যাক,
hash("video-100120") % 3 = 1তাহলে video-100120 যাবে Cache 1-এ। এই পদ্ধতিতে lookup খুব সহজ। একই key-এর জন্য একই server পাওয়া যায়, যতক্ষণ server-এর সংখ্যা অপরিবর্তিত থাকে। সমস্যা শুরু হয় যখন N পরিবর্তন হয়।
নতুন একটি server যোগ করলে কী হয়?
ধরা যাক ৩টি server থেকে আমরা ৪টি server করলাম। আগে ছিলঃ
hash(key) % 3
এখন হলোঃ
hash(key) % 4
Hash value একই থাকলেও modulus বদলে যাওয়ার কারণে ফলাফল বদলে যাবে। ফলে এমন একটি key, যেটা এতদিন Cache 1-এ ছিল, এখন Cache 3-এ যেতে পারে। কিন্তু Cache 3 তো আগে ওই key কখনো দেখেনি! ফলাফল Cache miss. তারপর database-এ request যাবে। শুধু একটি key নয়, server সংখ্যা বদলালে অনেক key-এর mapping বদলে যেতে পারে। AWS-এর ElastiCache documentation-এও এই সমস্যাটি স্পষ্টভাবে দেখানো হয়েছেঃ ৯ থেকে ১০ node-এ গেলে naïve modulo mapping-এ প্রায় ৯০% key নতুন জায়গায় যেতে পারে। Consistent hashing সেই remapping অনেক কমিয়ে দেয়। এটাই distributed cache-এর জন্য বড় সমস্যা।
Hash Ring-এর ধারণা
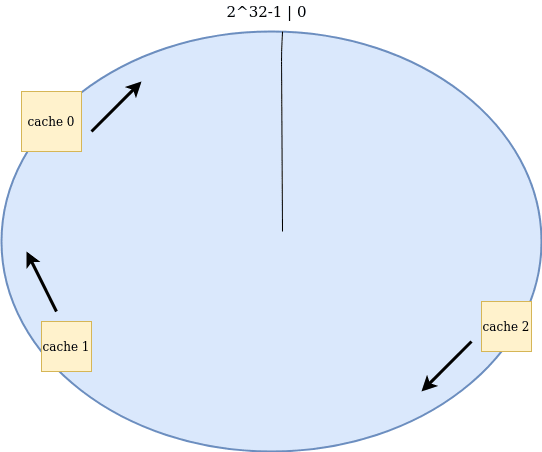
এবার আমরা server-গুলোকে একটি সরল list হিসেবে না দেখে একটি বৃত্ত বা Ring হিসেবে কল্পনা করি। এই ring-এর প্রতিটি position একটি hash value-কে represent করে। ধরা যাক আমাদের hash space হলোঃ
0 ------------------------------ MAX
 \                              /
  \____________________________/
কিন্তু বাস্তবে এটি circular:
             0
        .-----------.
      /               \
     /                 \
    |                   |
     \                 /
      \_______________/
             MAX
অর্থাৎ MAX-এর পর আবার 0। এটাই হলো Consistent Hash Ring। বাস্তবে ring-এর size 32-bit, 64-bit বা অন্য কোনো hash-space হতে পারে। তাই 2^32 - 1-কে universal requirement হিসেবে ধরে নেওয়া ঠিক নয়; এটি একটি illustrative example মাত্র।
Server-কে Ring-এ কীভাবে বসাব?
প্রথমে server-এর একটি identifier নিই,
server-0
server-1
server-2
তারপরঃ
position = hash(server_id)
এই hash value-এর ভিত্তিতে server-কে ring-এর একটি position-এ বসানো হয়। একইভাবে কোনো data key-এর জন্যঃ
position = hash(key)
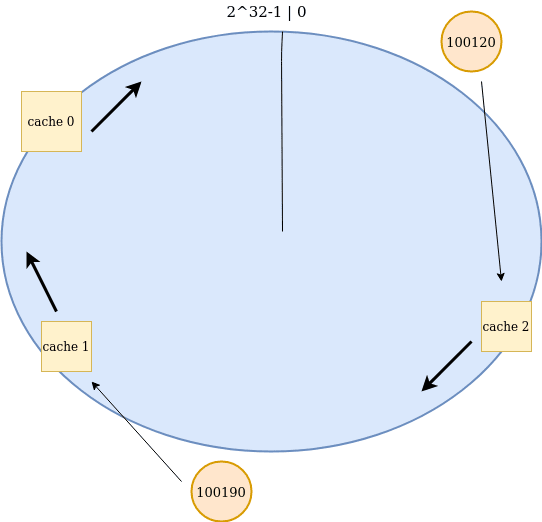
এখন key-টিও ring-এ একটি position পাবে। কিন্তু key-এর পাশে যে server থাকবে, সেটিই কি key-এর owner? সাধারণত rule-টি এমনঃ
Key-এর hash position থেকে clockwise direction-এ এগিয়ে গিয়ে যে প্রথম server/token পাওয়া যায়, key সেই node-এর দায়িত্বে থাকবে।
অর্থাৎ,
key → clockwise → first server
এবার আসল মজাঃ নতুন Server যোগ করলে?
ধরা যাক ring-এ আগে তিনটি server আছেঃ
Server 0
Server 1
Server 2
এবার Server 3 যোগ হলো। Server 3 ring-এর একটি নতুন position-এ বসবে। ধরো তার position Server 0 এবং Server 2-এর মাঝখানে। এখন ওই ছোট অঞ্চলের কিছু key, যেগুলো আগে Server 2-এর দায়িত্বে ছিল, সেগুলো Server 3-এর কাছে চলে যাবে। কিন্তু লক্ষ্য করো, অন্য ring region-এর key-গুলোর mapping অপরিবর্তিত থাকে। এটাই Consistent Hashing-এর সবচেয়ে গুরুত্বপূর্ণ সুবিধা। Traditional modulo hashing-এ server সংখ্যা পরিবর্তন করলে mapping অনেকটাই নতুন করে তৈরি হয়। Consistent Hashing-এ সাধারণ ধারণাটি হলোঃ
Node added
   ↓
একটি নির্দিষ্ট অংশের mapping বদলায়
   ↓
অন্য key-গুলো আগের জায়গায় থাকে
এই “কম remapping” property-টাই cache system-এর জন্য এত গুরুত্বপূর্ণ। NGINX-এর hash ... consistent implementation-ও node add/remove-এর সময় অল্প সংখ্যক key remap করার উদ্দেশ্যেই designed।
Server Down করলে?
এবার উল্টো scenario। ধরা যাক Server 1 হঠাৎ unavailable হয়ে গেল। Server 1-এর position ring থেকে সরিয়ে দেওয়া হলো। তারপর Server 1-এর দায়িত্বে থাকা key-গুলো ring-এ পরবর্তী available node-এ চলে যাবে। তাই পুরো cluster-এর সব key নতুন করে remap করতে হবে না। এটি distributed cache-এর ক্ষেত্রে বিশেষ গুরুত্বপূর্ণ, কারণ server failure-এর সময় cache mapping-এর বড় অংশ স্থিতিশীল রাখা যায়। তবে এখানে একটি subtle সমস্যা আছে। একটি server যদি বিশাল একটি ring region-এর মালিক হয়, তাহলে ওই পুরো region-এর traffic পরের server-এর কাছে চলে যেতে পারে। আর এখান থেকেই আসে পরবর্তী সমস্যা।
সমস্যা ১ঃ Server Distribution Uneven হতে পারে
Suppose ring-এ আমরা তিনটি server বসালামঃ
          Server A

 Server B          Server C
Hash function random-looking output তৈরি করলেও server-এর position এমন হতে পারে যে,
A → B = ছোট range
B → C = ছোট range
C → A = বিশাল range
তাহলে Server A এবং B কম key পেতে পারে, আর Server C বিশাল একটি range-এর দায়িত্ব নিতে পারে। অর্থাৎ,
Hashing হয়েছে ✓
কিন্তু Load balancing ideal নয় ✗
এখানে একটি গুরুত্বপূর্ণ lesson আছেঃ
Good hashing মানেই perfectly balanced workload নয়।
বিশেষ করে real-world system-এ key popularity সমান নয়। একটি “hot key” যেমন খুব জনপ্রিয় video বা product হাজার বা লাখ গুণ বেশি request পেতে পারে। AWS-এর ElastiCache guidance-ও consistent hashing থাকা সত্ত্বেও hot-key hotspot নজরে রাখার কথা বলে।
সমস্যা ২ঃ Domino Effect
এবার ধরো Server C-এর ওপর অনেক load। হঠাৎ Server C down করল। Server C-এর key-গুলোর দায়িত্ব next server-এর কাছে চলে গেল। ধরা যাক সেই server আগে থেকেই প্রায় capacity-এর কাছাকাছি ছিল। তাহলে,
Server C down
     ↓
Server B বেশি load পেল
     ↓
Server B overloaded
     ↓
Server B down
     ↓
আরও load → Server A
এটি অনেকটা domino-এর মতো। একটি failure থেকে আরেকটি failure তৈরি হতে পারে। তাই শুধু “consistent” হলেই হবে না। আমাদের distribution-ও ভালো করতে হবে।
সমাধানঃ Virtual Nodes
এখানে আসে Consistent Hashing-এর সবচেয়ে গুরুত্বপূর্ণ improvement:
Virtual Nodes বা VNodes
আগে আমরা একটি physical server-কে ring-এ একটি point-এ বসাচ্ছিলাম। এখন একই physical server-কে ring-এর অনেকগুলো logical position-এ বসাব। ধরা যাক,
Server A → A1, A2, A3, A4
Server B → B1, B2, B3, B4
Server C → C1, C2, C3, C4
এগুলো আলাদা physical machine নয়। এগুলো একই machine-এর virtual representation।
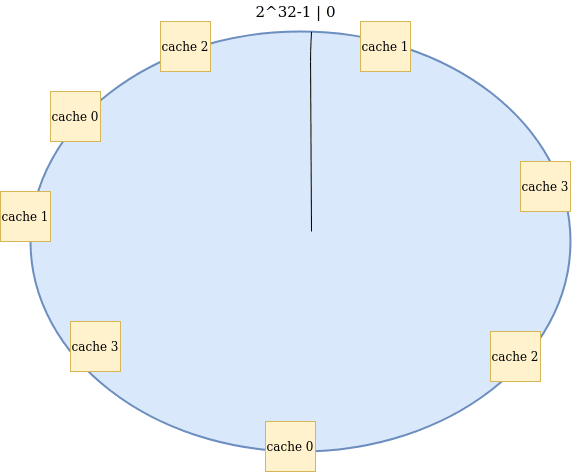
Virtual Node কেন এত কার্যকর?
কারণ একটি server এখন ring-এর এক জায়গায় আটকে নেই। ধরা যাক,
Server A:
A1, A2, A3, A4, A5...
তাহলে A-এর দায়িত্ব ring-এর অনেক জায়গায় ছড়িয়ে যাবে। এর ফলে,
Load distribution উন্নত হয়
একটি বড় continuous range-এর পরিবর্তে server ছোট ছোট অনেক range পায়।
Node failure-এর impact ভাগ হয়ে যায়
Server A down করলে A-এর সব virtual node একসঙ্গে চলে যাবে ঠিকই, কিন্তু তাদের successor বিভিন্ন physical server হতে পারে। অর্থাৎ সব traffic একটি server-এর ওপর পড়ার সম্ভাবনা কমে।
Heterogeneous server handle করা যায়
ধরা যাক,
Server A = 2 CPU
Server B = 8 CPU
Server C = 16 CPU
তখন capacity অনুযায়ী virtual node/token-এর সংখ্যা বা weight আলাদা করা যেতে পারে। অর্থাৎ সব server-কে সমান শক্তিশালী ধরে নেওয়া বাধ্যতামূলক নয়। Dynamo architecture-এ virtual node-এর ধারণাটি distributed partitioning-এর একটি গুরুত্বপূর্ণ অংশ ছিল; Cassandra-ও token-ring based partitioning এবং replication ব্যবহার করে।
“VNodes বেশি দিলেই কি সব সমস্যা শেষ?”
না। এখানে আবার engineering trade-off আছে। VNode সংখ্যা খুব কম হলে,
Distribution → uneven হতে পারে
আর খুব বেশি হলে,
Ring metadata → বাড়বে
Membership state → বাড়বে
Management complexity → বাড়বে
তবে একটি common misconception হলো, “VNode বেশি হলে lookup অবশ্যই অনেক slow হবে।” বাস্তব implementation-এ ring/token positions সাধারণত sorted রাখা হয় এবং lookup-এর জন্য binary search ব্যবহার করা যায়। ফলে V সংখ্যক virtual node থাকলে mapping lookup আনুমানিকঃ
O(log V)
হতে পারে। অর্থাৎ data structure ভালোভাবে ব্যবহার করলে অনেক token থাকা মানেই linear scan করতে হবে এমন নয়।
Consistent Hashing শুধু Cache-এর জন্য নয়
Distributed cache খুব জনপ্রিয় use case হলেও Consistent Hashing-এর ধারণা আরও বড়। এটি ব্যবহার করা যেতে পারেঃ
Distributed Cache
Database Sharding
Request Routing
Session Affinity
Partitioned Storage
CDN / Content Routing
Message Workload Sharding
Memcached-এর proxy implementation-এ request key-এর ভিত্তিতে backend নির্বাচন করতে consistent hashing ব্যবহার করা হয়। NGINX-ও hash ... consistent দিয়ে key-based consistent routing সমর্থন করে। Google Cloud-এর GKE networking documentation-এ RING_HASH এমন workload-এর জন্য উল্লেখ করা হয়েছে যেখানে scaling-এর সময় cache stability গুরুত্বপূর্ণ। আর একটি গুরুত্বপূর্ণ clarification: সব distributed database consistent hashing ব্যবহার করে না। উদাহরণ হিসেবে Redis Cluster consistent hashing ব্যবহার করে না; এটি 16,384টি hash slot-এ key map করে এবং node-গুলোর মধ্যে slot assign করে। তাই “Distributed System = Consistent Hashing” এমন কোনো universal rule নেই।
Service Discovery কোথায় আসবে?
এখনও একটি প্রশ্ন থেকে যায়। Application কীভাবে জানবে,
বর্তমানে কোন server alive?
কোন server নতুন এসেছে?
কোন server remove হয়েছে?
কোন node-এর address কী?
এর জন্য প্রয়োজন service discovery / cluster membership mechanism। একটি architecture এমন হতে পারেঃ
                Service Discovery
                / Membership Store
                       |
            ┌──────────┼──────────┐
            ↓          ↓          ↓
         Cache A    Cache B    Cache C
            \          |          /
             \         |         /
              ---- Hash Ring ----
                      ↑
                      |
                  Application
এখানে service discovery layer cluster membership-এর information রাখতে পারে এবং application সেই topology অনুযায়ী ring তৈরি করতে পারে। etcd এই ধরনের distributed infrastructure-এর একটি পরিচিত building block; এর ecosystem-এ naming/discovery-related functionality-ও রয়েছে। তবে etcd-এর discovery protocol-কে runtime cluster membership management-এর সঙ্গে গুলিয়ে ফেলা উচিত নয়। etcd-এর বর্তমান documentation স্পষ্ট করে যে তাদের discovery protocol মূলত cluster bootstrap-এর জন্য। আধুনিক Kubernetes-based system-এ service discovery, health checking এবং endpoint management অনেক সময় platform নিজেই সামলায়। ফলে developer-কে সবসময় আলাদা coordinator service হাতে বানাতে হয় না।
একটি গুরুত্বপূর্ণ বিষয়ঃ Consistent Hashing সব Failure Solve করে না
এখানেই system design-এর আসল শিক্ষা। Consistent Hashing মূলত remapping problem কমায়। কিন্তু এটি নিজে থেকে সমাধান করে নাঃ
Hot Key
Cache Stampede
Network Partition
Replication
Data Loss
Cold Cache
Slow Database
ধরা যাক একটি video এত জনপ্রিয় যে প্রতি সেকেন্ডে ১০ লাখ request আসছে। Video-এর key perfectly hash করা হলেও সেটি যে node-এর কাছে যাবে, সেই node-এর ওপর বিশাল traffic পড়বে। এটা hot key problem। আবার database থেকে একই missing item আনতে একসঙ্গে হাজার request গেলে cache stampede হতে পারে। সুতরাং, একটি production-grade system-এ consistent hashing-এর পাশাপাশি প্রয়োজন হতে পারেঃ
Replication
TTL
Cache Warming
Request Coalescing
Rate Limiting
Hot-Key Detection
Health Checking
Autoscaling
Circuit Breaking
একটি algorithm সাধারণত পুরো distributed system-এর উত্তর নয়; এটি architecture-এর একটি গুরুত্বপূর্ণ building block।
একটি সহজ Implementation Idea
ধরা যাক আমাদের ring-এ virtual node/token রয়েছে,
[
  (100, Server A),
  (250, Server C),
  (430, Server B),
  (700, Server A),
  (910, Server C)
]
এখন,
position = hash(key)
তারপর sorted token list-এ position-এর সমান বা তার পরের প্রথম token খুঁজব। Pseudo-code:
function getServer(key):
    position = hash(key)
    index = lowerBound(sortedTokens, position)

    if index == tokens.length:
        index = 0

    return tokens[index].server
এখানে lowerBound ব্যবহার করার কারণে token list অনেক বড় হলেও lookup efficient রাখা যায়।
Traditional Hashing বনাম Consistent Hashing
| বিষয় | Traditional hash(key) % N | Consistent Hashing |
|---|---|---|
| Server add/remove | অনেক key remap হতে পারে | তুলনামূলক অল্প key remap হয় |
| Cache hit stability | membership change-এ খারাপ হতে পারে | বেশি স্থিতিশীল |
| Load distribution | hash quality-এর ওপর নির্ভরশীল | VNode দিয়ে আরও নিয়ন্ত্রণযোগ্য |
| Failure handling | mapping ব্যাপকভাবে বদলাতে পারে | affected region-এর মধ্যে সীমাবদ্ধ রাখা যায় |
| Implementation | খুব সহজ | তুলনামূলক জটিল |
| Virtual node support | সাধারণত নেই | খুব গুরুত্বপূর্ণ technique |
Performance-কে আরেক ধাপ এগিয়ে নিয়ে গেলে
একটি production system-এ শুধু ring বানিয়ে বসে থাকলেই হবে না। তোমাকে monitor করতে হবে,
Cache Hit Ratio
Cache Miss Ratio
Request Rate
p95 / p99 Latency
CPU
Memory
Hot Keys
Eviction Rate
Node Failure Rate
Rebalancing Cost
কারণ ring mathematically সুন্দর হলেও real traffic mathematically সুন্দর হয় না। মানুষ সমান হারে YouTube video দেখে না। একজন creator-এর একটি video হয়তো ১০০ request পাবে, আর অন্য একটি video ১০ কোটি request পেতে পারে। তাই hash distribution + workload distribution দুটিকে আলাদা করে ভাবতে হবে।
ভবিষ্যতে Consistent Hashing-এর গুরুত্ব কোথায়?
Cloud infrastructure যত বেশি elastic হচ্ছে, node add/remove তত স্বাভাবিক ঘটনা হয়ে উঠছে। Autoscaling-এর কারণে,
10 nodes
   ↓
20 nodes
   ↓
8 nodes
   ↓
15 nodes
এমন পরিবর্তন automated ভাবেই ঘটতে পারে। Edge computing, distributed cache, stateful services এবং geographically distributed infrastructure-এও node membership পরিবর্তন একটি বাস্তব সমস্যা। এই কারণেই future system design-এ মূল প্রশ্নটি শুধুঃ
“কোন server-এ data রাখব?”
এতটুকু নয়। বরং,
“আগামীকাল যদি এই cluster-এর অর্ধেক topology বদলে যায়, তাহলে কতটা data এবং traffic নতুনভাবে redistribute করতে হবে?”
Consistent hashing-এর শক্তি এখানেই। এটি system-কে এমনভাবে design করতে সাহায্য করে যাতে infrastructure পরিবর্তন মানেই পুরো data universe-কে lottery machine-এর মধ্যে ঢুকিয়ে দেওয়া না হয়।
শেষ কথা
Consistent Hashing-এর পুরো idea-টা মনে রাখার সবচেয়ে সহজ উপায় হলো চারটি ধাপঃ
1. Hash Space → একটি Ring
2. Server → Ring-এর position/token
3. Key → Ring-এর position
4. Clockwise next token → Responsible node
তারপর আসে আসল engineering:
Virtual Nodes
        ↓
Better distribution
        ↓
Failure impact ছড়িয়ে দেওয়া
        ↓
Scalable cluster
তাই Consistent Hashing-এর আসল সৌন্দর্য শুধু hashing-এ নয়। Server বাড়লেও, কমলেও, পুরো cluster-কে আবার নতুন করে শুরু করতে না হয়, এই stability-টাই এর মূল শক্তি। Distributed System শিখতে গেলে এটি শুধু একটি algorithm নয়; এটি শেখায় কীভাবে change, failure এবং scale এই তিনটি জিনিসকে মাথায় রেখে system design করতে হয়।