#Binary Search #Lower Bound #Upper Bound #Time Complexity #Algorithm #Data Structures #Competitive Programming #C++ #C++17 #Problem Solving #Searching Algorithm #Array #Big O #DSA
Binary Search: খোঁজার কাজটাকে কীভাবে O(log n)-এ নামিয়ে আনা যায়?
2026-09-04 · 9 min read
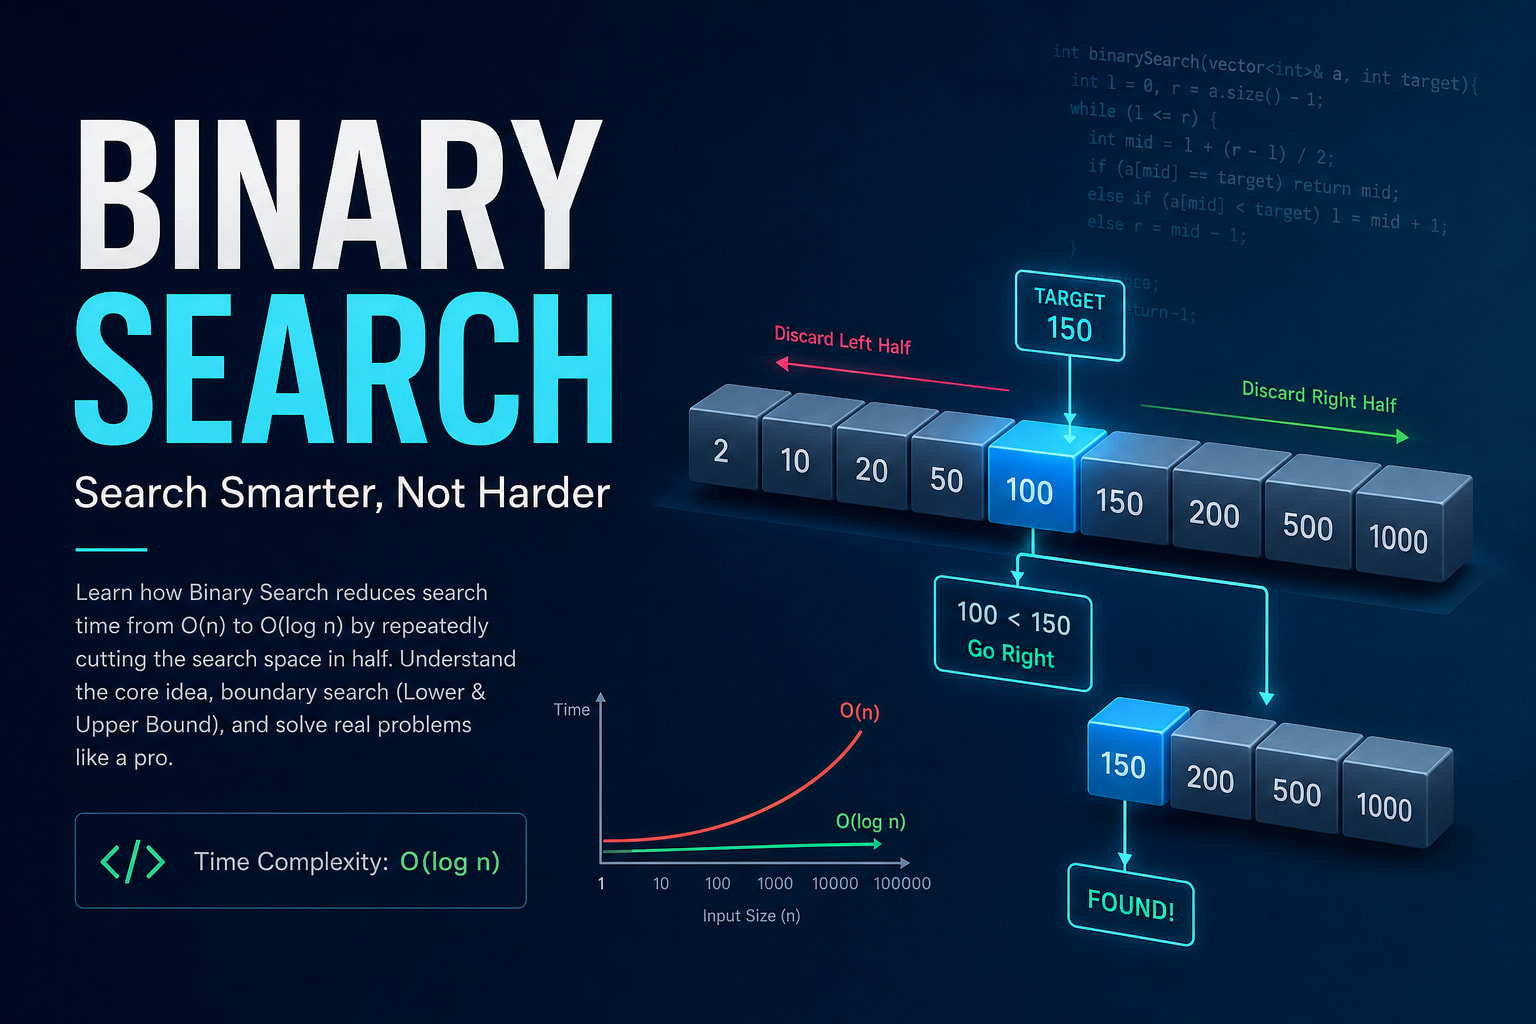
ধরো, তোমার কাছে একটা বিশাল বইয়ের index আছে। তুমি “Database” শব্দটা খুঁজছ। এখন যদি প্রথম পৃষ্ঠা থেকে একে একে প্রতিটি শব্দ পরীক্ষা করতে থাকো, সেটা হবে বেশ কষ্টকর। কিন্তু dictionary-তে শব্দগুলো alphabetically সাজানো থাকে বলেই তুমি মাঝামাঝি জায়গা থেকে শুরু করে বুঝতে পারো তোমার কাঙ্ক্ষিত শব্দটা বামে, নাকি ডানে। এই ছোট্ট observation-টাই Binary Search-এর মূল শক্তি।
“সবকিছু পরীক্ষা করার দরকার নেই; সঠিক information থাকলে প্রতিবার search space-এর একটি বড় অংশ বাদ দেওয়া যায়।”
Linear Search-এর পুরোনো ঝামেলা
ধরো array:
100 2 10 50 20 500 100 150 200 1000
এখান থেকে 500 খুঁজতে হলে সাধারণভাবে শুরু থেকে পরীক্ষা করতে হবে। Worst case-এ array-এর প্রায় সব element দেখতে হতে পারে। Array-এর size n হলেঃ
Time Complexity = O(n)
অর্থাৎ n যত বড় হবে, search তত ধীর হতে পারে। এক মিলিয়ন element-এর array-তে একবার search করা হয়তো manageable। কিন্তু একই data-তে যদি হাজার হাজার query চালাতে হয়, তখন এই approach দ্রুতই expensive হয়ে যায়।
Sorted Data কেন এত powerful?
এবার একই data-কে sort করিঃ
2 10 20 50 100 150 200 500 1000
এখন 150 খুঁজব। পুরো array scan করার পরিবর্তে মাঝের element দেখি।
2 10 20 50 [100] 150 200 500 1000
100 < 150, তাহলে আমরা নিশ্চিত বামের অংশে 150 থাকার কোনো সুযোগ নেই। সুতরাং বামের অংশ বাদ।
150 200 500 1000
আবার middle দেখি।
150 [200] 500 1000
200 > 150, তাহলে ডান পাশের অংশ বাদ।
150
পেয়ে গেলাম! এখানে আসল trick হলো, প্রতিটি ধাপে পুরো search space-এর একটা বড় অংশ বাতিল করে দেওয়া। এটাই Binary Search।
কেন O(log n)?
প্রতিবার search করার সময় element-এর সংখ্যা প্রায় অর্ধেক হয়ে যায়। ধরো শুরুতে nটি element ছিলঃ
n
n/2
n/4
n/8
n/16
...
1
প্রশ্ন হলো, n-কে কতবার 2 দিয়ে ভাগ করলে 1-এর কাছাকাছি যাওয়া যায়? উত্তরঃ
log₂(n)
তাই Binary Search-এর worst-case complexity:
O(log n)
একটু ধারণা নিতেঃ
n = 1,024
হলে প্রায় 10 ধাপেই search space 1-এ নেমে আসে। আরঃ
n = 1,000,000
হলেও প্রায় 20টি comparison-এর কাছাকাছি যথেষ্ট হতে পারে। এটাই Binary Search-এর আসল জাদু। জাদু নয় অবশ্য, logarithm।
Binary Search-এর সবচেয়ে গুরুত্বপূর্ণ শর্ত
এখানে একটা catch আছে। সাধারণ Binary Search করতে হলে search space-এ monotonic/order relationship থাকতে হবে। Classic array search-এর ক্ষেত্রে সেই requirement হলোঃ
Array-টি sorted হতে হবে।
যেমনঃ
2 10 20 50 100 150 200 500
এখানে আমরা জানি, কোনো middle value যদি target-এর চেয়ে বড় হয়, তাহলে তার ডান পাশেও target পাওয়া যাবে না। কিন্তুঃ
50 2 100 20 500 10
এরকম random array-তে এই logic কাজ করবে না।
তাহলে আগে sort করলে সমস্যা কোথায়?
চমৎকার প্রশ্ন। একবারের জন্য কোনো unsorted array-তে search করতে হলেঃ
Linear Search → O(n)
অনেক সময় sorting করে তারপর binary search করার চেয়ে সেটাই ভালো। কারণ sorting-এর জন্য comparison-based sorting-এর ক্ষেত্রে সাধারণতঃ
O(n log n)
সময় লাগতে পারে। কিন্তু একই dataset-এ বারবার search করতে হলে picture বদলে যায়। ধরো,
1,000,000 elements
100,000 searches
তখন data একবার sort করে রেখে প্রতিটি query Binary Search দিয়ে handle করা অনেক বেশি কার্যকর। অর্থাৎ,
One search       → Linear Search may be enough
Many searches    → Sort once + Binary Search
এই idea-টাই real-world systems-এ খুব গুরুত্বপূর্ণ।
Binary Search-এর আরও বড় ব্যবহার
শুধু “এই সংখ্যাটা আছে কি না” খুঁজেই Binary Search শেষ নয়। Sorted data-তে আমরা আরও interesting প্রশ্ন করতে পারিঃ
প্রথম
>= Xকোথায়?প্রথম
> Xকোথায়?শেষ
<= Xকোথায়?একটি range-এর মধ্যে মোট কয়টি value আছে?
কোনো condition প্রথম কোথায় সত্য হয়?
এই family-এর সমস্যাগুলোকে আমরা অনেক সময় boundary search বা binary search on answer/position হিসেবে দেখি। এখানেই আসে Lower Bound এবং Upper Bound।
Lower Bound কী?
ধরো sorted array:
10 20 20 30 30 40 50
আমরা 20-এর lower bound খুঁজছি।
Lower Bound হলোঃ
সবচেয়ে বাম position যেখানে
Xবসালেও array sorted থাকবে।
তাই 20-এর জন্য answer:
index = 1
কারণ index 1-এ আরেকটি 20 বসালেও ordering নষ্ট হবে না। আর 25-এর lower bound?
10 20 20 30 30 40 50
      ↑
Answer:
index = 3
সহজভাবে,
Lower Bound = প্রথম index যেখানে
array[index] >= X
Upper Bound কী?
এবার 20-এর upper bound দেখি। Upper Bound হলোঃ
প্রথম position যেখানে
X-এর চেয়ে strictly বড় value পাওয়া যায়।
Array:
10 20 20 30 30 40 50
20-এর upper bound:
index = 3
কারণ index 3-এ 30, যা 20-এর চেয়ে বড়। সহজভাবে,
Upper Bound = প্রথম index যেখানে
array[index] > X
এই দুই boundary-ই competitive programming-এ অসংখ্য সমস্যার দরজা খুলে দেয়।
Duplicate থাকলে Binary Search কীভাবে বদলায়?
ধরো,
10 20 20 20 30 40
তুমি 20 খুঁজলে মাঝের কোনো 20 পেয়ে search বন্ধ করে দিতে পারো। কিন্তু যদি প্রশ্ন হয়,
“সবচেয়ে বাম
20কোথায়?”
তাহলে প্রথম 20 পেলেই থামা যাবে না। একবার match পাওয়ার পরও আমাদের বাম দিকে search চালিয়ে যেতে হবে। অর্থাৎ,
match পেলাম
     ↓
answer save করলাম
     ↓
আরও বামে search করলাম
এটাই lower-bound style binary search-এর fundamental idea।
একটি গুরুত্বপূর্ণ implementation trick
Modern code-এ middle index সাধারণত এভাবে লেখা নিরাপদ:
int mid = left + (right - left) / 2;
শুধু
int mid = (left + right) / 2;
লিখলে খুব বড় integer range-এ left + right overflow করার ঝুঁকি থাকতে পারে। ছোট input-এ হয়তো কখনো সমস্যা দেখবে না, কিন্তু robust code লেখার অভ্যাস শুরু থেকেই ভালো।
Array বনাম Linked List
Binary Search নিয়ে আরেকটা interesting observation আছে। Array-তেঃ
arr[mid]
দিয়ে random access করা যায়। তাই middle element পাওয়া খুব সহজ। কিন্তু linked list-এ mid position-এ সরাসরি jump করা যায় না। সেখানে node ধরে ধরে এগোতে হয়। তাই linked list-এর উপর classic Binary Search-এর সুবিধাটা অনেকটাই নষ্ট হয়ে যায়। এই কারণেই algorithm বাছাইয়ের সময় শুধু “algorithm fast কি না” দেখলেই হবে না। Data structure-টাও algorithm-এর অংশ।

এবার আসল challenge: Binary Search দিয়ে একটা real problem
এখন একটি problem solve করি, যেখানে Lower Bound এবং Upper Bound-এর ধারণা সরাসরি কাজে লাগবে।
[Practice Problem] LightOJ 1088: Points in Segments
তোমাকে একটি ascending sorted array দেওয়া থাকবে। এরপর অনেকগুলো query আসবে। প্রতিটি query-তে একটি segment:
[L, R]
দেওয়া হবে। প্রতিটি query-র জন্য বলতে হবেঃ
LথেকেRপর্যন্ত মোট কয়টি point আছে?
অর্থাৎ আমাদের count করতে হবেঃ
L <= point <= R
Problem-এর constraint-এ,
N ≤ 100000
Q ≤ 50000
তাই প্রতিটি query-তে পুরো array scan করলে worst-case complexity হবে
O(N × Q)
যা প্রায়
100000 × 50000
= 5 × 10⁹
comparison পর্যন্ত যেতে পারে। এটা যথেষ্ট বড়। Problem statement এবং current official LightOJ page-এও binary-search-based solution-এর O(Q log N) complexity দেখানো হয়েছে।
Better Approach: দুইটা Boundary বের করো
ধরো array:
1 4 6 8 10
Query:
[0, 5]
আমাদের answer:
1, 4
অর্থাৎ 2। এখন,
Step 1:L-এর Lower Bound
L = 0 প্রথম কোন index-এ value >= 0?
index = 0
Step 2:R-এর Upper Bound
R = 5 প্রথম কোন index-এ value > 5?
index = 2
তাহলে মাঝখানের valid element count:
2 - 0 = 2
সুতরাং,
answer = upper_bound(R) - lower_bound(L)
এই এক লাইনের formula-টাই পুরো problem-এর heart।
আরেকটা উদাহরণ
Array:
1 4 6 8 10
Query:
[6, 10]
Lower Bound of 6:
index = 2
Upper Bound of 10:
index = 5
তাই,
5 - 2 = 3
Valid points:
6 8 10
Answer:
3Modern C++17 Solution
C++ Standard Library-তে lower_bound() এবং upper_bound() already available আছে।
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int T;
    cin >> T;

    for (int tc = 1; tc <= T; ++tc) {
        int n, q;
        cin >> n >> q;

        vector<int> points(n);

        for (int &x : points) {
            cin >> x;
        }

        cout << "Case " << tc << ":\n";

        while (q--) {
            int L, R;
            cin >> L >> R;

            auto left = lower_bound(points.begin(), points.end(), L);
            auto right = upper_bound(points.begin(), points.end(), R);

            cout << (right - left) << '\n';
        }
    }

    return 0;
}
Code-টা আসলে কী করছে?
এই line:
lower_bound(points.begin(), points.end(), L);
খুঁজছে
প্রথম value >= L
আর
upper_bound(points.begin(), points.end(), R);
খুঁজছে
প্রথম value > R
দুই iterator-এর distance:
right - left
হলো [L, R] range-এর মধ্যে থাকা element-এর সংখ্যা।
Complexity
প্রতিটি query-তে,
lower_bound → O(log N)
upper_bound → O(log N)
তাই একটি query-এর overall complexity:
O(log N)
এবং Qটি query থাকলে,
O(Q log N)
প্রতিটি test case-এ array storage-এর জন্য,
O(N)
extra memory লাগে। LightOJ-এর problem analysis-ও এই O(Q log N) / O(N) complexity উল্লেখ করে।
সবচেয়ে গুরুত্বপূর্ণ takeaway
Binary Search মুখস্থ করার algorithm নয়; এটি একটি way of thinking। যখনই দেখবে,
Data sorted
+
Search / Boundary / Range query
+
Repeated queries
তখন নিজের কাছে কয়েকটি প্রশ্ন করো,
আমি কি search space অর্ধেক করে ফেলতে পারি?
প্রথম >= X কোথায়?
প্রথম > X কোথায়?
কোন boundary-এর difference নিলে answer পাওয়া যায়?
অনেক সময় পুরো problem-এর answer এই প্রশ্নগুলোর মধ্যেই লুকিয়ে থাকে। আর সবচেয়ে সুন্দর ব্যাপার? Binary Search শুধু array search-এ আটকে নেই। ভবিষ্যতে তুমি দেখবে, একই idea দিয়ে minimum possible answer, maximum feasible value, first valid position, capacity, scheduling, optimization এমন অনেক problem-ও solve করা যায়। অর্থাৎ,
আজ তুমি একটা সংখ্যা খুঁজছ।
কাল হয়তো পুরো solution space-টাই Binary Search করবে।
Happy Coding!