#ব্লুম ফিল্টার #ডেটা স্ট্রাকচার #প্রোবাবিলিটি #ব্যাকএন্ড ইঞ্জিনিয়ারিং #lsm tree #count-min sketch
ব্লুম ফিল্টারঃ লাখো নামের তালিকা ছাড়াই কীভাবে দ্রুত “নেই” বলা যায়?
2026-09-17 · 8 min read
ধরুন, আপনার অ্যাপে নতুন একজন ব্যবহারকারী নাম রাখতে চান ZARA। নামটি আগে কেউ নিয়েছেন কি না, তা জানতে ডেটাবেসে খোঁজ করা যায়। একটি অনুরোধে সমস্যা নেই; কিন্তু একই পরীক্ষা যদি দিনে লাখ লাখ বার হয়, তখন প্রতিটি অপ্রয়োজনীয় ডেটাবেস খোঁজেরও খরচ আছে। এমন সময় ব্লুম ফিল্টার হতে পারে দরজার নিরাপত্তারক্ষী। সে কোনো নাম নেই বলতে পারে, আর থাকতে পারে বললে ভেতরে গিয়ে যাচাই করতে হয়। নিরাপত্তারক্ষীকে অবশ্য রেজিস্ট্রেশন অনুমোদনের দায়িত্ব দেওয়া যাবে না!
১২টি বিটের ছোট্ট পরীক্ষা
ব্লুম ফিল্টার আসলে (m)টি বিটের সারি; শুরুতে সবগুলো ০। একটি নাম যোগ করতে (k)টি hash function সেটিকে (k)টি অবস্থানে পাঠায়, আর সেই বিটগুলো ১ করা হয়। বাস্তবে hash-এর ফল নির্দিষ্ট অ্যালগরিদমে বের হবে।
ধরি, (m=12), (k=3)। RIMA গেল ১, ৪, ৯ নম্বর ঘরে; NABIL গেল ২, ৪, ১০ নম্বরে। ৪ নম্বর ঘর দুজনেই ব্যবহার করেছে। এক ঘরে দুজনের “চিহ্ন” রাখা নিয়ে বিটটির কোনো আপত্তি নেই।
এবার ZARA খুঁজতে গিয়ে অবস্থান পাওয়া গেল ১, ৫, ১০। ৫ নম্বর বিট ০, তাই ZARA এই ফিল্টারে যোগ করা হয়নি, উত্তর নিশ্চিত। কিন্তু TANIA-র অবস্থান ১, ৪, ১০ হলে সব বিটই ১ পাওয়া যাবে, যদিও TANIA-কে আমরা যোগ করিনি। এটাই false positive: “থাকতে পারে”, অথচ বাস্তবে নেই। সম্পূর্ণ ও সঠিকভাবে আপডেট করা সাধারণ ব্লুম ফিল্টারে false negative হয় না; তবে ফিল্টার পুরোনো হয়ে গেলে এই নিশ্চয়তা বর্তমান ডেটাবেসের জন্য আর প্রযোজ্য থাকে না। Redis-এর ব্যাখ্যাও এই একমুখী নিশ্চয়তাকে ভিত্তি করে।
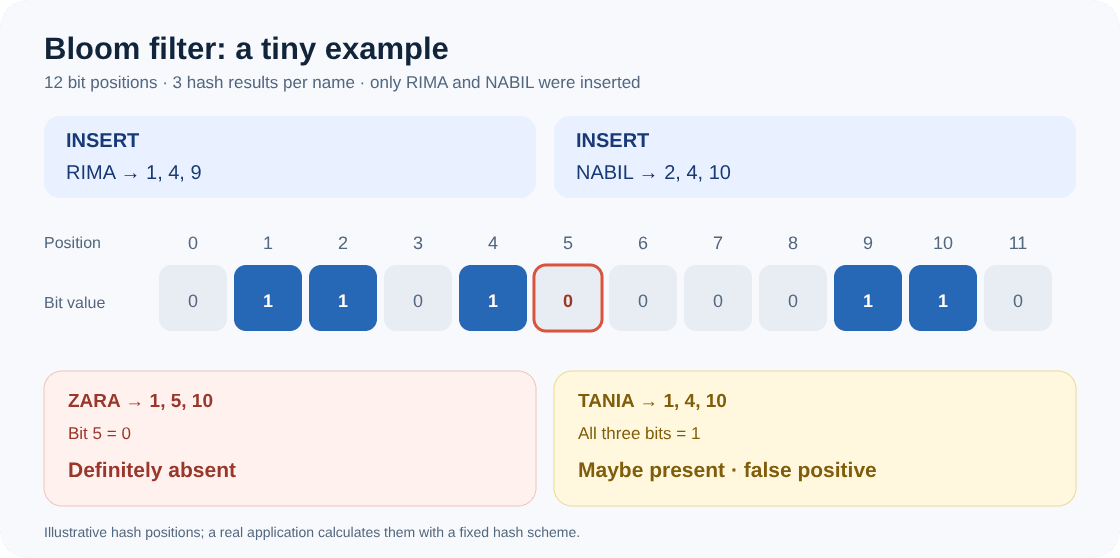
চিত্র ১: বিট ০ পেলেই নিশ্চিত ‘নেই’; সব বিট ১ হলে উত্তর শুধু ‘হয়তো’।
কম জায়গা লাগে, কিন্তু “০.১” আর “০.১%” এক নয়
বিটের সংখ্যা (m), যোগ করা আইটেমের সংখ্যা (n), আর hash function-এর সংখ্যা (k) হলে আনুমানিক false-positive হারঃ p ≈ (1 − e^(−kn/m))^k
এখানে একটি সহজে হওয়া ভুলঃ (p=0.1) মানে ১০%, আর ০.১% মানে (p=0.001)। দশ লাখ আইটেমে ০.১% লক্ষ্য ধরলে আদর্শ হিসাবে প্রায় ১.৮ MB-এর bit array এবং ১০টি hash লাগে। hash-এর সংখ্যা ৫-এ আটকে রাখলে একই লক্ষ্য পূরণে প্রায় ২.১৬ MB লাগে। ৬১২ KiB ও ৫টি hash ব্যবহার করলে হারটি প্রায় ১০%। এগুলো bit array-এর আনুমানিক মাপ; সফটওয়্যারের metadata ও scaling-এর অতিরিক্ত খরচ আলাদা। Redis-এর sizing সূত্র দিয়ে এই হিসাব করা যায়।
অর্থাৎ, ব্লুম ফিল্টার “বিনামূল্যের গতি” নয়। কম false positive চাইলে বেশি মেমরি বা বেশি hash computation দিতে হবে। পরীক্ষা করার সময় (O(k)); (k) স্থির রাখলে ব্যবহারিক অর্থে তা প্রায় constant time।
ওয়েব অ্যাপে বসাবেন কোথায়?
জনসমক্ষে username যাচাইয়ের ক্ষেত্রে সবচেয়ে নিরাপদ নকশা হলো সার্ভারে ফিল্টার রাখা। ফিল্টার “থাকতে পারে” বললে ডেটাবেসে যাচাই করুন। “নেই” বললেও চূড়ান্ত রেজিস্ট্রেশনের সময় ডেটাবেসের unique constraint-ই শেষ কথা। অন্য কেউ এক সেকেন্ড আগে একই নাম নিতে পারেন, অথবা ফিল্টার তখনো আপডেট না-ও হয়ে থাকতে পারে।
তাহলে browser-এ ফিল্টার পাঠানো যায় না? যায়, কিন্তু bit array-এর সঙ্গে browser ও server-এ একই text normalization, hash algorithm, seed, (m), (k), এবং filter version লাগবে। JavaScript code অ্যাপে আগে থেকেই থাকতে পারে; প্রতিবার আলাদা “hash function ফাইল” পাঠানো বাধ্যতামূলক নয়। hash-কে গোপন চাবিও ভাবা যাবে না। public browser-এ username filter দিলে কেউ অনেক সম্ভাব্য নাম পরীক্ষা করে অ্যাকাউন্টের অস্তিত্ব সম্পর্কে ধারণা পেতে পারে। এটি পদ্ধতিটির বৈশিষ্ট্য থেকে করা নিরাপত্তা-সংক্রান্ত অনুমান। তাই সংবেদনশীল তালিকার জন্য server-side prefilter বেছে নিন। Browser-এর ফল কেবল আগাম ইঙ্গিত, কর্তৃত্বপূর্ণ সিদ্ধান্ত নয়।
ডেটাবেসে এর কাজ আরও বাস্তব
LSM-ভিত্তিক স্টোরেজে নতুন তথ্য আগে memory-র memtable-এ আসে, পরে sorted SST ফাইলে যায়; compaction পুরোনো ফাইলগুলো পুনর্গঠন করে। কোনো key খোঁজার সময় একাধিক SST ফাইল সম্ভাব্য প্রার্থী হতে পারে। ফাইলের Bloom filter “এই key নেই” বললে সেই ফাইলের data block পড়ার খরচ বাঁচে; “থাকতে পারে” বললে স্বাভাবিক খোঁজ চলতে থাকে। RocksDB-এর নিজস্ব নথিতে SST ফাইলের filter-এর এই ব্যবহার দেখানো আছে।
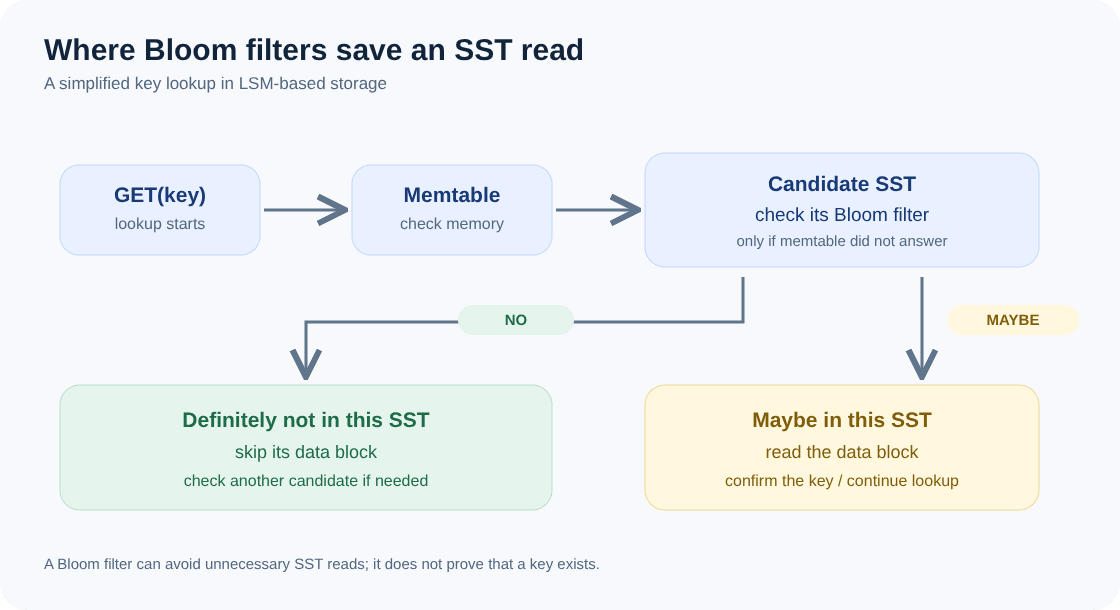
চিত্র ২: যে SST ফাইলে key নিশ্চিত নেই, তার data block পড়া এড়ানো যায়।
আর যদি প্রশ্ন হয় “কতবার”?
Bloom filter উত্তর দেয় “যোগ করা হয়েছিল কি?”। ভিডিওটি কতবার দেখা হয়েছে বা কোনো শব্দ কতবার সার্চ হয়েছে, এটি তার কাজ নয়। সেই প্রশ্নের জন্য সম্পর্কিত আরেকটি probabilistic structure হলো Count-Min Sketch। এখানে বিটের বদলে কয়েক সারি counter থাকে: নতুন ঘটনা এলে প্রতিটি সারির একটি counter বাড়ে; হিসাব জানতে ওই counter-গুলোর সর্বনিম্ন মান নেওয়া হয়। সংঘর্ষ হলে আসল সংখ্যার চেয়ে বেশি দেখাতে পারে, কিন্তু শুধু ধনাত্মক increment থাকলে কম দেখায় না।
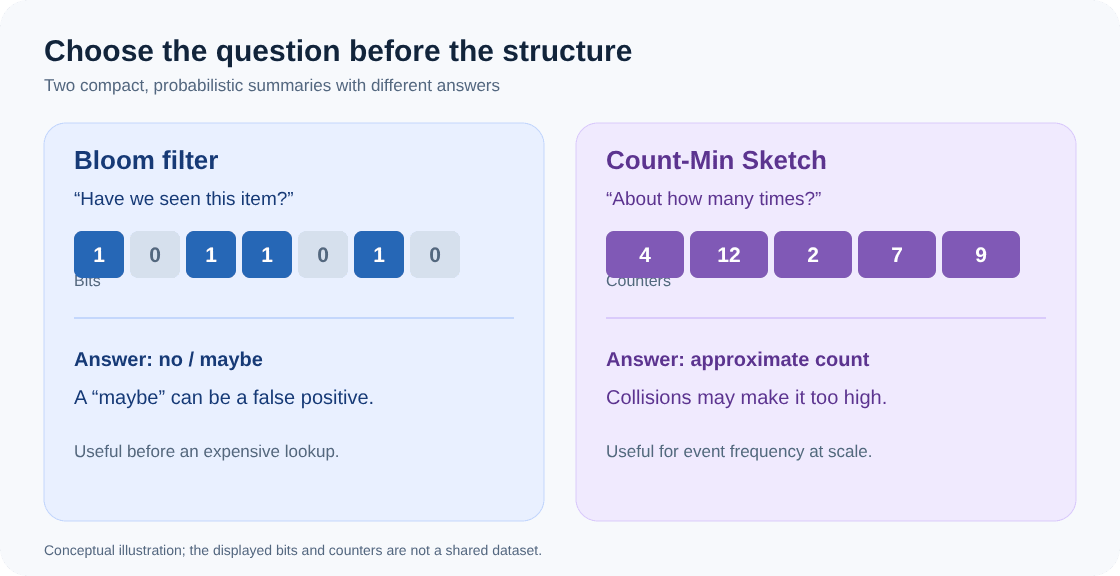
চিত্র ৩: প্রশ্ন বদলালে ডেটা স্ট্রাকচারও বদলায়।
দুর্বল বা ফাঁস হওয়া password-এর blocklist-ও দ্রুত যাচাইয়ের একটি প্রয়োগ হতে পারে। তবে filter positive হলে আসল তালিকায় মিলিয়ে দেখতে হবে, আর যাচাইটি সার্ভারে রাখতে হবে।
আগামী দিনের ব্যবহারেও কয়েকটি নিয়ম একই থাকবে
ডেটা বাড়তে থাকলে আগে থেকেই capacity ও গ্রহণযোগ্য false-positive হার ঠিক করুন; ভরে যাওয়া filter-এর ভুলের হার বাড়ে। প্রয়োজনমতো scalable Bloom filter বা নতুন version তৈরি করুন। সাধারণ Bloom filter থেকে একটি আইটেম মুছতে সরাসরি বিট ০ করবেন না। সেই বিট অন্য আইটেমেরও হতে পারে। মুছে ফেলা প্রয়োজন হলে rebuild, counting variant, অথবা deletion-supporting Cuckoo filter বিবেচনা করুন।
শেষ কথাঃ Bloom filter এক ধরনের দ্রুত “না” বলার যন্ত্র। তার “হয়তো” শুনে যাচাই করুন, আর ডেটাবেসের নিশ্চিত সত্যকে জায়গামতো রাখুন। সঠিক প্রশ্নে ব্যবহার করলে কয়েকটি বিটই অনেক অপ্রয়োজনীয় কাজ বাঁচায়; ভুল প্রশ্ন করলে সেই বিটগুলো কেবল আত্মবিশ্বাসী বিভ্রান্তি!