#ডিস্ট্রিবিউটেড সিস্টেম #ডিস্ট্রিবিউটেড ফাইল সিস্টেম #hdfs #hadoop #বিগ ডেটা #ডেটা রেপ্লিকেশন #ফল্ট টলারেন্স #namenode #ইরেজার কোডিং #mapreduce #ডেটা ইঞ্জিনিয়ারিং #অবজেক্ট স্টোরেজ #apache iceberg #স্কেলেবিলিটি
ডিস্ট্রিবিউটেড ফাইল সিস্টেম আসলে কী
2026-09-10 · 22 min read
ধরো তোমার টিম লিড এসে বলল, "গত এক সপ্তাহের সার্ভার লগ থেকে বের করো কোন এন্ডপয়েন্টগুলো সবচেয়ে বেশি ৫০০ দিচ্ছে।" তুমি ভাবলে, সহজ কাজ। একটা পাইথন স্ক্রিপ্ট, দশ মিনিট।
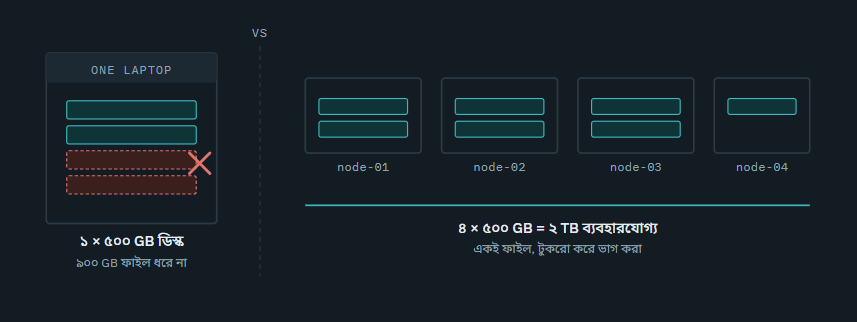
তারপর তুমি ফাইলের সাইজ দেখলে ৯০০ গিগাবাইট। তোমার ল্যাপটপে ৫১২ GB SSD, তার মধ্যে ৩০০ GB এমনিতেই ভরা। ডাউনলোডই হবে না। ধরে নাও কোনোভাবে হলো, তারপর open() করে পড়তে গেলে ১৬ GB র্যাম হাত তুলে দেবে। আর ধরে নাও র্যামও কোনোভাবে ম্যানেজ হলো, একটা মাত্র ডিস্ক থেকে ৯০০ GB সিকোয়েনশিয়ালি পড়তে যে সময় লাগবে, ততক্ষণে পরের সপ্তাহের লগও জমে যাবে।
এই তিনটেই আসলে একই দেয়ালের তিন পাশঃ Space, Memory, and Time। একটা মেশিন যখন এই তিনটার যেকোনো একটাতে হার মানে, তখন প্রশ্নটা আর "কত বড় মেশিন কিনব" থাকে না। প্রশ্নটা হয়ে যায় "কয়টা মেশিন লাগাব"। আর ঠিক এখান থেকেই ডিস্ট্রিবিউটেড ফাইল সিস্টেমের গল্প শুরু।
ফাইল সিস্টেম জিনিসটা কী?
উইন্ডোজ বা লিনাক্স ইনস্টল করতে গিয়ে NTFS, ext4, FAT32, APFS এই নামগুলো নিশ্চয়ই দেখেছ। এগুলো ফাইল সিস্টেম। কিন্তু কাজটা কী?
হার্ডডিস্ক নিজে থেকে "ফাইল" চেনে না। ডিস্ক শুধু চেনে নাম্বার দেওয়া কতগুলো খোপ। ফাইল সিস্টেম হলো সেই হিসাবরক্ষক, যে মনে রাখে কোন খোপে কোন ফাইলের কোন অংশ আছে, কোন খোপ খালি, কোন ফাইলটা কার, আর কে কাকে পড়তে পারবে। একটা তুলনা দিই। ভাবো একটা ছাত্রাবাস। ঘরগুলোর নম্বর আছে, কিন্তু ঘর নিজে জানে না কে তার ভেতরে থাকে। সুপারিনটেনডেন্টের হাতে একটা রেজিস্টার থাকে। কোন ঘরে কে, কোন ঘর খালি, কে কবে উঠেছে। সেই রেজিস্টারটাই ফাইল সিস্টেম।
এবার বুঝবে ফরম্যাট করলে কেন সব "মুছে যায়"। ফরম্যাট আসলে প্রতিটা ঘরে ঢুকে জিনিসপত্র পুড়িয়ে দেয় না। সে শুধু রেজিস্টারটা ছিঁড়ে নতুন খাতা বসায়। ঘরগুলোয় পুরনো জিনিস তখনো পড়ে থাকে, কিন্তু কোথায় কী আছে সেটা আর কেউ জানে না, তাই ওগুলোকে "খালি" ধরে নেওয়া হয়। ডেটা রিকভারি সফটওয়্যারগুলো ঠিক এই ফাঁকেই কাজ করে। NTFS বা ext4-এর সমস্যা একটাই, তার রেজিস্টারে একটা ছাত্রাবাসের হিসাব থাকে। তোমার যদি দশটা ছাত্রাবাস লাগে, দরকার এমন একটা ব্যবস্থা যে দশটার হিসাব একসাথে রাখতে পারে। সেটাই ডিস্ট্রিবিউটেড ফাইল সিস্টেম।
নিজে ডিজাইন করে দেখো
পরের অংশ পড়ার আগে দুই মিনিট নিজে ভাবো। তুমি যদি এই সিস্টেমটা বানাতে যাও, চারটা প্রশ্নের উত্তর তোমাকে দিতেই হবেঃ
- ফাইলটা কে ভাঙবে, আর কত বড় টুকরোয় ভাঙবে?
- কোন টুকরো কোন মেশিনে যাবে, সেই সিদ্ধান্ত কে নেবে?
- পড়ার সময় ক্লায়েন্ট জানবে কী করে কোন টুকরো কোথায়?
- আর সবচেয়ে জরুরি একটা মেশিন Dead হলে কী হবে?
মনে রেখো, দশ হাজার সাধারণ মেশিনের ক্লাস্টারে প্রতিদিন গড়ে কয়েকটা মেশিন Dead হবে। এটা দুর্ঘটনা নয়, রুটিন। যে ডিজাইন এটাকে ব্যতিক্রম ধরে, সে ডিজাইন প্রোডাকশনে পৌঁছায় না।
ধাপ ১ঃ যারা আসল ডেটা রাখে
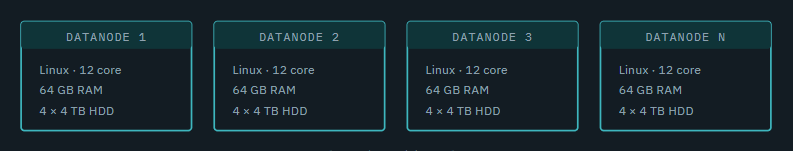
প্রথমে দরকার কতগুলো মেশিন, যাদের একমাত্র কাজ ডেটা ধরে রাখা। এদের বলি ডেটা নোড। এগুলো কোনো দামি বিশেষ যন্ত্র নয়। সাধারণ লিনাক্স সার্ভার, কয়েকটা হার্ডডিস্ক, খানিকটা র্যাম। SSH দিয়ে ঢুকে ls চালালে যেকোনো লিনাক্স মেশিনের মতোই দেখাবে। HDFS-এর মূল দর্শনটাই এই, দামি হার্ডওয়্যার কিনে ব্যর্থতা ঠেকানোর চেষ্টা না করে, সস্তা হার্ডওয়্যার ধরে নিয়ে সফটওয়্যারে ব্যর্থতা সামলানো।
ধাপ ২ঃ যে জানে কোথায় কী আছে
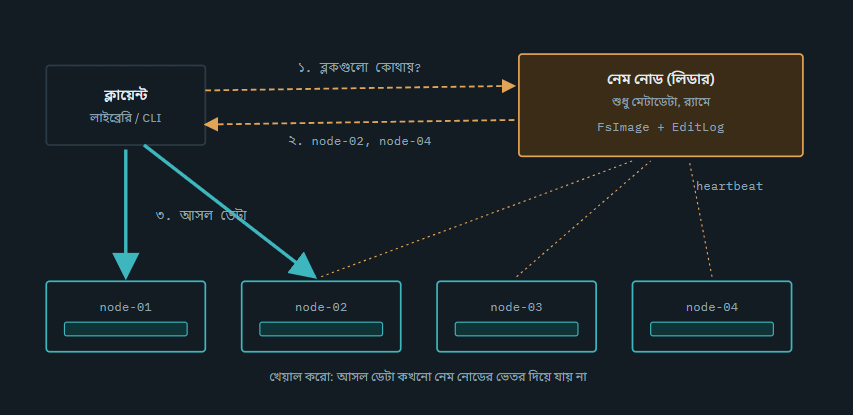
এখন সমস্যা। দশটা ডেটা নোডের কোনটায় জায়গা খালি? তোমার ফাইলের তৃতীয় টুকরোটা কোথায় গেল? এই হিসাব রাখবে কে? দরকার একজন লিডার নোড। HDFS-এ তার নাম NameNode। সেই ছাত্রাবাসের সুপারিনটেনডেন্টের কথা মনে আছে? NameNode ঠিক তাই, তবে দশটা ছাত্রাবাসের জন্য। তার কাছে থাকে মেটাডেটা। ফাইলের নাম, ডিরেক্টরি কাঠামো, কোন ফাইল কয় টুকরো, কোন টুকরো কোন নোডে, কয়টা কপি আছে।
মেটাডেটার সংজ্ঞাটা মজারঃ ডেটার ব্যাপারে ডেটা। তোমার ছবির ফাইলটা ডেটা; ছবিটা কবে তোলা, কোন ক্যামেরায়, কত KB সেটা মেটাডেটা। এখানে একটা ডিজাইন সিদ্ধান্ত আছে যেটা খেয়াল না করলে পুরোটা মিস হয়ে যাবে। আসল ডেটা কখনোই NameNode-এর ভেতর দিয়ে যায় না। সে শুধু ঠিকানা বলে দেয়, মালপত্র বইতে হয় না। সুপারিনটেনডেন্ট তোমাকে ঘরের নম্বর বলে দেন, তোমার ব্যাগ তিনি বয়ে নিয়ে যান না। এই আলাদা করাটার জন্যই একটামাত্র NameNode হাজার হাজার নোডের ক্লাস্টার সামলাতে পারে। তার ঘাড়ে কখনো টেরাবাইট চাপে না। দাম দিতে হয় অন্য জায়গায়। মেটাডেটা থাকে NameNode-এর র্যামে, দ্রুত উত্তর দেওয়ার জন্য। ফলে ক্লাস্টারে কত ফাইল রাখা যাবে তার সীমা ঠিক করে দেয় NameNode-এর মেমরি। আর এখান থেকেই HDFS-এর কুখ্যাত "small files problem" এক কোটি ছোট ফাইল রাখা এক লাখ বড় ফাইল রাখার চেয়ে অনেক বেশি কষ্টকর, যদিও মোট সাইজ একই।
ধাপ ৩ঃ ক্লায়েন্ট কীভাবে কথা বলে
ব্যবহারকারী সরাসরি নোডদের সাথে কথা বলে না। সে একটা ক্লায়েন্ট লাইব্রেরি ব্যবহার করে (Java API, একটা C র্যাপার, কমান্ড লাইনে hdfs dfs -put, এমনকি ব্রাউজার ইন্টারফেস)। পড়ার সময় যা ঘটেঃ
- ক্লায়েন্ট NameNode-কে জিজ্ঞেস করে, "এই ফাইলের ব্লকগুলো কোথায়?"
- NameNode ঠিকানার তালিকা ফেরত দেয়।
- ক্লায়েন্ট সরাসরি ডেটা নোডগুলোর সাথে কথা বলে ডেটা টেনে আনে।
আর এখানে আরেকটা সূক্ষ্ম চালাকি আছে। NameNode ঠিকানার তালিকাটা এলোমেলোভাবে দেয় না। সে যতটা সম্ভব পাঠকের কাছের কপিটা আগে দেখায়। একই র্যাকের কপি, তারপর একই ডেটা সেন্টারের। নেটওয়ার্ক সবসময়ই সবচেয়ে দামি সম্পদ। ব্যবহারকারীর কাছে পুরো ব্যাপারটা দেখায় একটা সাধারণ ফোল্ডার খোলার মতো। জটিলতাটুকু লাইব্রেরি আর NameNode নিজেদের মধ্যে সামলে নেয়।
ধাপ ৪ঃ ব্লক
ফাইল ভাগ হয় নির্দিষ্ট মাপের ব্লকে। পুরনো ডকুমেন্টেশনে দেখবে ৬৪ MB; আধুনিক ক্লাস্টারে ডিফল্ট সাধারণত ১২৮ MB। শুনতে অদ্ভুত লাগে। সাধারণ ফাইল সিস্টেমে ব্লক ৪ KB, এখানে ১২৮ MB কেন? কারণ উদ্দেশ্যটাই আলাদা। ল্যাপটপের ফাইল সিস্টেম চায় হাজার হাজার ছোট ফাইল কম জায়গা নষ্ট করে রাখতে। HDFS চায় গিগাবাইট সাইজের ফাইল টানা, দ্রুতগতিতে পড়তে। ব্লক বড় হলে ডিস্কের মাথা কম লাফায়, NameNode-এর হিসাব রাখার তালিকা ছোট থাকে, আর প্রতি ব্লকের ওভারহেড ডেটার তুলনায় নগণ্য হয়ে যায়।
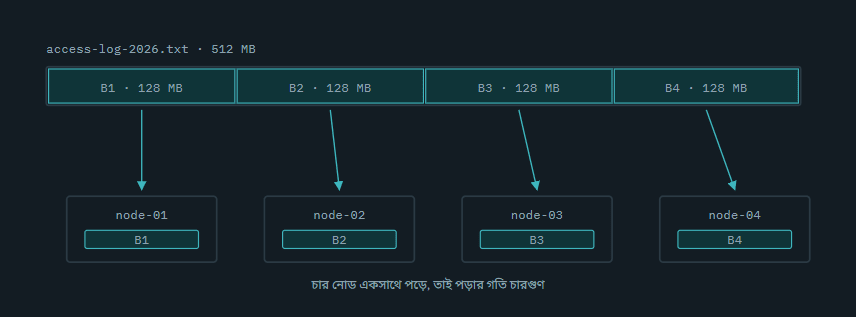
আর এই ভাগ করাটাই বোনাস হিসেবে দেয় সমান্তরালতা। চার নোডে চার ব্লক মানে চারটা মেশিন একসাথে পড়ছে। এই এক ধারণার উপরেই MapReduce, তারপর Spark, তারপর আজকের প্রায় সব বড় ডেটা ইঞ্জিন দাঁড়িয়ে আছে।
ধাপ ৫ঃ মেশিন Dead হলে কী হবে
এবার আসল প্রশ্ন। node-03 মরে গেল। B3 ব্লকটা তো শুধু ওখানেই ছিল। সমাধান খুব সরল। প্রতিটা ব্লকের একাধিক কপি রাখো, আলাদা মেশিনে। এটাই রেপ্লিকেশন। ডিফল্ট তিন কপি। তিন কেন? এক কপি মানে কোনো নিরাপত্তা নেই। দুই কপি মানে একটা মেশিন মেরামতে গেলে বাকি সময়টুকু তুমি একটামাত্র কপির ভরসায় বসে আছো। তিন হলো সেই বিন্দু যেখানে ঝুঁকি যথেষ্ট কমে, অথচ খরচ এখনো হাস্যকর হয়ে ওঠেনি। কপি বানানোর কাজটা কিন্তু নোডেরা নিজেরাই করে, NameNode শুধু হুকুম দেয় কার কাছে কোন ব্লক পাঠাতে হবে।
র্যাক সচেতনতাঃ একটা চমৎকার ছোট অপটিমাইজেশন
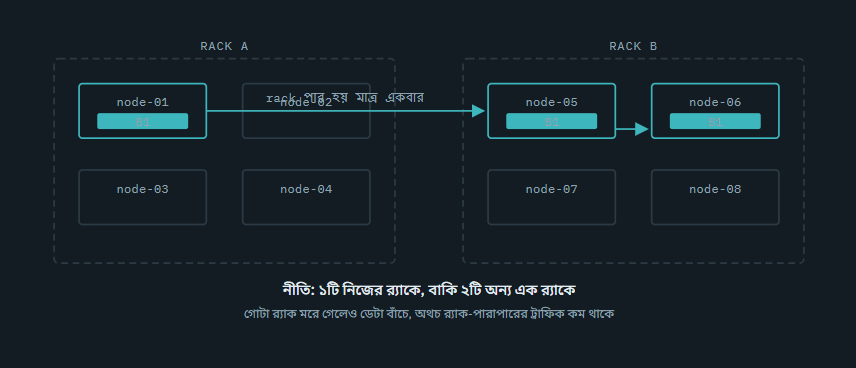
ডেটা সেন্টারে মেশিনগুলো র্যাকে সাজানো থাকে। একই র্যাকের মেশিনগুলো সাধারণত একই সুইচ আর একই পাওয়ার লাইন ভাগ করে নেয়। মানে একটা র্যাক একসাথে মরতে পারে। তিনটে কপিই এক র্যাকে রাখলে ঐ র্যাকের সুইচ গেলে তিনটেই একসাথে গেল। তাহলে তিন কপি তিন র্যাকে রাখলেই তো হয়? HDFS ঠিক তা করে না, আর এই সিদ্ধান্তটাই দেখার মতো। নীতিটা হলোঃ একটা কপি নিজের র্যাকে, বাকি দুটো অন্য একটা র্যাকে। কারণ, তিন র্যাকে ছড়ালে লেখার সময় ডেটাকে দুইবার র্যাক পার হতে হয়; দুই র্যাকে রাখলে একবার। অথচ একটা আস্ত র্যাক মরে গেলেও ডেটা বেঁচে থাকে দুই ক্ষেত্রেই। নিরাপত্তা প্রায় এক, নেটওয়ার্ক খরচ অর্ধেক। ভালো ইঞ্জিনিয়ারিং মানে নিখুঁত সমাধান নয়, বুদ্ধিমানের মতো দর-কষাকষি।
NameNode জানবে কী করে কে মরেছে?
ডেটা নোডেরা নিয়ম করে NameNode-কে হার্টবিট পাঠায়, মানে "আমি বেঁচে আছি"। সাথে মাঝে মাঝে পাঠায় block report "আমার কাছে এই এই ব্লকগুলো আছে"। কিছুক্ষণ হার্টবিট না এলে NameNode ঐ নোডকে মৃত ধরে নেয়, দেখে তার ব্লকগুলোর কপিসংখ্যা তিনের নিচে নেমে গেছে, আর বেঁচে থাকা নোডদের হুকুম দেয় নতুন কপি বানাতে। কেউ কিছু টের পায় না। একটা মজার উল্টো ঘটনাও আছে। মৃত নোড যদি ফিরে আসে, হঠাৎ চার কপি হয়ে যায়। তখন NameNode বাড়তি একটা মুছে ফেলতে বলে। সিস্টেমটা সবসময় নিজের ভারসাম্য নিজে ফিরিয়ে আনতে থাকে এটাকেই বলে self-healing।
লেখার সময় আসলে কী ঘটে
পড়ার গল্প তো হলো। লেখার গল্পটা আসলে বেশি মজার।
প্রথম চমকঃ ক্লায়েন্ট সাথে সাথে কিছুই পাঠায় না। তুমি লিখতে শুরু করলে ডেটা প্রথমে জমা হয় ক্লায়েন্টের নিজের ডিস্কে, একটা অস্থায়ী ফাইলে। পুরো এক ব্লক (১২৮ MB) না জমা পর্যন্ত NameNode-কে বিরক্তই করা হয় না। এটাকে বলে staging। কারণটা সোজা, প্রতিটা ছোট রাইটের জন্য নেটওয়ার্কে ছোটাছুটি করলে ক্লাস্টার কাঁপতে থাকবে।
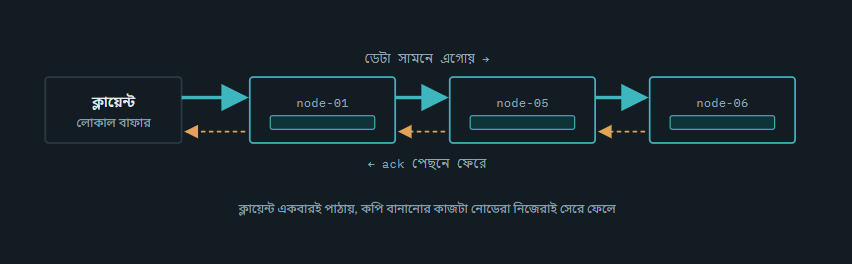
দ্বিতীয় চমকঃ ক্লায়েন্ট তিনবার আপলোড করে না। তিন কপি লাগবে বলে তিন নোডে তিনবার পাঠাতে হয় না। ডেটা যায় শিকলের মতো, একে replication pipelining বলে। ক্লায়েন্ট পাঠায় প্রথম নোডকে। প্রথম নোড ছোট ছোট অংশে ডেটা পাচ্ছে, নিজের ডিস্কে লিখছে, আর একই সাথে দ্বিতীয় নোডকে ফরোয়ার্ড করছে। দ্বিতীয় নোড একই কাজ করছে তৃতীয়কে নিয়ে। আর নিশ্চিতকরণ (ack) ফেরত আসে উল্টো পথে। ফলে ক্লায়েন্টের আপলোড ব্যান্ডউইথ একবারই খরচ হয়, অথচ তিন কপি তৈরি হয়ে যায়।
তৃতীয় চমকঃ ডেটা নিজেই নিজের সত্যতা বহন করে। ডিস্ক শুধু মরে না, ডিস্ক মাঝে মাঝে মিথ্যা বলে। একটা বিট নীরবে উল্টে যায় (bit rot)। তাই ক্লায়েন্ট লেখার সময় প্রতিটা ব্লকের checksum হিসাব করে আলাদাভাবে রেখে দেয়। পড়ার সময় মিলিয়ে দেখে। না মিললে সে চুপচাপ অন্য একটা কপি থেকে পড়ে নেয়, আর নষ্ট কপিটার ব্যাপারে NameNode-কে জানিয়ে দেয়।
আর হ্যাঁ, একটা সীমাবদ্ধতা জেনে রাখোঃ HDFS write-once-read-many। ফাইলের শেষে নতুন ডেটা জুড়ে দেওয়া (append) যায়, কিন্তু মাঝখানে ঢুকে সম্পাদনা করা যায় না। এটা ঘাটতি নয়, ইচ্ছাকৃত। লগ, সেন্সর ডেটা, ব্যাকআপ এসব একবার লেখা হয়, বারবার পড়া হয়। এই একটা শর্ত মেনে নেওয়ার বিনিময়েই ডিজাইনটা এত সরল রাখা গেছে।
যে ভুলটা প্রায় সবাই করেঃ Secondary NameNode
এবার সবচেয়ে জরুরি অংশ, আর সবচেয়ে বেশি ভুল বোঝা অংশ। NameNode একটাই। সে মরলে? সব ব্লক ঠিকঠাক বেঁচে থাকলেও কোন ব্লক কোন ফাইলের, সেটা আর কেউ জানে না। পুরো ক্লাস্টার তখন লক্ষ লক্ষ অর্থহীন টুকরোর স্তূপ। ঠিক যেন ছাত্রাবাসের রেজিস্টার পুড়ে গেছে। ছাত্ররা আছে, কে কোন ঘরে জানা নেই। এখন, HDFS-এ "Secondary NameNode" নামে একটা জিনিস আছে, আর নামটা দেখে প্রায় সবাই ভাবে সে ব্যাকআপ লিডার, প্রধান মরলে দায়িত্ব নেবে। সে তা নয়। কখনোই নয়। আসল ব্যাপারটা বুঝতে দুটো ফাইল চিনতে হবে। NameNode ডিস্কে দুটো জিনিস রাখেঃ
- FsImage: পুরো ফাইল সিস্টেমের একটা স্ন্যাপশট, একটা নির্দিষ্ট মুহূর্তের।
- EditLog: সেই মুহূর্তের পর থেকে যা যা বদলেছে, তার ধারাবাহিক তালিকা।
চালু হওয়ার সময় NameNode FsImage পড়ে, তারপর EditLog-এর সব পরিবর্তন একে একে প্রয়োগ করে বর্তমান অবস্থায় পৌঁছায়। সমস্যা হলো, মাসের পর মাস চললে EditLog দানবাকার হয়ে যায়, আর তখন NameNode চালু হতে ঘণ্টার পর ঘণ্টা লাগতে পারে। Secondary NameNode-এর কাজ ঠিক এইটুকু: সে মাঝে মাঝে FsImage আর EditLog নিয়ে জোড়া লাগিয়ে নতুন, হালনাগাদ FsImage বানিয়ে দেয়, যাতে EditLog ছোট থাকে। একে বলে checkpointing। সে একজন কেরানি, উত্তরাধিকারী নয়। ভালো নাম হতো "CheckpointNode"। তাহলে আসল HA কীভাবে হয়? আধুনিক HDFS-এ থাকেঃ
- একটা Active NameNode আর একটা Standby NameNode।
- মাঝে JournalNode-দের একটা কোরাম (৩, ৫ বা ৭টা, বিজোড় সংখ্যায়)। Active সেখানে প্রতিটা পরিবর্তন লেখে, Standby সেখান থেকে পড়ে নিজেকে হালনাগাদ রাখে।
- ডেটা নোডেরা block report দুজনকেই পাঠায়, তাই Standby-র কাছে ব্লক-মানচিত্রও সবসময় টাটকা থাকে। ফলে হস্তান্তরটা সেকেন্ডের ব্যাপার।
- আর কে Active সেই সালিশ করে ZooKeeper, তার সাথে থাকে ZKFC নামের একটা ছোট প্রহরী প্রসেস।
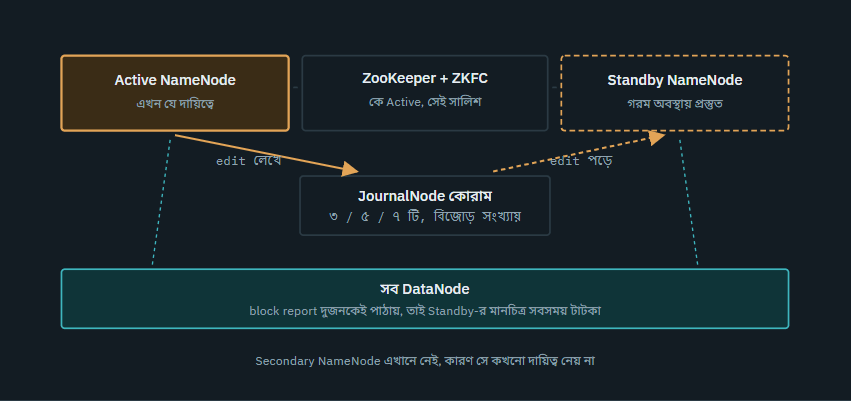
এখানে একটা কথা পরিষ্কার করে বলা দরকার, কারণ ভুলটা অনেক জায়গায় ছড়িয়ে আছে। ZooKeeper Paxos চালায় না, সে চালায় ZAB নামের নিজস্ব একটা প্রোটোকল (ধারণাগতভাবে কাছাকাছি, কিন্তু এক নয়)। আর ZooKeeper রেপ্লিকাগুলোর ডেটা মেলানোর কাজেও নেই, সেটা সামলায় রাইট পাইপলাইন, checksum আর block report। ZooKeeper-এর একটাই দায়িত্বঃ নিশ্চিত করা যে দুজন NameNode একসাথে "আমিই Active" বলে বসতে না পারে। এই বিপর্যয়টার নাম split-brain, আর এটা ঠেকানোই ডিস্ট্রিবিউটেড সিস্টেমের সবচেয়ে বড় মাথাব্যথাগুলোর একটা। আর দুটো NameNode-ই একসাথে মরলে? তখন সিস্টেম বসে যাবে। ডিস্ট্রিবিউটেড সিস্টেমে ১০০% বলে কিছু নেই। শুধু আছে "আরেকটা নাইন যোগ করতে কত খরচ হবে"। ৯৯.৯% থেকে ৯৯.৯৯%-এ যেতে খরচ দ্বিগুণ হতে পারে। ঐ বাড়তি নাইনটা তোমার আদৌ দরকার কি না, সেটা ইঞ্জিনিয়ারিং প্রশ্ন নয়, ব্যবসায়িক প্রশ্ন।
রেপ্লিকেশনের বিল, আর ইরেজার কোডিং
তিন কপি রাখা মানে ২০০% বাড়তি জায়গা। ১ পেটাবাইট ডেটার জন্য ৩ পেটাবাইট ডিস্ক। ২০১০ সালে ডিস্ক সস্তা বলে এটা মেনে নেওয়া হতো। পেটাবাইট স্কেলে এসে হিসাবটা আর অত মধুর থাকে না। তাই Hadoop 3-এ এলো Erasure Coding। ধারণাটা RAID বা QR কোডের মতো। পুরো ডেটা নকল না করে গণিত দিয়ে কিছু প্যারিটি তথ্য বানানো হয়, যা দিয়ে হারানো অংশ আবার হিসাব করে বের করা যায়। RS(6,3) নীতিতে ৬ ব্লক আসল ডেটার সাথে থাকে ৩ ব্লক প্যারিটি। যেকোনো ৩টা ব্লক হারিয়ে গেলেও বাকিগুলো থেকে সব ফিরিয়ে আনা যায়।
- ৩x রেপ্লিকেশনঃ ৬ ব্লকের জন্য লাগে ১৮ ব্লক।
- RS(6,3): ৬ ব্লকের জন্য লাগে ৯ ব্লক।
অর্ধেক জায়গা, প্রায় একই নিরাপত্তা। CERN-এর মূল্যায়নে খরচ প্রায় ৬০% কম এসেছে।
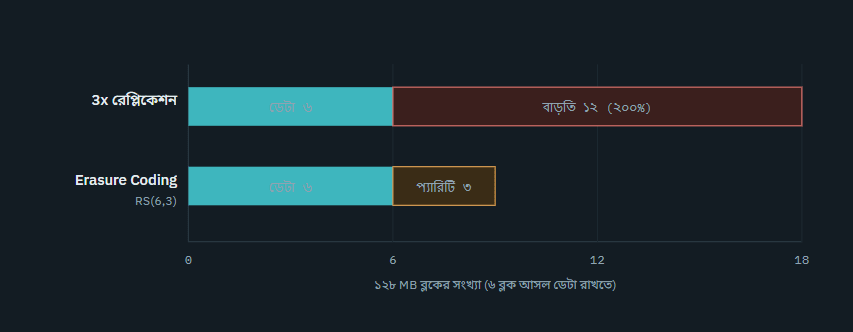
তবে বিনামূল্যে কিছু আসে না। রেপ্লিকেশনে নষ্ট ব্লক মানে অন্য নোড থেকে একটা কপি টেনে আনা, ব্যস। ইরেজার কোডিংয়ে হারানো ব্লক ফেরত পেতে অন্য অনেকগুলো ব্লক পড়ে হিসাব কষতে হয়। বেশি CPU, বেশি নেটওয়ার্ক। আর ছোট ফাইলে এটা উল্টো বেশি জায়গা খায়। তাই বাস্তব ক্লাস্টারে সাধারণত মেশানো নীতি চলে: গরম ডেটায় রেপ্লিকেশন, ঠান্ডা আর্কাইভে ইরেজার কোডিং।
২০২৬-এ দাঁড়িয়েঃ HDFS কি এখনো লাগে?
নতুন প্রজেক্টে সাধারণত না। কিন্তু ধারণাগুলো আগের চেয়েও বেশি লাগে। গত এক দশকে তিনটে জিনিস বদলে গেছে।
এক, স্টোরেজ আর কম্পিউট আলাদা হয়ে গেছে। HDFS-এর মূল বাজি ছিল "ডেটার কাছে হিসাব নিয়ে যাও, কারণ নেটওয়ার্ক ধীর"। কিন্তু ডেটা সেন্টারের নেটওয়ার্ক এখন এত দ্রুত যে ঐ বাজি আর তত জোরালো নয়। আজ ডেটা থাকে অবজেক্ট স্টোরেজে (S3, GCS, Azure Blob, বা on-prem হলে MinIO-ধরনের কিছু), আর হিসাব চালায় আলাদা, ক্ষণস্থায়ী কম্পিউট ক্লাস্টার; কাজ শেষে যাকে নিভিয়ে দেওয়া যায়। খরচের হিসাবে এটা বিশাল পার্থক্য। HDFS ক্লাস্টার তুমি ব্যবহার করো বা না করো, বিল আসতেই থাকে।
দুই, টেবিল ফরম্যাট এসে ফাঁকটা ভরাট করেছে। অবজেক্ট স্টোরেজ শুধু ফাইল রাখে, সে "টেবিল" চেনে না, ট্রানজেকশন বোঝে না। তাই এলো Apache Iceberg, Delta Lake, Apache Hudi। এরা ডিরেক্টরিকে সত্যের উৎস মানে না; বরং একটা manifest রাখে। এই মুহূর্তে টেবিলটার অংশ ঠিক কোন ফাইলগুলো। নতুন ভার্সন মানে নতুন manifest লিখে পয়েন্টারটা এক ধাক্কায় বদলে দেওয়া। এভাবেই অবজেক্ট স্টোরেজের উপর ACID ট্রানজেকশন, টাইম ট্র্যাভেল, স্কিমা পরিবর্তন সম্ভব হয়েছে। এই স্তূপটার নামই লেকহাউস, আর ২০২৫-২৬ এ এটাই কার্যত ডিফল্ট।
তিন, একটা মেশিন আবার ভয়ানক শক্তিশালী হয়ে উঠেছে। ২০০৬ সালে ১ টেরাবাইট ছিল দানব। আজ ক্লাউডে ২৪ টেরাবাইট র্যামের একটামাত্র মেশিন ভাড়া নেওয়া যায়, আর DuckDB বা Polars দিয়ে ল্যাপটপেই কয়েকশ গিগাবাইট Parquet ফাইল প্রসেস করা যায়। বহু কোম্পানি যাদের "বিগ ডেটা ক্লাস্টার" আছে, তাদের আসল ডেটাসেট আসলে একটা মেশিনেই এঁটে যেত। সবচেয়ে দ্রুত ডিস্ট্রিবিউটেড সিস্টেম হলো সেটা, যেটা তোমাকে বানাতেই হয়নি।
তাহলে HDFS পড়ে কী লাভ? লাভ এটাই যে তার প্রতিটা ধারণা টিকে গেছে, শুধু জামা বদলেছে। S3-ও ভেতরে ডেটা টুকরো করে, রেপ্লিকা রাখে, ব্যর্থতার ডোমেইন ছড়িয়ে দেয়, checksum দিয়ে সততা যাচাই করে, ইরেজার কোডিং দিয়ে খরচ বাঁচায়। পার্থক্য শুধু এই যে জটিলতাটা এখন আরেকজনের সমস্যা। কিন্তু যেদিন তোমার পাইপলাইন ধীর হয়ে যাবে, বিল আকাশ ছোঁবে, বা একটা রিজিয়ন পড়ে যাবে সেদিন এই ধারণাগুলোই তোমাকে বলে দেবে কোথায় তাকাতে হবে।
এরপর কী পড়বে
দুটো রেফারেন্স, দুই রকম কাজে।
HDFS Architecture Guide (Apache-র নিজস্ব ডকুমেন্টেশন)। ছোট, পরিষ্কার, একবারে পড়ে ফেলার মতো। তবে মনে রেখো r1.2.1 সংস্করণটা বেশ পুরনো। সেখানে ব্লক ৬৪ MB, স্ন্যাপশট নেই, আর স্পষ্ট লেখা আছে NameNode-এর স্বয়ংক্রিয় failover সমর্থিত নয়। আধুনিক HDFS-এ এই তিনটেই বদলে গেছে। পুরনো ডকুমেন্টেশন পড়ার সময় ভার্সন নম্বরটা দেখে নেওয়ার অভ্যাসটাই এখান থেকে নেওয়ার মতো সবচেয়ে বড় শিক্ষা। যে অংশগুলো এখনো অসাধারণ: replica placement, staging, replication pipelining, data integrity, আর space reclamation (মুছে ফেলা ফাইল /trash-এ যায়, তাই ভুল করে rm চালালেও ফেরানোর সুযোগ থাকে)।
Designing Data-Intensive Applications by Martin Kleppmann। ব্যাকএন্ড ইঞ্জিনিয়ারদের জন্য এই দশকের সবচেয়ে জরুরি বইগুলোর একটা। এই লেখার সাথে সরাসরি মেলে যে অধ্যায়গুলোঃ Replication (leader-follower ঠিক যে যুক্তিতে চলে), Partitioning (ডেটা ভাগ করার নীতি), Consistency and Consensus (ZAB, Paxos, Raft আসলে কী সমস্যা সমাধান করছে, আর split-brain কেন এত ভয়ংকর), আর Batch Processing (MapReduce থেকে আজকের ইঞ্জিন পর্যন্ত পুরো যাত্রা)। বইটার আসল শক্তি হলো, সে বিভিন্ন সিস্টেম কী করে তা মুখস্থ করায় না, শেখায় কেন করে।
সাথে একটাই বাড়তি পরামর্শঃ Google-এর MapReduce (2004) পেপারটা পড়ে ফেলো। মাত্র তেরো পৃষ্ঠা, ভাষা আশ্চর্যরকম সহজ, আর গোটা বিগ ডেটা যুগ ঐ কাগজটা থেকেই বেরিয়েছে।
শেষ কথা
ডিস্ট্রিবিউটেড ফাইল সিস্টেম আসলে একটামাত্র প্রশ্নের দীর্ঘ উত্তরঃ যেখানে সব কিছু নষ্ট হওয়াটাই স্বাভাবিক, সেখানে নির্ভরযোগ্য কিছু কীভাবে বানানো যায়? উত্তরের উপাদানগুলো অদ্ভুত রকম সরল। কাজটা ভাগ করে দাও, অতিরিক্ত কপি রাখো, ব্যর্থতার ডোমেইনগুলো ছড়িয়ে দাও, প্রতিদিন নাড়ি টিপে দেখো, আর ধরে নাও যে যেকোনো কিছু যেকোনো মুহূর্তে মিথ্যা বলতে পারে। মজার ব্যাপার হলো, এই একই নীতিগুলো তোমার তিন-সার্ভারের ওয়েব অ্যাপেও খাটে, ঠিক যেভাবে দশ হাজার নোডের ক্লাস্টারে খাটে। স্কেলটাই কেবল আলাদা।