#distributed-systems #idempotency #concurrency #async-programming #error-handling #secrets-management #configuration-management #observability #code-duplication #DRY-principle #dotnet #docker #cloud-storage #multi-tenant-architecture #UI-UX-design
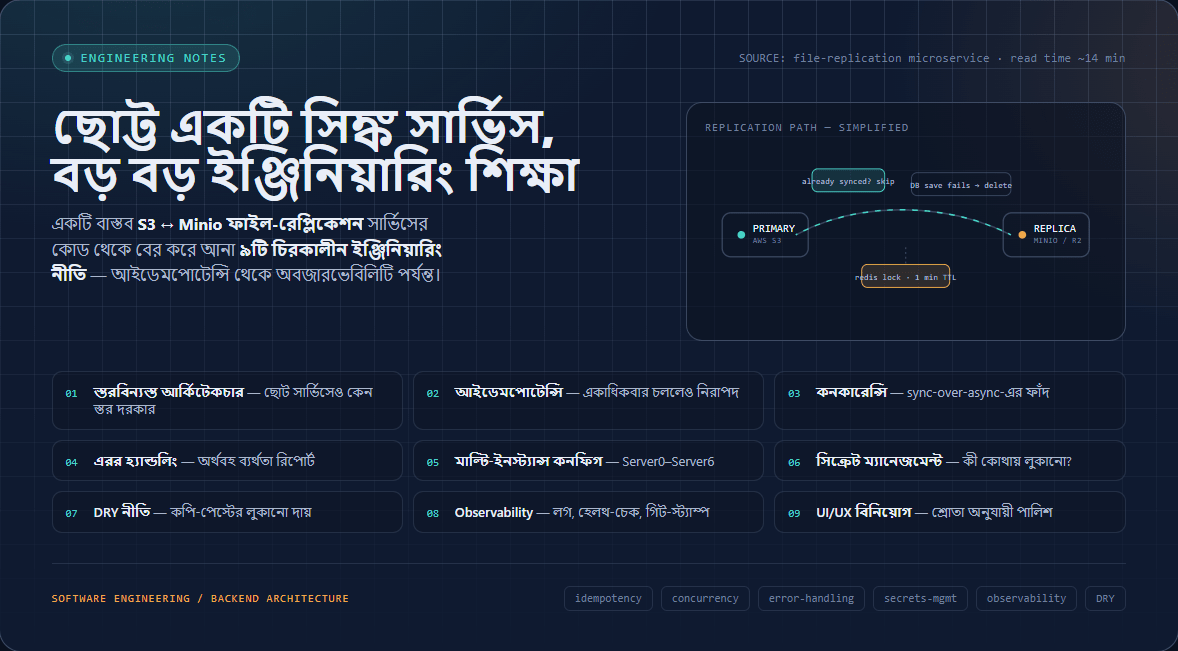
ছোট্ট একটি সিঙ্ক সার্ভিস, বড় বড় ইঞ্জিনিয়ারিং শিক্ষা
2026-08-06 · 24 min read
ভূমিকা
কল্পনা করুন এমন একটি ছোট্ট ব্যাকগ্রাউন্ড সার্ভিসের কথা, যার একমাত্র কাজ হলো একটি স্টোরেজ প্রোভাইডার (যেমন AWS S3) থেকে ফাইল পড়ে আরেকটি স্টোরেজ প্রোভাইডারে (যেমন একটি ইন-হাউজ Minio সার্ভার) কপি করা — অনেকটা দুটো ওয়্যারহাউজের মধ্যে পণ্য স্থানান্তরকারী একজন ডেলিভারি কর্মীর মতো। কাজটা শুনতে সহজ মনে হলেও, এই ধরনের একটি "স্রেফ ফাইল কপি করা" সার্ভিসের ভেতরেই লুকিয়ে থাকে ডিস্ট্রিবিউটেড সিস্টেম, কনকারেন্সি, এরর হ্যান্ডলিং, কনফিগারেশন ম্যানেজমেন্ট আর সিকিউরিটির মতো বিষয়গুলোর অসংখ্য বাস্তব শিক্ষা।
এই আর্টিকেলে আমরা এরকমই একটি এন্টারপ্রাইজ .NET প্রজেক্টের StorageSynchronizer অংশকে — একটি S3/Minio ফাইল-রেপ্লিকেশন মাইক্রোসার্ভিসকে — কাঁচামাল হিসেবে ব্যবহার করব। লক্ষ্য প্রজেক্টের কাজের সারাংশ লেখা নয়; বরং এর কোড থেকে বেরিয়ে আসা সাধারণ, চিরকালীন (evergreen) ইঞ্জিনিয়ারিং নীতিগুলো তুলে ধরা, যা যেকোনো প্রজেক্টে কাজ করা একজন ডেভেলপারের জন্য প্রাসঙ্গিক।
১. স্তরবিন্যস্ত আর্কিটেকচার (Layered Architecture): ছোট সার্ভিসেও কেন স্তর দরকার
এটা কী। স্তরবিন্যস্ত আর্কিটেকচার মানে কোডকে দায়িত্ব অনুযায়ী আলাদা আলাদা স্তরে ভাগ করা — একটি রেস্টুরেন্টে অর্ডার নেওয়ার লোক, শেফ, আর সরবরাহকারী আলাদা আলাদা কাজ করার মতো। এই সার্ভিসে দেখা যায় একটি স্পষ্ট চেইন: StorageProviderController → IStorageApiService → IStorageApiRequest → IHttpHelper।
কেন সমস্যা তৈরি করে। এই সার্ভিসটি ছোট হলেও একটি বাহ্যিক HTTP API-এর ওপর নির্ভর করে মেটাডেটা আনতে। সব যুক্তি একটি একক কন্ট্রোলার মেথডে গুঁজে দিলে URL গঠন, JSON পার্সিং, বা অথেন্টিকেশন হেডার পরিবর্তন হলে প্রতিবার পুরো ফাইল ঘেঁটে দেখতে হতো, আর টেস্ট করাও কঠিন হতো।
সাধারণ ভুল। নতুন ডেভেলপাররা প্রায়ই ভাবেন "ছোট প্রজেক্ট, তাই স্তরায়নের দরকার নেই" — এবং সরাসরি কন্ট্রোলারেই HTTP কল, JSON পার্সিং, ব্যবসায়িক যুক্তি সব একসাথে লিখে ফেলেন।
ভালো পদ্ধতি। নিয়মটা প্রজেক্টের আকারের ওপর নয়, নির্ভর করে "এই স্তরটা কি ভবিষ্যতে স্বাধীনভাবে বদলাতে পারে কি না" তার ওপর। HTTP-কলিং লজিক, URL-বিল্ডিং লজিক, আর ব্যবসায়িক যুক্তি — প্রতিটি ভিন্ন কারণে বদলাতে পারে, তাই আলাদা রাখা হয়েছে; প্রতিটি ইন্টারফেসের পেছনে থাকায় ইউনিট টেস্টে সহজে মক করা যায়।
আগেভাগে চেনার উপায়। প্রশ্ন করুন — একটি মেথডের ভেতরে কি একাধিক ভিন্ন স্তরের সমস্যা (নেটওয়ার্ক ব্যর্থতা বনাম ব্যবসায়িক নিয়ম লঙ্ঘন) একসাথে ধরার চেষ্টা হচ্ছে? একাধিক ভিন্ন-উদ্দেশ্যের try/catch এক জায়গায় জমা হওয়া স্তরায়ন ভাঙার লক্ষণ।
বড় শিক্ষা। "এটা ছোট, তাই আর্কিটেকচারের দরকার নেই" — এই চিন্তাটাই আসলে ফাঁদ। প্রয়োজনীয়তা লাইন সংখ্যার ওপর নয়, পরিবর্তনের কারণ (reasons to change) কয়টা আলাদা তার ওপর নির্ভর করে।
২. আইডেমপোটেন্সি ও নিরাপদ রিট্রাই: ডিস্ট্রিবিউটেড সিস্টেমের মূল ভিত্তি
এটা কী। আইডেমপোটেন্সি (idempotency) মানে একটি অপারেশন একবার চালালে যা হয়, দশবার চালালেও ফলাফল একই থাকা — লিফটের বাটন একবার চাপুন বা দশবার, লিফট একবারই আসবে। নেটওয়ার্ক ব্যর্থতা বা টাইমআউটের কারণে ডিস্ট্রিবিউটেড সিস্টেমে একই কাজ একাধিকবার চলে যাওয়া প্রায় অনিবার্য।
কেন সমস্যা তৈরি করে। ফাইল রেপ্লিকেশনের ট্রিগার একটি সাধারণ HTTP GET এন্ডপয়েন্ট (ItemReplicate), যা বাইরে থেকে নিয়মিত বিরতিতে কল করা হয়। একই সময়ে দুইবার কল হলে একই ফাইল দু'বার ডাউনলোড-আপলোড হতে পারে, স্টোরেজ খরচ বাড়তে পারে, ডাটাবেসে ভুল রেকর্ড তৈরি হতে পারে।
সাধারণ ভুল। ধারণা করা হয় — "স্টোরেজে ফাইল আছে কি না প্রতিবার চেক করলেই আইডেমপোটেন্সি নিশ্চিত"। কিন্তু চেক আর প্রকৃত আপলোডের মাঝের সময়ে আরেকটি প্রসেস একই কাজ করে ফেললে (race condition) এই চেক ব্যর্থ হয়।
ভালো পদ্ধতি। এই কোডে তিনটি প্রতিরক্ষা স্তর একসাথে কাজ করে: (১) প্রতিটি আইটেম প্রসেসের আগে সোর্স-অফ-ট্রুথ ডাটাবেস থেকে চেক — if (item.ReplicatedItemId > 0) continue;, (২) প্রতিটি প্রোভাইডার/সার্ভিস-গ্রুপের জন্য একটি Redis ডিস্ট্রিবিউটেড লক (RedLock) যাতে একাধিক সার্ভার-ইনস্ট্যান্স সংঘর্ষ না করে, (৩) আপলোড সফল হলেও DB-সেভ ব্যর্থ হলে আপলোড করা ফাইল স্টোরেজ থেকে মুছে ফেলা (RemoveDownloadedItem) — একটি ক্ষতিপূরণমূলক কাজ (compensating action) যা "orphan" ফাইল তৈরি হতে বাধা দেয়।
আগেভাগে চেনার উপায়। প্রশ্ন করুন — নেটওয়ার্ক টাইমআউটের কারণে ক্লায়েন্ট আবার কল করলে কি সিস্টেমে দুটো রেকর্ড তৈরি হবে? উত্তর অনিশ্চিত হলে একটি ইউনিক-আইডেন্টিফায়ার-ভিত্তিক চেক বা ডিস্ট্রিবিউটেড লক দরকার।
বড় শিক্ষা। "ঠিক একবার" (exactly-once) ডেলিভারি বাস্তবে প্রায় অসম্ভব — লক্ষ্য হওয়া উচিত "একাধিকবার চললেও নিরাপদ" ডিজাইন, আর ক্রস-সিস্টেম ট্রানজেকশন সম্ভব না হলে (স্টোরেজ + ডাটাবেস) ক্ষতিপূরণমূলক কাজ দিয়ে সামঞ্জস্য বজায় রাখা।
৩. কনকারেন্সি ও এসিনক্রোনাস প্রোগ্রামিং: থ্রেড ম্যানেজমেন্টের ফাঁদ
এটা কী। কনকারেন্সি মানে একই সময়ে একাধিক কাজ চালানো। async/await দিয়ে "নন-ব্লকিং" কাজ করা যায় — একটি নেটওয়ার্ক কল চলাকালীন থ্রেড অন্য কাজ করতে পারে, অনেকটা ওয়েটার অর্ডার দিয়ে রান্না শেষ না হওয়া পর্যন্ত না দাঁড়িয়ে অন্য টেবিলে সেবা দেওয়ার মতো।
কেন সমস্যা তৈরি করে। এই কোডে ফাইল-রেপ্লিকেশনের কাজ সমান্তরালভাবে চালানো হয় হাতে-তৈরি Task, ConcurrentStack, আর manual lock দিয়ে — আধুনিক Task.Run বা SemaphoreSlim-প্যাটার্নের বদলে। এর পাশাপাশি স্বাভাবিকভাবে asynchronous কাজ (HTTP কল, S3 আপলোড) .GetAwaiter().GetResult() দিয়ে জোর করে সিনক্রোনাস বানানো হয়েছে ("sync-over-async")।
সাধারণ ভুল। ধরে নেওয়া হয় .GetAwaiter().GetResult() দিয়ে ফলাফল "সাথে সাথে" নেওয়া নিরাপদ। বাস্তবে এটি থ্রেড-পুল ক্ষয় ঘটাতে পারে — প্রতিটি ব্লক করা থ্রেড নেটওয়ার্ক কল শেষ না হওয়া পর্যন্ত আটকে থাকে, অথচ থ্রেড পুলের আকার সীমিত।
ভালো পদ্ধতি। async চেইন শুরু থেকে শেষ পর্যন্ত বজায় রাখা উচিত। সমান্তরাল কাজের জন্য Task.WhenAll (async-বান্ধব) ব্যবহার করা উচিত Task.WaitAll-এর বদলে। শেয়ার্ড কাউন্টারের ক্ষেত্রে lock ব্যবহার এই কোডে ঠিকভাবেই করা হয়েছে — যা দেখায় concurrency-সচেতনতা এখানে ছিল, শুধু টুলিং পুরনো।
আগেভাগে চেনার উপায়। কোডে .Result বা .GetAwaiter().GetResult() দেখলে থামুন — এটা কি একটা async চেইনের মাঝে ব্লক করছে, নাকি সত্যিই async করা সম্ভব নয় এমন এন্ট্রি-পয়েন্টে আছে?
বড় শিক্ষা। Concurrency-primitives সঠিকভাবে ব্যবহার করা মানেই সব ঠিক আছে তা নয় — async/await-এর মূল প্রতিশ্রুতিই sync-over-async দিয়ে ভাঙলে সিস্টেম লোডের নিচে ভেঙে পড়তে পারে।
৪. এরর হ্যান্ডলিং ও অর্থবহ ব্যর্থতা রিপোর্টিং
এটা কী। ভালো এরর হ্যান্ডলিং মানে ক্র্যাশ ঠেকানো নয় শুধু — একটি সিস্টেম ব্যর্থ হলে সেই ব্যর্থতা সম্পর্কে সঠিক, কার্যকর তথ্য দেওয়ার শিল্প।
কেন সমস্যা তৈরি করে। এই সার্ভিসে HTTP রেসপন্স একটি এনভেলপ কাঠামোতে আসে (IsSuccess, IsAuthenticated, Message)। একটি চমৎকার ডিবাগিং কৌশল আছে — JSON পার্সিং ব্যর্থ হয়ে রেসপন্সের শুরুতে < অক্ষর পেলে কোড বুঝতে পারে সার্ভার আসলে HTML এরর পেজ পাঠিয়েছে, আর সেটা স্পষ্টভাবে জানায়। অন্যদিকে, SetExceptionMessage মেথডে বিশটিরও বেশি if/else দিয়ে প্রতিটি এক্সসেপশন টাইপ একটি সংখ্যাসূচক কোডে (যেমন "1003") ম্যাপ করা — এই সংখ্যা ব্যবহারকারীর কাছে অর্থহীন, নতুন টাইপ যোগ করতে পুরো চেইন সম্পাদনা করতে হয়।
সাধারণ ভুল। "সব ব্যতিক্রম একইভাবে সামলানো" — রিট্রাই-যোগ্য বনাম শুধু-লগ-করার-যোগ্য বনাম ব্যবহারকারীকে-জানানোর-যোগ্য এই তিন ধরনের ব্যর্থতা গুলিয়ে ফেলা।
ভালো পদ্ধতি। এরর মেসেজ দুই শ্রোতার জন্য আলাদা হওয়া উচিত — লগে (ডেভেলপারের জন্য, প্রযুক্তিগত বিস্তারিত) আর ব্যবহারকারীকে দেখানো মেসেজ (সহজ, কার্যকর)। টাইপ-ম্যাপিংয়ের জন্য Dictionary<Type, string> বা প্যাটার্ন-ম্যাচিং switch ব্যবহার করা উচিত দীর্ঘ if/else চেইনের বদলে।
আগেভাগে চেনার উপায়। দশটির বেশি প্রায়-অভিন্ন if/else if ব্লক দেখলে লুকআপ-টেবিলে প্রতিস্থাপনযোগ্য কি না যাচাই করুন। এরর মেসেজে শুধু একটি সংখ্যা থাকলে প্রশ্ন করুন — এটা দেখে কেউ কী করবে?
বড় শিক্ষা। প্রতিটি catch ব্লক একটি সিদ্ধান্ত-বিন্দু — রিট্রাই, লগ-করে-চালিয়ে-যাওয়া, নাকি ব্যবহারকারীকে জানানো, এই তিনটি গুলিয়ে ফেললে ডিবাগিং কঠিন হয় ও প্রকৃত সমস্যা চাপা পড়ে।
৫. কনফিগারেশন ম্যানেজমেন্ট ও মাল্টি-ইনস্ট্যান্স ডিপ্লয়মেন্ট
এটা কী। কনফিগারেশন ম্যানেজমেন্ট মানে পরিবেশ-নির্ভর সেটিংস কোড থেকে আলাদা রাখা, যাতে একই কোড ভিন্ন পরিবেশে পুনঃকম্পাইল ছাড়া চলে।
কেন সমস্যা তৈরি করে। appsettings.Server0.json থেকে Server6.json পর্যন্ত সাতটি কনফিগ ফাইল — একই স্কিমা, ভিন্ন RedisConnectionString/BaseUrl/AppCode, একটি মাল্টি-ইনস্ট্যান্স আর্কিটেকচারের ইঙ্গিত (একই সফটওয়্যার, একাধিক স্বতন্ত্র ব্যাকএন্ড ইনস্ট্যান্স)। একটি সূক্ষ্ম কিন্তু গুরুত্বপূর্ণ ব্যাপার — Data Protection কী (cookie/antiforgery-এর মূল ভিত্তি) Redis-এ রাখা হয় ও SetApplicationName সব ইনস্ট্যান্সজুড়ে একই রাখা হয়েছে (কোডে মন্তব্য: "MUST be same across all instances")। না হলে একটি ইনস্ট্যান্সে তৈরি কুকি আরেকটিতে অবৈধ হয়ে যেত।
সাধারণ ভুল। মাল্টি-ইনস্ট্যান্স সিস্টেমে "প্রতিটি সার্ভার স্বাধীন" ভেবে Data Protection-এর মতো নিরাপত্তা-কী স্থানীয়ভাবে (in-memory/ডিস্কে) রাখা — এতে একটি সার্ভারে কাজ করে, স্কেল-আউটের পরই অথেন্টিকেশন ভেঙে পড়ে।
ভালো পদ্ধতি। যেকোনো "সেশন-সদৃশ" বা ক্রিপ্টোগ্রাফিক-কী স্টেট একাধিক ইনস্ট্যান্সজুড়ে সামঞ্জস্যপূর্ণ হতে হলে একটি শেয়ার্ড কেন্দ্রীয় স্টোরে (এখানে Redis) রাখা আবশ্যক।
আগেভাগে চেনার উপায়। প্রশ্ন করুন — অ্যাপটি দুটো সার্ভারে একসাথে চালালে ব্যবহারকারী কি পার্থক্য টের পাবেন? অথেন্টিকেশন কী বা ইন-মেমরি ক্যাশ ইনস্ট্যান্স-নির্দিষ্ট হলে স্কেল-আউটে সমস্যা হবে।
বড় শিক্ষা। "লোকাল মেশিনে কাজ করে" আর "একাধিক সার্ভার-ইনস্ট্যান্সে সামঞ্জস্যপূর্ণভাবে কাজ করে" — এই দুই গ্যারান্টি সম্পূর্ণ ভিন্ন।
৬. সিক্রেট ম্যানেজমেন্ট: কনফিগারেশনে গোপন তথ্য রাখার বিপদ
এটা কী। সিক্রেট ম্যানেজমেন্ট মানে API টোকেন, এনক্রিপশন কী ইত্যাদি এমনভাবে সংরক্ষণ করা যাতে সোর্স কোডে প্রবেশাধিকার থাকলেই প্রোডাকশন সিস্টেমে প্রবেশ করা না যায়।
কেন সমস্যা তৈরি করে। কনফিগারেশন ফাইলে সরাসরি API টোকেন ও এনক্রিপশন-সার্ভিসের কী হার্ডকোড করা লক্ষ্য করা গেছে। আরও লক্ষণীয়, স্টোরেজ প্রোভাইডারের অ্যাক্সেস-কী/সিক্রেট-কী এনক্রিপ্ট করতে TripleDES ব্যবহৃত হয়, কিন্তু সেই এনক্রিপশনের নিজস্ব কী সোর্স কোডেই হার্ডকোড করা একটি স্ট্যাটিক স্ট্রিং — এটি এনক্রিপশনের মূল উদ্দেশ্যকেই নাকচ করে দেয়, কারণ যে কোড দেখে সে ডিক্রিপ্ট করার চাবিও পায়।
সাধারণ ভুল। "ডেটা এনক্রিপ্ট করা আছে, তাই নিরাপদ" — কী কোথায় আছে তা বিবেচনা না করেই। অথবা "এটা internal সিস্টেম, বাইরের কেউ দেখবে না" ভেবে সিক্রেট কনফিগে হার্ডকোড করে ভার্সন কন্ট্রোলে কমিট করা।
ভালো পদ্ধতি। সিক্রেট কখনো সোর্স কোড/কনফিগ ফাইলে হার্ডকোড না করে এনভায়রনমেন্ট ভ্যারিয়েবল, একটি সিক্রেট ভল্ট, বা .NET User Secrets (শুধু ডেভেলপমেন্টে) থেকে ডিপ্লয়মেন্টের সময় ইনজেক্ট করা উচিত। এনক্রিপশন কী নিজে যদি এনক্রিপ্ট করা ডেটার একই জায়গায় থাকে, "at rest" এনক্রিপশনের কোনো বাস্তব সুরক্ষা মূল্য নেই।
আগেভাগে চেনার উপায়। ApiKey/Secret/Password/Token নামের ভ্যারিয়েবলের পাশে সরাসরি random-looking স্ট্রিং literal আছে কি না যাচাই করুন। নতুন কনফিগ-কী যোগ হলে প্রশ্ন করুন — এটা ফাঁস হলে ক্ষতির পরিধি কতটুকু?
বড় শিক্ষা। সিক্রেট সোর্স কোডে হার্ডকোড করা মানে ঝুঁকি ব্যবস্থাপনার সিদ্ধান্তই না নিয়ে সবচেয়ে বড় ঝুঁকিটা বেছে নেওয়া। একবার রিপোজিটরি হিস্ট্রিতে ঢুকে গেলে, ফাইল থেকে মুছলেই "নিরাপদ" হয় না — সিক্রেট রোটেট করাই একমাত্র সমাধান।
৭. কোড ডুপ্লিকেশন ও DRY নীতির লুকানো মূল্য
এটা কী। DRY (Don't Repeat Yourself) — একই যুক্তি একাধিক জায়গায় কপি না করে একটিমাত্র জায়গায় রাখা, যাতে ভবিষ্যতে পরিবর্তন একটিমাত্র জায়গায় করলেই চলে।
কেন সমস্যা তৈরি করে। MinioHelper-এ ফাইল আপলোডের পাঁচটি প্রায়-অভিন্ন মেথড (PutObject, WritingAnObject, WritingAnObjectAsync, WritingAnObjectMultipart, WritingAnObjectMultipartAsync) — একই গঠন, কিন্তু সূক্ষ্ম পার্থক্য বাগের উৎস: PutObject-এ DisablePayloadSigning = true নিঃশর্তভাবে সেট (Cloudflare R2-এর জন্য), অথচ WritingAnObjectMultipart-এ এটি শুধু URL-এ "r2.cloudflarestorage.com" থাকলেই সেট হয়। একই আচরণ প্রত্যাশিত দুটো মেথড আসলে ভিন্নভাবে আচরণ করছে।
সাধারণ ভুল। সময়ের চাপে বিদ্যমান মেথড কপি করে সামান্য পরিবর্তন করা দ্রুততম পথ মনে হয় — কিন্তু ভবিষ্যতে বাগ-ফিক্স একটিমাত্র কপিতে প্রয়োগ হয়, বাকিগুলো পুরনো থেকে যায়।
ভালো পদ্ধতি। একাধিক মেথডে একই try/catch/ভ্যালিডেশন/রিকোয়েস্ট-বিল্ডিং যুক্তি দেখা গেলে একটি প্রাইভেট হেল্পার বের করে আনা উচিত যা শুধু ভিন্নতা (sync/async, single/multipart) প্যারামিটার হিসেবে নেয়।
আগেভাগে চেনার উপায়। দুটো মেথডের নাম-সিগনেচার আলাদা কিন্তু বডি ৮০%+ একই রকম হলে প্রশ্ন করুন — ভবিষ্যতে একসাথে বদলাতে হলে কেউ কি দুটোই মনে রেখে বদলাবে?
বড় শিক্ষা। কপি-পেস্ট শুরুতে সময় বাঁচায়, কিন্তু প্রতিটি কপি একটি "সিঙ্ক্রোনাইজেশন দায়" তৈরি করে — প্রতিটি পরিবর্তন সব কপিতে সমানভাবে প্রয়োগ না হলে সিস্টেম নিঃশব্দে অসামঞ্জস্যপূর্ণ হয়ে ওঠে।
৮. পর্যবেক্ষণযোগ্যতা (Observability): লগিং, হেলথ-চেক ও ডিপ্লয়মেন্ট প্রোভেন্যান্স
এটা কী। Observability মানে একটি সিস্টেমের ভেতরে কী ঘটছে তা বাইরে থেকে বোঝার ক্ষমতা — গাড়ির ড্যাশবোর্ডে ইঞ্জিন না খুলেই তাপমাত্রা/গতি দেখানোর মতো।
কেন সমস্যা তৈরি করে। এই সার্ভিস log4net দিয়ে একটি নামযুক্ত লগার তৈরি করে এবং log4stash অ্যাপেন্ডারের মাধ্যমে লগ Elasticsearch-এ (ELK স্ট্যাক) পাঠায় — কেন্দ্রীয় সার্চযোগ্য সিস্টেমে। একটি HealthCheck এন্ডপয়েন্টও আছে। Dockerfile-এ GIT_BRANCH/GIT_COMMIT_HASH বিল্ড-আর্গুমেন্ট হিসেবে কম্পাইল-টাইমে এম্বেড করা হয় — একটি রানিং কন্টেইনার দেখেই বলা যায় কোন গিট কমিট থেকে বিল্ড হয়েছে।
সাধারণ ভুল। লগিংকে "ডিবাগের সময় সাময়িক প্রিন্ট, পরে মুছে ফেলা" ভাবা — কেন্দ্রীয়ভাবে সার্চযোগ্য স্ট্রাকচার্ড লগিং হিসেবে নয়। ডিপ্লয়ড কোড কোন সংস্করণ তা ট্র্যাক না করা, ফলে "ফিক্স কি আদৌ প্রোডাকশনে গেছে?" প্রশ্নে ম্যানুয়াল অনুসন্ধান লাগা।
ভালো পদ্ধতি। লগ কেন্দ্রীভূত করা উচিত এমন সিস্টেমে যেখানে টাইম-রেঞ্জ/লেভেল/আইডেন্টিফায়ার দিয়ে সার্চ করা যায় — বিশেষ করে একাধিক সার্ভার-ইনস্ট্যান্স থাকলে। বিল্ডে গিট মেটাডেটা এম্বেড করা "কোন সংস্করণ কোথায় চলছে" প্রশ্নের উত্তর স্বয়ংক্রিয় করে।
আগেভাগে চেনার উপায়। প্রশ্ন করুন — একটি নির্দিষ্ট ব্যবহারকারীর একটি নির্দিষ্ট ব্যর্থ অনুরোধের পুরো যাত্রা লগ থেকে খুঁজে বের করা যাবে কি? না পারলে centralized logging ও correlation ID-এর অভাব আছে।
বড় শিক্ষা। সিস্টেম যত জটিল হয়, "এটা কেন ভেঙেছে" প্রশ্নের উত্তর কোড পড়ে বের করা তত কঠিন হয় — observability-তে বিনিয়োগ মানে ভবিষ্যতের ইনসিডেন্ট রেসপন্স সময়ে বিনিয়োগ।
৯. অভ্যন্তরীণ টুলের জন্য UI/UX: সঠিক জায়গায় সঠিক বিনিয়োগ
এটা কী। UI/UX বিনিয়োগের পরিমাণ শ্রোতার ওপর নির্ভর করা উচিত — গ্রাহক-মুখী অ্যাপ ও অভ্যন্তরীণ অপারেশনাল টুলের প্রয়োজন এক নয়।
কেন সমস্যা তৈরি করে। ReplicaReport ভিউতে টেবিল কলাম হার্ডকোড না করে C# reflection দিয়ে (typeof(...).GetProperties()) স্বয়ংক্রিয়ভাবে জেনারেট করা হয়েছে — DTO-তে নতুন ফিল্ড যোগ হলেই ভিউ-কোড পরিবর্তন ছাড়া টেবিলে দেখা যাবে। প্রোডাকশন গ্রাহক-মুখী UI-তে এই টেকনিক বিপজ্জনক (কলাম-অর্ডার/লেবেল নিয়ন্ত্রণ হারানো), কিন্তু একটি ডায়াগনস্টিক অ্যাডমিন রিপোর্টে বাস্তবসম্মত সিদ্ধান্ত।
সাধারণ ভুল। প্রতিটি স্ক্রিনে সমান পালিশ বিনিয়োগ করা, অথবা উল্টো — গ্রাহক-মুখী ফিচারেও "এটা তো একটা টেবিলই" ভেবে দ্রুত-ও-নোংরা reflection-ভিত্তিক UI বসিয়ে দেওয়া।
ভালো পদ্ধতি। সিদ্ধান্তের আগে প্রশ্ন করুন — কারা ব্যবহার করবে, কত ঘন ঘন, ভুল হলে ক্ষতি কত? একটি অভ্যন্তরীণ রিপোর্টিং টুলে জেনেরিক টেবিল সময় বাঁচায় ও যুক্তিসঙ্গত, যতক্ষণ সচেতনভাবে সেই প্রেক্ষাপটেই সীমাবদ্ধ থাকে।
আগেভাগে চেনার উপায়। কোনো reflection-ভিত্তিক বা জেনেরিক UI প্যাটার্ন ধীরে ধীরে গ্রাহক-মুখী স্ক্রিনে "ছড়িয়ে" পড়লে সেটা স্কোপ-ক্রিপ সংকেত।
বড় শিক্ষা। সব UI-কে একই মানদণ্ডে বিচার করা ভুল — কোথায় পালিশ প্রয়োজন আর কোথায় গতি/নমনীয়তা বেশি মূল্যবান তা সচেতনভাবে ঠিক করাই পরিপক্বতার লক্ষণ।
উপসংহার
একটি ছোট ফাইল-সিঙ্ক্রোনাইজেশন সার্ভিসও — ভালোভাবে পড়লে — ডিস্ট্রিবিউটেড সিস্টেম ডিজাইন, কনকারেন্সি, এরর হ্যান্ডলিং, কনফিগারেশন ম্যানেজমেন্ট, সিকিউরিটি, কোড কোয়ালিটি, অবজারভেবিলিটি, আর UI/UX-এর মতো বিষয়ে বাস্তব শিক্ষা দিতে পারে। এই নীতিগুলোর কোনোটাই একটি নির্দিষ্ট প্রজেক্টের জন্য নয় — যেকোনো ব্যাকএন্ড সার্ভিস, যেকোনো ভাষা/ফ্রেমওয়ার্কে প্রযোজ্য।
অতিরিক্ত বিষয় যা এখানে বিস্তারিত আলোচনা করা হয়নি কিন্তু একই কোডবেসে লক্ষণীয়: S3 ও Minio-এর জন্য একই AWS SDK ক্লায়েন্ট ভিন্ন কনফিগারেশন দিয়ে ব্যবহার করা (একটি অ্যাডাপ্টার-সদৃশ প্যাটার্ন), ফাইল রিনেমিং-এ কী-সংঘর্ষ এড়াতে টাইমস্ট্যাম্প-ভিত্তিক নামকরণ, আর HttpClientFactory-এর মাধ্যমে একাধিক নামযুক্ত HTTP ক্লায়েন্ট (ভিন্ন টাইমআউট নিয়ে) কনফিগার করার প্যাটার্ন।